原論文
Iterative Scale-Up ExpansionIoU and Deep Features Association for Multi-Object Tracking in Sports
- 発表先
- WACV Workshops 2024ワークショップ
- arXiv への初回投稿
- arXiv:2306.13074
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingdeepeiou2023,
  title = {{Iterative Scale-Up ExpansionIoU and Deep Features Association for Multi-Object Tracking in Sports}},
  author = {Hsiang-Wei Huang and Cheng-Yen Yang and Jiacheng Sun and Pyong-Kun Kim and Kwang-Ju Kim and Kyoungoh Lee and Chung-I Huang and Jenq-Neng Hwang},
  year = {2023},
  eprint = {2306.13074},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2306.13074}
}
SportsMOT の論文には、どうにも気になるアブレーションの表が一つある。同じ IoU による関連付けでも、先にカルマンフィルタで位置を予測する版は HOTA が 64.1 なのに、予測せずに軌跡の前のフレームのボックスでそのまま比べると、かえって 71.5 になる。
予測が足を引っ張るだけなら、なぜわざわざ予測するのか?
ワシントン大学の Jenq-Neng Hwang 研究室の Hsiang-Wei Huang、Cheng-Yen Yang、Jiacheng Sun は、韓国電子通信研究院(ETRI)と台湾の国家高速ネットワーク・計算センターの共同研究者とともに、Deep-EIoU を提案した。カルマンフィルタをまるごと外し、代わりに大きく広げたボックスで人を探し、さらに外観特徴で誰なのかを見分ける。
この手法は SportsMOT で HOTA 77.2 を出し、SportsMOT の論文で最も良かった手法を 3 ポイント上回った。
問題の定義
著者らは、スポーツの場面が追跡しにくい理由を三つ挙げている。
- 遮蔽がひどい。 試合ではぶつかり合いが激しく、選手はしょっちゅう団子になって互いを遮るので、歩行者追跡よりずっとひどい。
- 見た目が似ている。 同じチームの選手は同じ色のユニフォームを着ている。
- 動きが予測できない。 バスケットボールのレッグスルー、サッカーのスライディングタックル、バレーボールのスパイクでは、速さも向きも一瞬で変わる。
主流のトラッカーは、外観と運動を融合するものも運動だけに頼るものも、たいていカルマンフィルタで位置を予測する。カルマンフィルタは線形の運動とガウスノイズを仮定しているので、物体の動きがそれに合わなくなったとたん、予測がずれる。OC-SORT はカルマンフィルタを補修しようとした。C-BIoU は平均変位でそれを置き換え、さらにボックスを広げて推定の誤差を補った。
Deep-EIoU はさらに一歩進んで、運動の推定すらやめてしまった。
問題を解く
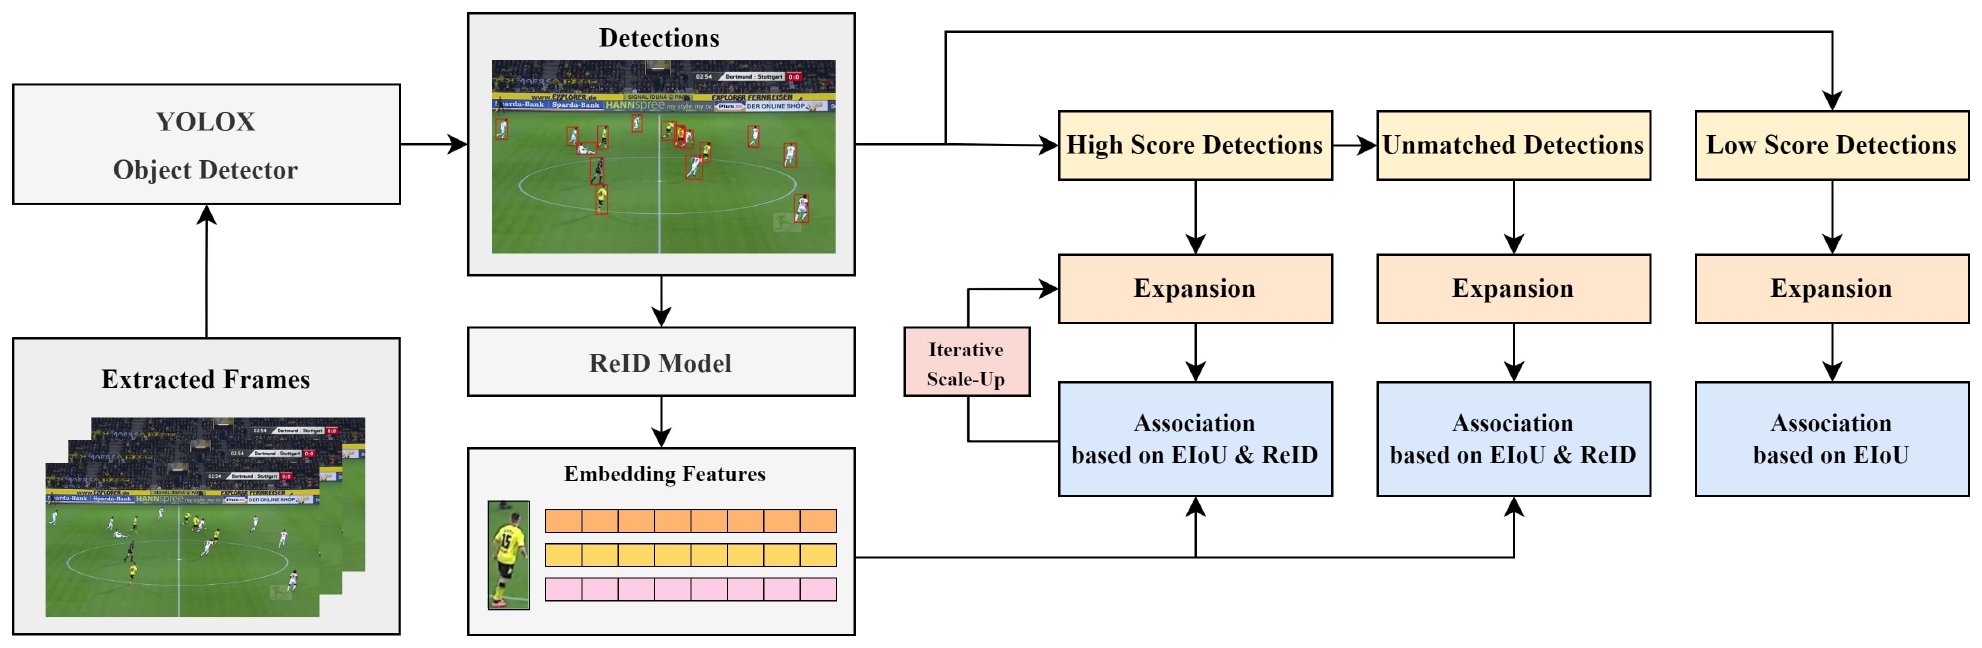
全体としては、あくまで検出してから関連付ける方式の構成で、過去と現在の情報しか使わないので、オンラインで実行できる。各フレームではまず YOLOX で選手を検出し、ReID モデルで各ボックスの外観特徴を抽出し、続いて軌跡と検出の間のコストを計算して、ハンガリアン法に渡してマッチングする。
一般的なトラッカーとの最大の違いは、軌跡が照合に使うボックスにある。Deep-EIoU は、軌跡がこのフレームでどこにいるかを予測せず、軌跡が最後に見えたときのボックスをそのまま新しい検出と比べる。
大きく広げたボックス
位置の部分には、拡張 IoU(ExpansionIoU、EIoU)を使う。著者らは、このアイデアは C-BIoU から来ていると説明しつつ、スポーツ選手の場合はボックスをもっと大きく広げたほうがよいことに気づいたという。
拡張は比率 で制御する。幅 、高さ のボックスの拡張長は次のとおりだ。
この長さを半分ずつに分けて、ボックスの両側に加える。左上の角を だけ外へ動かし、右下の角も同じだけ動かす。したがって拡張後のボックスの幅と高さは、どちらも元の 倍になる。公式のコードの書き方もこの定義と一致している。
デフォルトの では、ボックスの幅と高さは元の 3.4 倍、面積は 12 倍近くになる。C-BIoU の書き方に換算すると、緩衝比率 1.2 に相当する。C-BIoU が DanceTrack で最も良かった緩衝は 0.3 から 0.4 にすぎない。
C-BIoU のノートの例を引き継いで比べてみよう。幅 40、高さ 100 ピクセルの選手が次のフレームで右へ 50 ピクセル動き、元の IoU は 0 だ。
| 拡張後のボックス | 同じ人(50 px) | 隣の人(70 px) | 隣の人(100 px) | |
|---|---|---|---|---|
| C-BIoU() | 64 × 160 | 0.12 | 0 | 0 |
| Deep-EIoU() | 136 × 340 | 0.46 | 0.32 | 0.15 |
本稿で整理した計算例。二つのボックスは同じ大きさで、高さはそろっている。
ここまで広げれば、選手が一瞬で体の幅一つ分以上動いても、まだ見つけられる。代償も明らかで、左右に体の幅三つ分以内にいる人が、全員候補になってしまう。そうなると、外観で人を分けるしかない。
外観と位置をどう組み合わせるか
外観のコストは、軌跡と検出の特徴ベクトルのコサイン距離だ。
多くの手法は外観のコストと IoU のコストを重み付きで足し合わせるが、著者らはそうせず、BoT-SORT のやり方を採った。まず外観のコストを調整する。 または なら、調整後の外観のコストは 、そうでなければ とする。第一段階のコストは、両者のうち小さいほうをとる。
ここで 、 だ。
外観が役に立つには、両者の見た目が十分に似ていて、位置も十分に近い(EIoU が 0.5 以上)必要がある。どちらか一つでも満たさなければ外観のコストは 1 になり、外観を参考にしないのと同じだ。両方を満たすときは、外観のコストをさらに半分にする。最後に、外観と位置のコストのうち小さいほうをとる。
だから外観にできるのは、もともと近くにいる組み合わせを「より確かにする」ことだけで、遠く離れていて見た目が似ているだけの二人を無理やり組にすることはできない。同じチームの選手が同じユニフォームを着ている状況では、これが特に重要になる。
確かなものから先に
マッチングは ByteTrack の階層を引き継いでいる。信頼度スコアが 0.6 以上の高スコアの検出は、遮られていることが比較的少なく、外観特徴も比較的当てになるので、まず高スコアの検出を軌跡とマッチングする。使うのは、上で述べた外観と EIoU を組み合わせたコストだ。信頼度が 0.1 から 0.6 の間の低スコアの検出は、二回目に EIoU だけで残りの軌跡とマッチングする。0.1 より低いものはそのまま捨てる。
また、著者らは一般的なトラッカーがボックスにかける縦横比の制限を外した。選手は地面に倒れることがあり、たいてい立って歩いている歩行者とは違うからだ。見失った軌跡は 60 フレーム保持する。歩行者追跡でよく使われる 30 フレームより長いのは、競技場での遮蔽のほうがひどいからだ。
段階的に広げれば、調整はいらない
C-BIoU のアブレーションがすでに示しているように、緩衝比率は敏感なハイパーパラメータだ。著者らの指摘では、実際のスポーツ選手の追跡システムでこれを調整するのは難しい。システムはオンラインでリアルタイムに動かなければならず、あとから何度も実験するわけにはいかない。現実の場面ではテストデータの正解も手に入らないので、探しようがない。
そこで著者らは最適な を探すのではなく、高スコアの検出のマッチング段階で を小さい値から段階的に大きくしながら、マッチングを繰り返すことにした。
は 0 から始まる。一回目は を使い、重なりが最も大きく最も確かな組み合わせを先に確定させる。マッチしなかったものは、次の回で少し大きいボックスを使ってまた探す。デフォルトは 、刻み幅 で、全部で二回、つまり 0.7 と 0.8 だ。
議論
SportsMOT
検出器は YOLOX-X で、COCO の事前学習済みの重みから始め、SportsMOT の訓練セットと検証セットで 80 epoch ファインチューニングする。ReID モデルには OSNet を使い、人物再識別データセット Market-1501 の重みから始め、SportsMOT の正解ボックスから切り出した 31,279 枚の選手の画像でファインチューニングする。
| 手法 | 訓練データ | HOTA | AssA | DetA | IDF1 |
|---|---|---|---|---|---|
| BoT-SORT | 訓練セット | 68.7 | 55.9 | 84.4 | 70.0 |
| OC-SORT | 訓練セット | 71.9 | 59.8 | 86.4 | 72.2 |
| Deep-EIoU | 訓練セット | 74.1 | 63.1 | 87.2 | 75.0 |
| OC-SORT | 訓練+検証 | 73.7 | 61.5 | 88.5 | 74.0 |
| MixSort-OC | 訓練+検証 | 74.1 | 62.0 | 88.5 | 74.4 |
| Deep-EIoU | 訓練+検証 | 77.2 | 67.7 | 88.2 | 79.8 |
原論文 Table 2 をもとに整理。SportsMOT テストセット。BoT-SORT は公式コードで再実行し、ほかのベースラインの数字は SportsMOT の論文から引用。
同じ訓練データで比べると、Deep-EIoU はどちらの設定でも最も良い。訓練セットと検証セットを使う場合、HOTA は MixSort-OC より 3.1 ポイント、関連付けを測る AssA は 5.7 ポイント高い。検出を測る DetA はほぼ同じで、むしろわずかに低い。差はほぼすべて関連付けから来ている。
SoccerNet
SoccerNet-Tracking には 30 秒ずつのサッカーの動画が 201 本あり、追う対象は選手だけでなく、ゴールキーパー、審判、ボールも含む。追跡だけを比べるため、どの手法もデータセットが提供する正解ボックスをそのまま使う。
Deep-EIoU の HOTA は 85.4 で、二位の OC-SORT は 78.1、BoT-SORT は 77.0、ByteTrack と DeepSORT は 71.5 と 69.6 にとどまる。
部品ごとの貢献
| 設定 | HOTA |
|---|---|
| ベースライン(EIoU のみ) | 71.4 |
| +外観(ReID) | 75.3 |
| +段階的拡大 | 77.2 |
| +線形補間 | 77.2 |
原論文 Table 4 をもとに整理。SportsMOT テストセット。
- 最も貢献したのは外観で、3.9 ポイント。 同じチームの選手は見た目がよく似ているが、それでも外観は重要な手がかりだ。SportsMOT の論文の「似ているが見分けられる」という結論と一致する。
- 段階的な拡大でさらに 1.9 ポイント。 著者らの説明では、この段階では同時に、見失った軌跡の保持期間も 30 フレームから 60 フレームに延ばしているので、この 1.9 ポイントは両者を合わせた効果だ。
- 線形補間はほとんど影響がなく、0.1 ポイントも増えない。
EIoU だけで外観を使わないベースラインは 71.4 で、SportsMOT の論文の「カルマンを使わない IoU」の行(71.5)とかなり近い。二つの論文は検出器の訓練方法が違うので、大まかにしか比べられない。この数字から見る限り、ボックスを広げるだけでは、予測しない IoU よりたいして良くはならない。Deep-EIoU が上乗せしたスコアは、主に外観と段階的な拡大から来ている。
拡張比率は本当に調整しなくていいのか
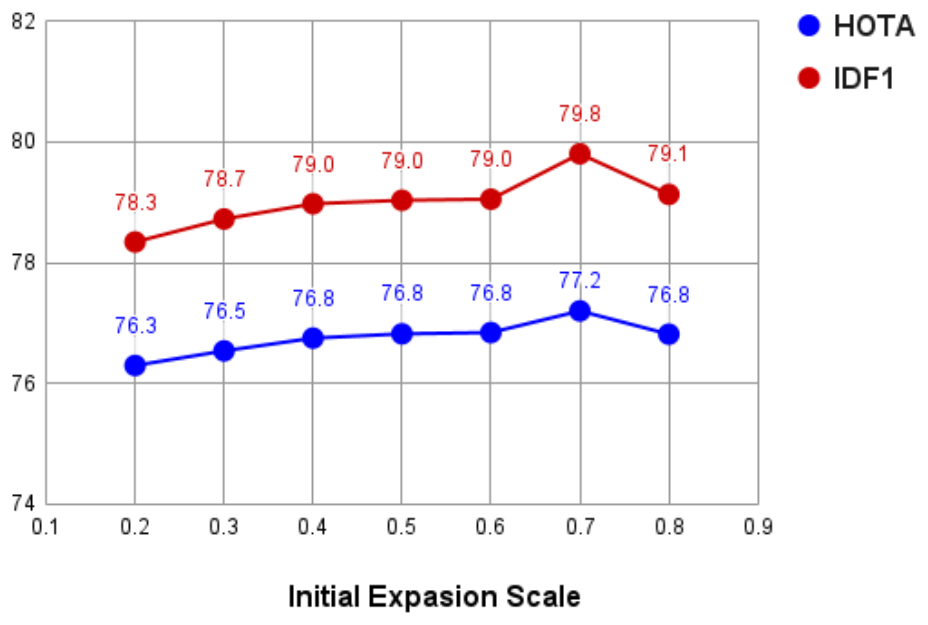
著者らは、ほかの設定を変えずに初期拡張比率を 0.2 から 0.8 まで変えた。HOTA はどれも 76.3 から 77.2 の間にあり、すべてそれまでの最高の 74.1 を上回る。著者らはこれをもとに、段階的な拡大のおかげでこの手法はパラメータ調整が要らないと考えている。
この図は別の角度から読むこともできる。初期比率が 0.2 のとき、二回の拡張は 0.2 と 0.3 で、ボックスの幅と高さは 2.4 から 2.6 倍になる。0.7 にすると 3.4 から 3.6 倍になるが、HOTA は 0.9 ポイントしか増えない。この範囲では、どれだけ広げるかは実はたいして効いていない。
ただし、図で最も小さい拡張でも 2.4 倍あり、すでに C-BIoU の設定より大きい。著者らは「C-BIoU より大きく広げたほうが明らかに良い」と言うが、この図はそれを直接比べてはいない。アブレーションの表から見る限り、Deep-EIoU が差をつけた本当の理由は、やはり外観と段階的な拡大だ。
EIoU はカルマンフィルタも助ける
最後に、著者らは EIoU をカルマンフィルタに基づく二つのトラッカーにそのまま組み込み、予測ボックスと検出ボックスをどちらも拡張してから IoU を計算した。ByteTrack の HOTA は 62.8 から 67.5 に、BoT-SORT は 68.7 から 71.3 に上がった。
つまり EIoU は予測しないトラッカーだけのものではなく、プラグアンドプレイの小技としても使える。ただ、EIoU を加えても、この二つのカルマン系トラッカーは、何も予測しない Deep-EIoU にやはり負ける。
限界
著者らは論文で二つの限界を挙げている。
- オフラインでの軌跡の修正がない。 選手が画面から出てまた戻ってくると、オンラインのトラッカーでは同じ人だと認識し直すのが難しい。著者らは後処理やより強力な記憶の仕組みを加えられると述べているが、この論文ではやっていない。
- 速度。 検出器と ReID モデルを含めると、パイプライン全体は RTX 4080 一枚で毎秒約 14.6 フレームで、運動だけを見るトラッカーより遅い。より軽量な検出器と ReID モデルに替えれば速くできる。
結論
Deep-EIoU は、スポーツの場面で大胆な選択をした。選手が次のフレームでどこにいるかを予測せず、最後に見えた位置だけを使い、ボックスを 3.4 倍に広げて人を探し、広げたことでなだれ込んできた候補を外観でふるい落とす。外観にできるのはすでに十分近い組み合わせをより確かにすることだけで、遠くにいる似た人を引き寄せることはできない。拡張比率は小さいほうから二回試すことで、パラメータ調整の手間を省いた。
アブレーションによれば、三つの設計のうち最も貢献が大きいのは外観で、次が段階的な拡大だ。EIoU だけのベースラインは、SportsMOT の論文の予測しない IoU とそれほど変わらない。
2025 年のある複数物体追跡のサーベイは、Deep-EIoU を C-BIoU の一般化、つまり固定の二段階の拡張を段階的な拡大に変えたものとして紹介し、SportsMOT の比較表では二位に置いている。上にいるのはサーベイの著者ら自身の手法だけだ。サーベイは、Deep-EIoU が SportsMOT と SoccerNet でしか評価されていないことにも注意を促している。
論文自身が認めた一つ目の限界、画面から出て戻ってきた選手を見分けられないという問題には、同じ研究室が一年余りのちに GTA で答えた。