Article original
STORM: End-to-End Referring Multi-Object Tracking in Videos
- Publication
- CVPR Findings 2026Conférence
- Premier dépôt sur arXiv
- arXiv:2604.10527
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingstorm2026,
  title = {{STORM: End-to-End Referring Multi-Object Tracking in Videos}},
  author = {Zijia Lu and Jingru Yi and Jue Wang and Yuxiao Chen and Junwen Chen and Xinyu Li and Davide Modolo},
  year = {2026},
  eprint = {2604.10527},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2604.10527}
}
Le suivi multi-objets ordinaire suit toutes les personnes de l'image, ou toutes les voitures. En pratique, on ne s'intéresse souvent qu'à quelques-unes d'entre elles : « la personne aux lunettes de soleil qui tient un ordinateur portable », « les deux enfants à gauche », « le skieur et les skis sous ses pieds ».
Désigner par une phrase ce qu'il faut suivre, c'est la tâche appelée referring multi-object tracking (RMOT). Le modèle doit d'abord comprendre la description, trouver les objets qui y correspondent, puis les suivre jusqu'au bout, ce qui ajoute une couche au suivi ordinaire.
Zijia Lu, Davide Modolo et leurs collègues d'Amazon estiment que comprendre une description est justement le point fort des grands modèles de langage. Ils ont conçu STORM, un grand modèle de langage multimodal qui lit une vidéo et une phrase de description, et écrit directement, en texte, la boîte de chaque objet dans chaque image.
Définir le problème
Des approches faites de pièces rapportées
Les méthodes RMOT antérieures ajoutent pour la plupart un encodeur de texte à un détecteur spécialisé, qui filtre ses détections selon la description. Cette approche sait traiter « la voiture rouge », mais pas une description qui fait intervenir des relations, comme « les deux interprètes à droite du tableau ».
Les méthodes de localisation fondées sur des grands modèles de langage multimodaux comprennent un langage complexe, mais ne traitent pour la plupart que des images isolées. Pour la vidéo, il faut leur adjoindre un traqueur ou un détecteur ; le modèle de langage se contente de comprendre le texte et ne participe pas directement à la question « où est passée cette boîte à l'image suivante ». Les auteurs relèvent qu'à ce jour, aucune méthode ne traite le RMOT de bout en bout.
Des données rares et désordonnées
Le plus gros problème, ce sont les données. Les grands modèles de langage multimodaux ont besoin de grandes quantités de données d'entraînement de qualité, mais l'annotation RMOT coûte extrêmement cher ; il faut des boîtes à chaque image, et ces boîtes doivent correspondre à une description précise.
Les jeux de données existants ont chacun leurs défauts. Refer-KITTI ne contient que des scènes de circulation et deux catégories ; les descriptions de LaSOT manquent souvent de précision, une vidéo pouvant contenir plusieurs animaux de la même espèce sans que la description dise lequel ; Elysium est grand, mais beaucoup de boîtes ne correspondent pas à leur description ; LaMOT est petit, et beaucoup de ses descriptions se réduisent à un nom de catégorie.
Résoudre le problème
Écrire toutes les boîtes en texte
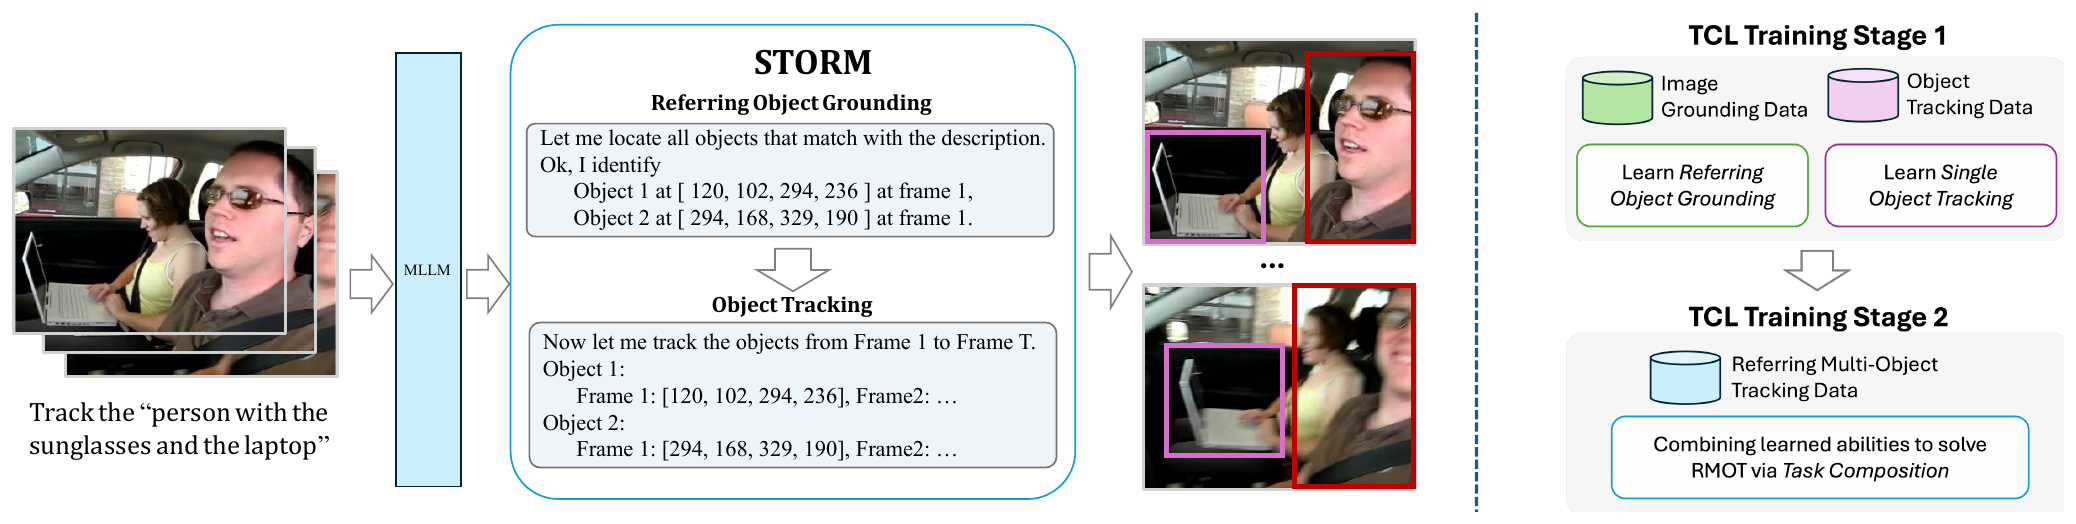
L'architecture de STORM est une conception classique à la LLaVA ; l'encodeur visuel transforme chaque image en tokens visuels, qu'un MLP à deux couches projette dans l'espace du texte, et qui entrent avec la description dans un modèle de langage de 8 milliards de paramètres. L'encodeur visuel est un NaViT, capable de traiter n'importe quelle résolution et n'importe quel rapport largeur/hauteur sans réduire de force l'image à une taille fixe, ce qui avantage les tâches qui demandent une localisation précise.
La sortie du modèle est simplement un texte, au format « Object 1: Frame 1: [x1, y1, x2, y2], Frame 2: …; Object 2: … », un passage par objet, qui écrit dans l'ordre sa boîte dans chaque image. Les coordonnées sont des positions absolues en pixels dans l'image. Quand un objet est temporairement caché ou sort du champ, le modèle écrit une boîte vide. L'entraînement est une prédiction ordinaire du token suivant, avec une perte d'entropie croisée. Tout le processus se passe de détecteur, de traqueur et d'algorithme hongrois ; la cohérence des identités est assurée par le modèle de langage lui-même, et les boîtes écrites sous « Object 1 » appartiennent au même objet.
Quand la vidéo est trop longue, on la découpe en plusieurs segments ; les dernières boîtes prédites pour un segment servent de prompt au segment suivant, ce qui raccorde les trajectoires.
Apprendre la tâche par morceaux
Faute de données RMOT suffisantes, les auteurs décomposent la tâche en deux sous-tâches riches en données : la localisation guidée par une description et le suivi.
- Première étape. De grandes quantités de données de localisation dans l'image apprennent au modèle à trouver un objet dans une image isolée d'après une description ; des données de suivi d'un seul objet lui apprennent à suivre un objet image après image ; un peu de données de suivi d'un seul objet par expression référentielle relient les deux capacités.
- Seconde étape. Affinage sur STORM-Bench, construit par les auteurs. À l'entraînement, le modèle écrit d'abord son raisonnement ; il trouve dans la première image tous les objets décrits, puis les suit l'un après l'autre. C'est une façon d'enseigner explicitement au modèle l'ordre des deux sous-tâches.
Les auteurs appellent cette approche task-composition learning (TCL).
Un jeu de données construit de bas en haut
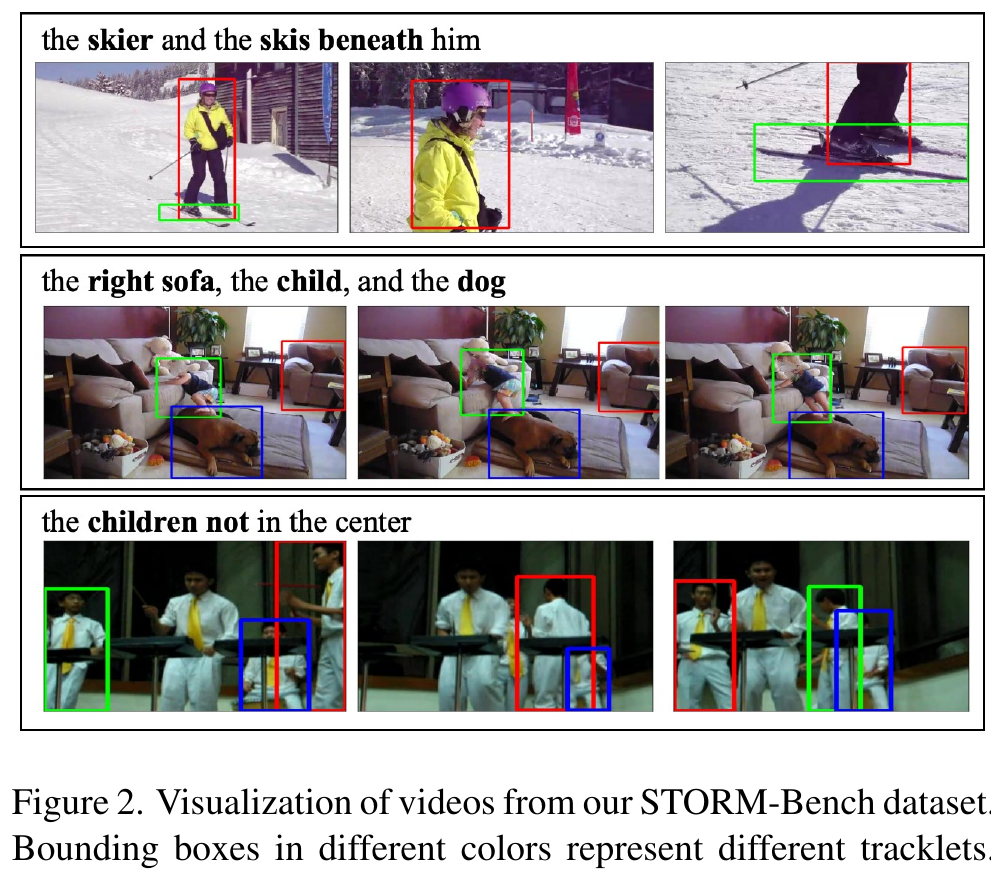
Les grands jeux de données antérieurs sont le plus souvent produits de haut en bas ; on écrit d'abord une description de toute la vidéo, puis Grounding-DINO repère les noms de la description, et un traqueur enchaîne les boîtes. Chaque étape dépend d'un modèle expert, et la moindre erreur à n'importe quelle étape reste dans les données.
STORM-Bench procède à l'inverse. Les auteurs exploitent une asymétrie : trouver un objet d'après une description est difficile, alors qu'écrire la description d'un objet donné est relativement facile. Les données sont construites sur VidOR, un jeu de données qui fournit déjà des boîtes de vérité terrain pour des objets du quotidien.
- Écrire une description pour chaque objet. L'objet cible est entouré d'une boîte rouge dans la vidéo, et l'on demande à Qwen2.5-VL de le décrire. Un autre modèle vérifie ensuite que la description ne correspond qu'à cet objet, avec trois entrées différentes : la vidéo d'origine avec la boîte rouge, l'extérieur de la boîte flouté, et l'objet seul recadré. Seules les descriptions qui passent les trois vérifications sont gardées.
- Composer des descriptions multi-objets. Les descriptions de tous les objets de la vidéo sont confiées à un modèle de langage doué pour le raisonnement, qui, pour quelques objets tirés au hasard, trouve des attributs communs ou distinctifs et en tire une phrase de description, comme « les instruments sur l'étagère » ou « la fille et le chat qui court derrière elle ». Un modèle multimodal vérifie encore une fois la description en la confrontant à la vidéo et aux boîtes.
On obtient au final 15 000 vidéos d'entraînement et 714 vidéos de test, avec 200 000 descriptions et 73 700 trajectoires d'objets couvrant 80 catégories. Chaque description désigne en moyenne 3 objets et compte en moyenne 12.2 mots anglais, bien plus que les 3.8 de LaMOT et les 2.1 d'Elysium.
Discussion
Suivi multi-objets par expression référentielle
| Méthode | HOTA | AssA | IDF1 | Chang. ID |
|---|---|---|---|---|
| Grounding DINO + OC-SORT | 31.7 | 56.5 | 27.3 | 2 953 |
| Qwen2.5-VL + OC-SORT | 37.9 | 62.6 | 38.6 | 2 767 |
| VisionLLMv2 + OC-SORT | 45.3 | 58.9 | 44.6 | 12 097 |
| LaMOT | 46.7 | 56.1 | 48.8 | 7 972 |
| STORM (STORM-Bench seul) | 34.8 | 56.8 | 36.4 | 2 832 |
| STORM | 66.7 | 82.6 | 78.3 | 183 |
D'après la Table 4 de l'article, ensemble de test de STORM-Bench.
Faute de méthode de bout en bout à laquelle se comparer directement, les auteurs font produire des boîtes par plusieurs modèles capables de localiser image par image, puis les enchaînent en trajectoires avec OC-SORT ; LaMOT utilise ses poids officiels, affinés ensuite sur STORM-Bench.
STORM obtient un HOTA de 66.7, 20 points de plus que LaMOT, le meilleur des autres ; il n'a que 183 changements d'identité, contre 7 972 pour LaMOT. La comparaison n'est pas tout à fait équitable ; STORM-Bench est le jeu de données des auteurs, et son annotation a la même origine que les données d'entraînement de STORM. Mais des changements d'identité plus de quarante fois moins nombreux s'expliquent difficilement par ce seul biais. Les méthodes qui localisent image par image puis enchaînent peuvent se tromper de personne à chaque image ; STORM écrit toute la trajectoire sous un même « Object 1 », et les identités ont peu de raisons de s'échanger.
Dans le même tableau, STORM entraîné sur le seul STORM-Bench n'obtient que 34.8 de HOTA, moins que Qwen2.5-VL avec OC-SORT ; avec le préentraînement de la première étape en localisation et en suivi, il bondit à 66.7. L'architecture ne suffit pas ; c'est l'entraînement par morceaux qui fait la différence.
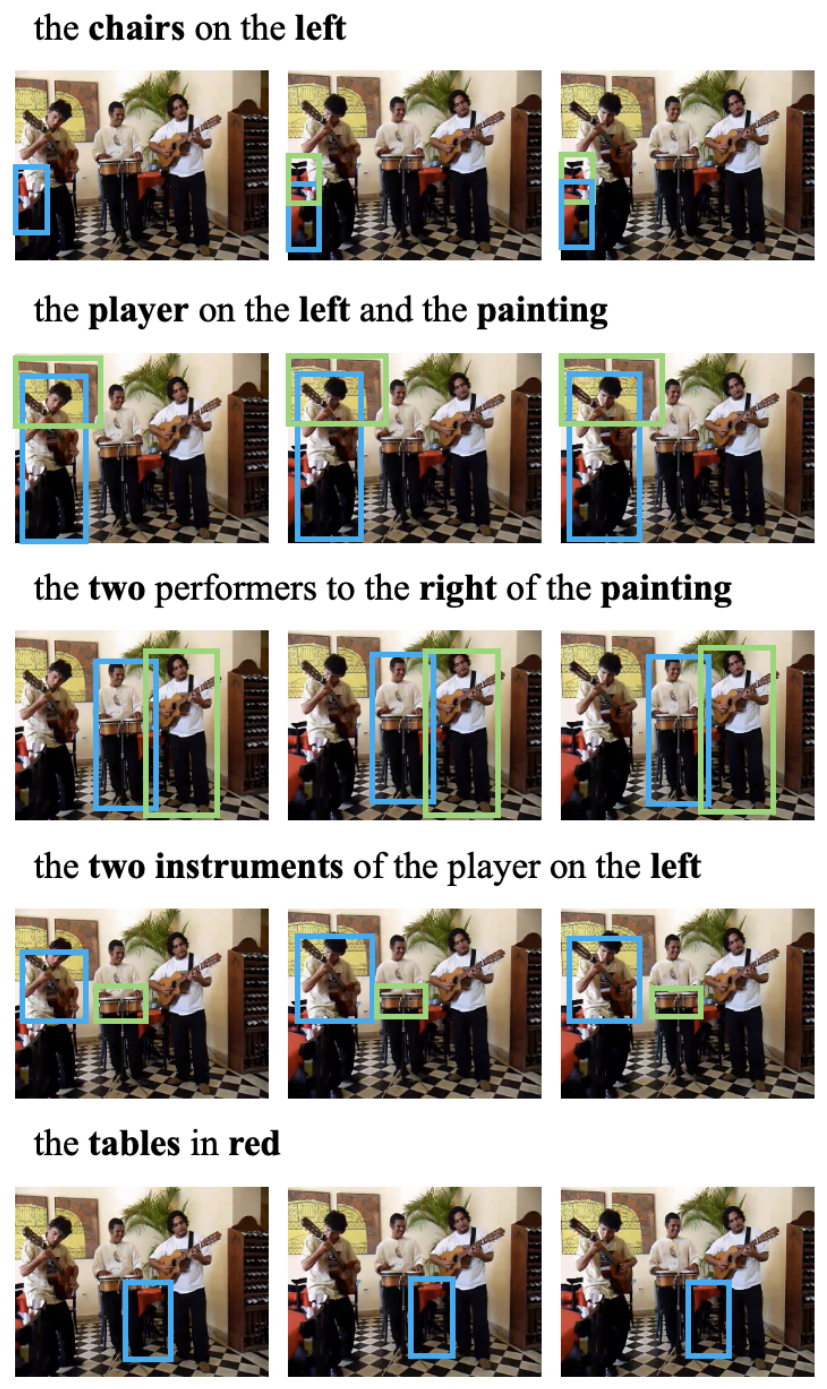
Cette figure montre la souplesse des descriptions. Sur la même vidéo, avec le même modèle, une description peut désigner la position d'objets (les chaises de gauche), une relation entre objets (les deux interprètes à droite du tableau), une appartenance (les deux instruments du musicien de gauche), ou mêler des catégories différentes (le musicien et le tableau).
L'effet de l'apprentissage par morceaux
| Localisation | Suivi mono-objet | Suivi mono-objet réf. | Score |
|---|---|---|---|
| 1 M | 0 | 100 k | 77.4 |
| 1 M | 0 | 1 M | 84.1 |
| 1 M | 900 k | 100 k | 83.0 |
D'après la Table 5 de l'article ; les quantités sont des nombres d'exemples d'entraînement, et le score est le résultat de test en suivi d'un seul objet par expression référentielle.
Les données de suivi d'un seul objet par expression référentielle coûtent plus cher à annoter que celles du suivi d'un seul objet ordinaire. Ce tableau montre que 900 000 exemples de suivi ordinaire, accompagnés de 100 000 exemples référentiels, donnent un score proche de celui obtenu avec 1 million d'exemples référentiels. Des données bon marché sur les sous-tâches peuvent remplacer des données coûteuses sur la tâche complète.
La quantité de données RMOT elle-même a aussi été testée : 5 000 exemples donnent un HOTA de 26.4, 10 000 donnent 53.4, 12 000 donnent 63.3, et 15 000 donnent 66.7. La progression ralentit à partir d'environ 12 000, et les auteurs ont donc arrêté le jeu de données à 15 000.
Localisation dans l'image et suivi d'un seul objet
Bien que conçu pour la vidéo, STORM reste compétitif en localisation dans l'image. Sur l'ensemble de validation et testA de RefCOCO, testA de RefCOCO+ et l'ensemble de test de RefCOCOg, il est le meilleur du tableau ; sur les autres colonnes, d'autres modèles sont légèrement devant, par exemple sur testB de RefCOCO, où MiniGPT-v2 obtient 85.3 et STORM 83.8.
Sur Elysium, en suivi d'un seul objet, avec la boîte de la première image fournie, STORM obtient une AUC de 89.8, contre 88.7 pour Elysium ; avec une brève description pour désigner la cible, c'est 84.1 contre 83.3. Quand les auteurs réécrivent les descriptions de façon plus longue et plus précise, les AUC des deux sont presque identiques (87.4 contre 87.5), et la précision de STORM est légèrement supérieure.
Vitesse
Écrire les coordonnées une à une en texte se paie en vitesse. D'après l'annexe, quand on ne suit qu'un seul objet, la vitesse tourne autour de 3.3 images par seconde, que la vidéo fasse 32 ou 256 images. Mais dès que les cibles se multiplient, ça ralentit :
| Cibles | Boîtes à écrire | Temps | Par boîte |
|---|---|---|---|
| 1 | 64 | 19.7 s | 0.31 s |
| 8 | 512 | 143.3 s | 0.28 s |
Temps d'après la Table 7 de l'annexe de l'article (vidéo de 64 images) ; temps par boîte calculé pour cette note.
Le temps est presque proportionnel au nombre de boîtes à écrire, environ 0.3 seconde par boîte. Avec 8 cibles, une vidéo de 64 images prend plus de deux minutes, soit moins d'une demi-image par seconde.
Les auteurs mentionnent aussi en annexe que pour des vidéos très longues, ou au-delà de dix cibles, la séquence de texte en sortie devient trop longue et le modèle peine davantage. Les erreurs restantes portent surtout sur la localisation ; quand la description est très vague ou la scène très encombrée, les boîtes manquent de précision.
Conclusion
STORM confie l'intégralité du suivi multi-objets par expression référentielle à un grand modèle de langage multimodal ; il lit la vidéo, lit la description, et écrit en texte la boîte de chaque objet dans chaque image. Les identités sont maintenues par la structure de la sortie, et les changements d'identité sont étonnamment rares.
Ce qui le fait vraiment fonctionner, c'est la manière de l'entraîner. Les données de la tâche complète étant trop rares, on apprend d'abord séparément les deux capacités avec de grandes quantités de données de localisation dans l'image et de suivi d'un seul objet, puis on les relie avec un peu de données complètes. STORM-Bench, construit par les auteurs, part de l'objet pour écrire ensuite la description, et évite ainsi les erreurs qui s'accumulent d'étape en étape dans une annotation de haut en bas.
Seulement, chaque boîte doit être écrite en texte, une à une ; plus il y a de choses à suivre, plus l'écriture est longue.