Article original
Visual Instruction Tuning
- Publication
- NeurIPS 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2304.08485
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multimodalityllava2023,
  title = {{Visual Instruction Tuning}},
  author = {Haotian Liu and Chunyuan Li and Qingyang Wu and Yong Jae Lee},
  year = {2023},
  eprint = {2304.08485},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2304.08485}
}
Le rapport technique de GPT-4, publié par OpenAI en mars 2023, contient quelques exemples de réponses à partir d'images. Sur l'une des photos, un homme repasse du linge debout derrière un taxi ; à la question « Qu'est-ce qui est inhabituel dans cette image ? », GPT-4 répond très justement. Mais la lecture d'images n'était pas ouverte au public à l'époque, et l'on ne pouvait que regarder les captures d'écran du rapport.
Côté open source, LLaMA venait tout juste d'être publié, et Alpaca et Vicuna avaient fine-tuné LLaMA sur des données d'instructions générées par machine pour obtenir des modèles conversationnels plutôt réussis. Tout cela ne concernait que le texte.
Un mois plus tard, Liu, Li et leurs collègues de l'Université du Wisconsin, de Microsoft Research et de l'Université Columbia publient LLaVA (Large Language and Vision Assistant), qui transpose l'instruction tuning au multimodal image-texte. Le plus intéressant dans cet article, ce sont les données ; les auteurs demandent à GPT-4 de produire des données d'entraînement de « conversations sur des images », alors que le GPT-4 qu'ils utilisent ne voit pas les images, puisqu'il s'agit de la version texte seul.
Définir le problème
Jusque-là, les modèles de vision suivaient le plus souvent la règle « une tâche, un modèle ». Classification, détection, segmentation, légendage d'images, chacun était entraîné séparément ; le langage ne servait qu'à décrire le contenu des images, et les instructions que l'utilisateur pouvait donner restaient très limitées.
De l'autre côté, des modèles image-texte comme Flamingo ou BLIP-2 savaient déjà brancher l'image sur un grand modèle de langage, avec de bons résultats en légendage et en questions-réponses visuelles. Mais ils étaient entraînés sur d'énormes quantités de paires image-texte, sans entraînement spécifique à « répondre selon les instructions de l'utilisateur » ; à la question « Qu'est-ce qui est inhabituel dans cette image ? », ils se contentaient le plus souvent de décrire l'image.
Pour apprendre au modèle à regarder une image en suivant des instructions, il faut des données du type « image + instruction + réponse ». Les paires image-texte abondent sur le web, de CC à LAION, mais les données d'instructions image-texte sont presque inexistantes ; les faire écrire par des humains prend beaucoup de temps, et personne ne sait trop quelle forme elles devraient prendre.
Résoudre le problème
Faire poser les questions par un GPT-4 qui ne voit pas les images
Le plus simple consiste à réécrire directement les paires image-texte au format instruction. L'image est associée à sa légende , et l'on tire au hasard une question du genre « Décris brièvement cette image » :
Human : X_q X_v <STOP>
Assistant : X_c <STOP>
C'est très bon marché, mais questions et réponses sont monotones, sans le moindre raisonnement.
Les auteurs prennent plutôt comme professeur un GPT-4 (ou ChatGPT) qui n'accepte que du texte. Puisqu'il ne voit pas l'image, on la lui traduit en texte, sous deux formes symboliques :
- Légendes : chaque image de COCO a plusieurs phrases de description écrites par des humains, qui décrivent la scène sous différents angles.
- Boîtes englobantes : la catégorie et la position de chaque objet, avec des coordonnées normalisées entre 0 et 1.
L'exemple de l'article est une photo de parking souterrain :
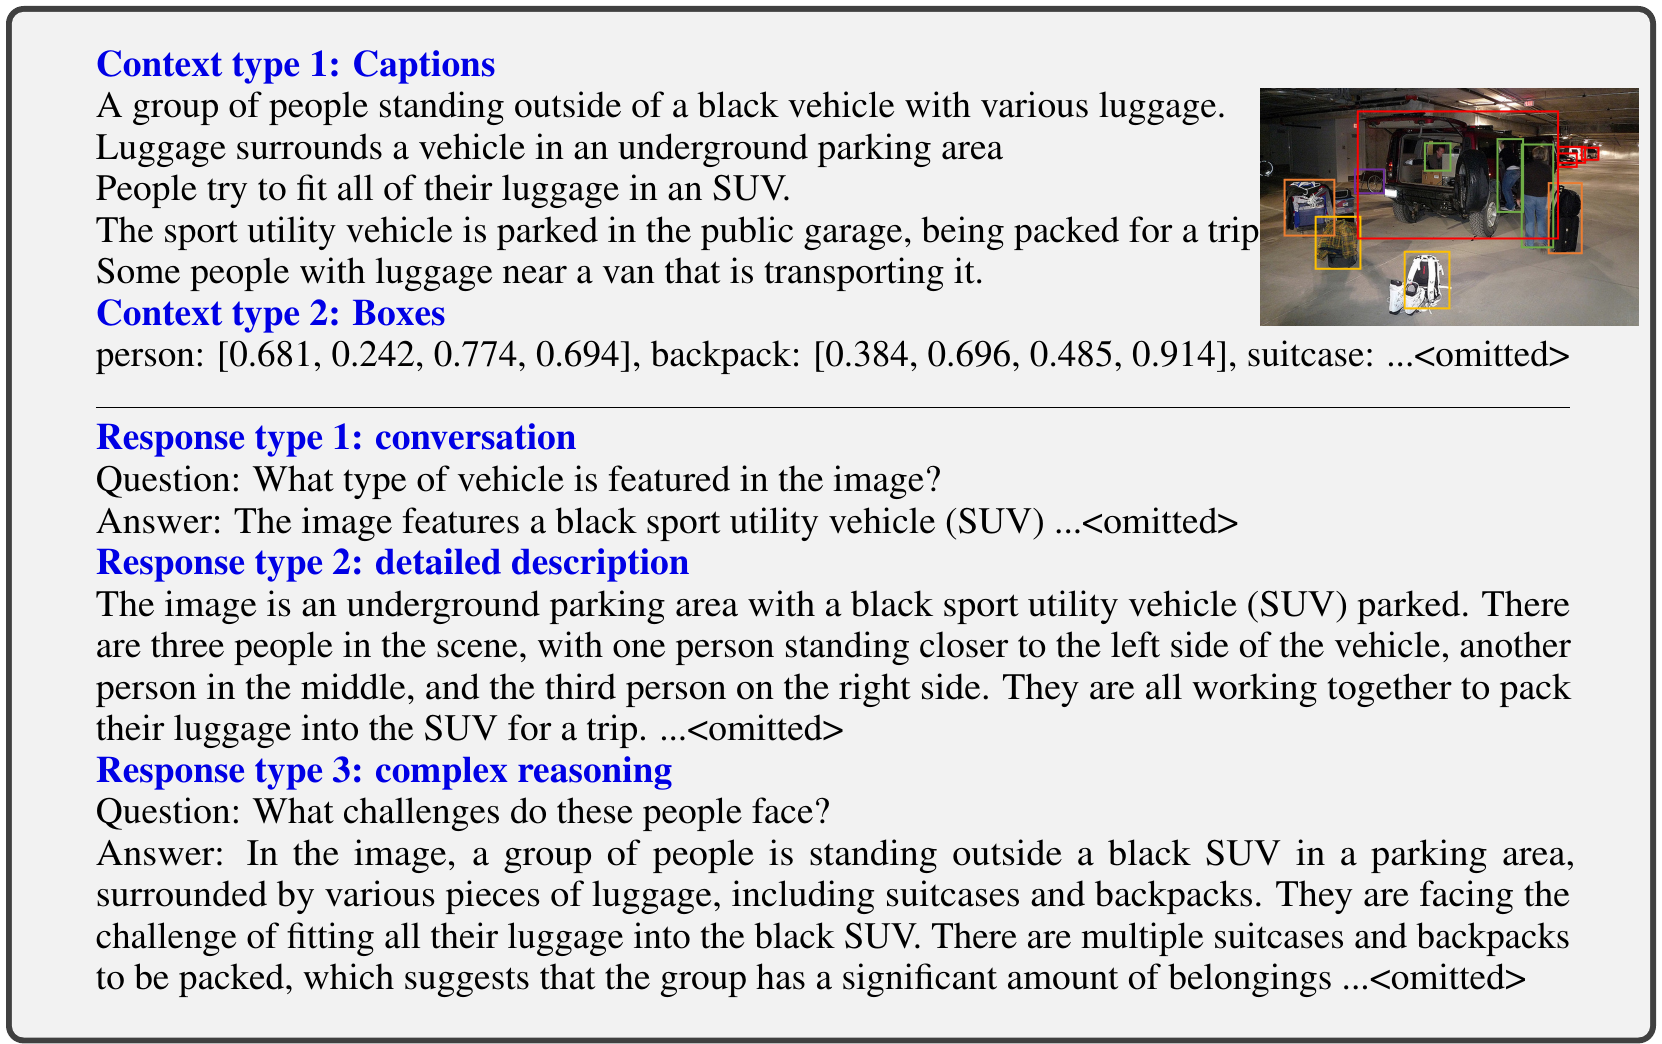
La partie supérieure est l'intégralité de ce que reçoit GPT-4, cinq légendes et une série de boîtes englobantes. La photo en haut à droite est là pour le lecteur de l'article ; GPT-4 lui-même ne la voit pas. La partie inférieure montre les trois types de réponses qu'il a écrits à partir de ces textes.
On lui demande ensuite de produire trois types de données :
- Conversation : un échange simulé où l'utilisateur pose les questions et l'assistant répond, sur le ton d'un assistant qui regarde vraiment l'image. Les questions portent sur les types d'objets, leur nombre, les actions, les positions et les positions relatives, et uniquement sur des points qui ont une réponse claire. Par exemple « Quel est ce véhicule sur l'image ? », « Un véhicule utilitaire sport (SUV) noir… ».
- Description détaillée : on tire au hasard une question dans une liste préparée à l'avance, par exemple « Décris cette image en détail », et on lui demande une description complète, par exemple « C'est un parking souterrain, où est garé un SUV noir. On voit trois personnes sur l'image… Ils sont en train de charger ensemble leurs bagages dans le SUV avant de partir. »
- Raisonnement complexe : des questions qui demandent un raisonnement par étapes, par exemple « Quelle difficulté ces personnes rencontrent-elles ? », avec pour réponse « Il y a autour d'eux plusieurs valises et sacs à dos, et les faire tous entrer dans ce SUV n'est pas simple… ».
Pour chaque type, les auteurs rédigent d'abord à la main quelques exemples, qui servent de prompt few-shot à GPT-4 ; c'est la seule annotation humaine de toute la collecte de données. On obtient au final 158K exemples : 58K conversations, 23K descriptions détaillées et 77K raisonnements complexes. Lors de premières expériences, les auteurs ont comparé ChatGPT et GPT-4 ; les données de GPT-4 étaient toujours meilleures, surtout pour le raisonnement spatial.
Le professeur ne voit pas l'image et n'en a lu que la description textuelle, alors que l'élève doit réellement regarder l'image pour répondre. On y reviendra plus loin.
Architecture : une seule projection linéaire
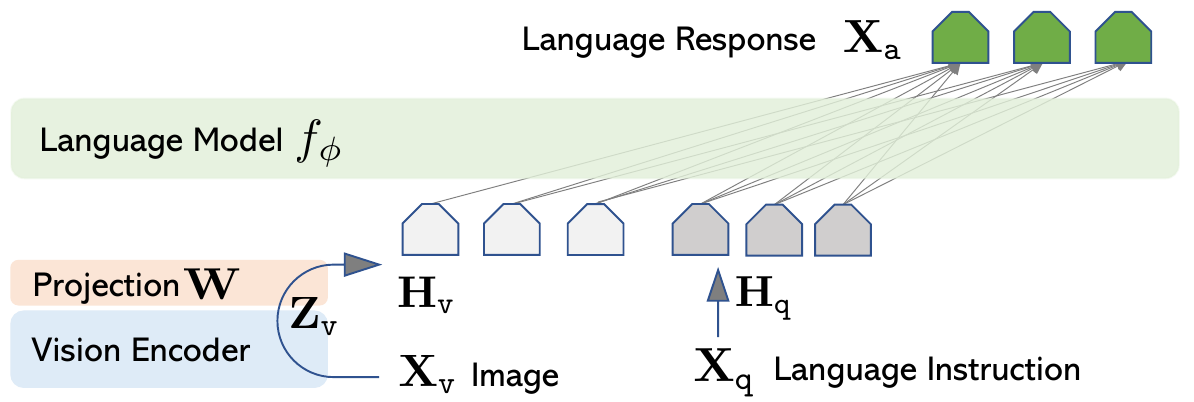
L'architecture est très simple, avec trois composants :
- Encodeur visuel : un CLIP ViT-L/14 préentraîné, qui découpe l'image en petits patchs et produit un vecteur de caractéristiques par patch. Les auteurs utilisent les caractéristiques de la couche qui précède la dernière couche Transformer.
- Matrice de projection : une seule couche linéaire, qui ramène chaque caractéristique d'image à la même dimension que les embeddings de mots du modèle de langage, .
- Modèle de langage : Vicuna, un modèle conversationnel obtenu en fine-tunant LLaMA sur des conversations avec ChatGPT partagées par des utilisateurs sur ShareGPT. Les auteurs l'ont choisi parce que c'était, parmi les modèles à poids publics de l'époque, celui qui suivait le mieux les instructions.
Après la projection, les caractéristiques d'image ont la même forme que les embeddings de mots du texte, et l'on peut les concaténer directement avant de les envoyer au modèle de langage. Pour une image de 224×224, CLIP ViT-L/14 découpe un patch tous les 14×14 pixels et produit 256 caractéristiques de 1024 dimensions ; la matrice de projection les transforme en 256 tokens visuels de 5120 dimensions, soit environ 5.25 millions de paramètres avec le biais. Ces 256 tokens sont placés devant les tokens du texte de l'instruction. Pour le modèle de langage, ils ne sont qu'une suite de « mots » au sens un peu particulier.
Le seul lien entre les deux côtés est cette couche linéaire de 5.25 millions de paramètres. Les auteurs signalent qu'on pourrait utiliser des connexions plus sophistiquées, comme l'attention croisée à portes de Flamingo ou le Q-Former de BLIP-2, mais une simple projection leur permet d'expérimenter rapidement sur les données, et ils s'en contentent pour commencer.
Entraînement : deux phases
Les conversations à plusieurs tours sur une même image forment une seule séquence. Au premier tour, on décide au hasard si l'image se place avant ou après la question ; les tours suivants ne contiennent que la question. La perte ne porte que sur les réponses de l'assistant, y compris le <STOP> qui marque où s'arrêter (en pratique ###).
Phase 1, aligner les caractéristiques. On filtre 595 000 paires image-texte issues de CC3M, transformées en conversations d'un seul tour par la réécriture simple décrite plus haut. L'encodeur visuel et le modèle de langage sont gelés ; seule la matrice de projection est entraînée. Selon les auteurs, cette étape revient à entraîner un « tokeniseur visuel » compatible avec le modèle de langage gelé. Une époque sur 8 A100, bouclée en moins de 4 heures.
Phase 2, fine-tuning de bout en bout. L'encodeur visuel reste gelé ; la couche de projection et le modèle de langage sont entraînés ensemble. La version conversationnelle est entraînée 3 époques sur les 158K exemples d'instructions présentés plus haut, en 10 heures environ ; les auteurs entraînent aussi une version ScienceQA, où la question et le contexte servent d'instruction, et le raisonnement suivi de la réponse sert de réponse.
Discussion
L'homme qui repasse
Les auteurs commencent par l'image du rapport de GPT-4, avec la question « Qu'est-ce qui est inhabituel dans cette image ? ».
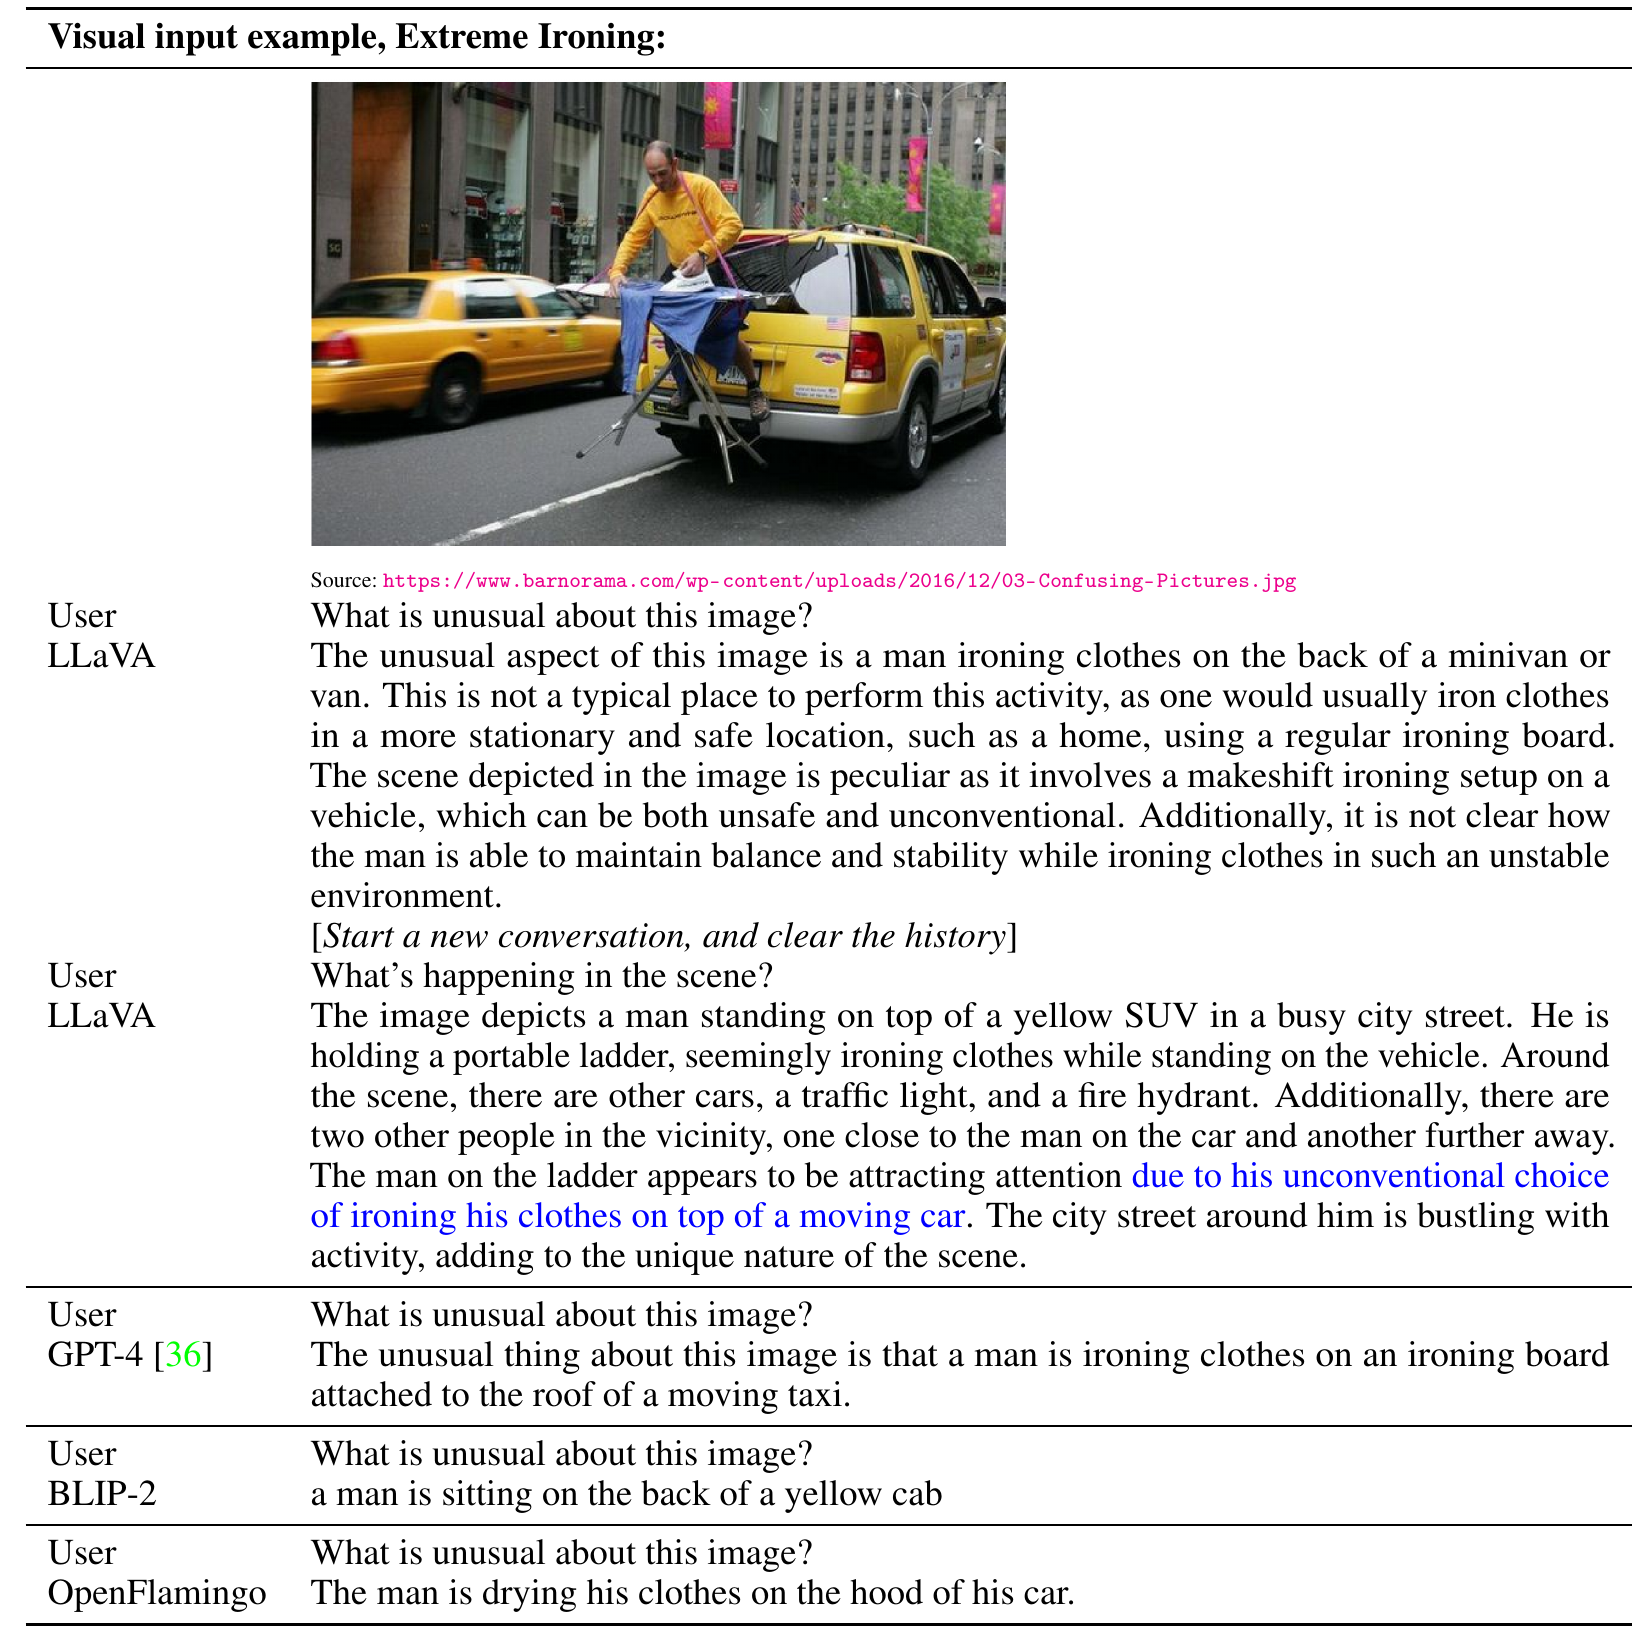
Voici des extraits des réponses de chaque modèle :
- LLaVA : ce qui est inhabituel, c'est un homme qui repasse du linge à l'arrière d'une petite fourgonnette, alors qu'on repasse d'ordinaire chez soi, sur une planche à repasser… et on ne voit pas bien comment il garde l'équilibre dans un endroit aussi instable.
- GPT-4 : ce qui est inhabituel dans cette image, c'est qu'un homme repasse du linge sur une planche à repasser fixée sur le toit d'un taxi en mouvement.
- BLIP-2 : un homme est assis à l'arrière d'un taxi jaune.
- OpenFlamingo : l'homme fait sécher ses vêtements sur le capot de sa voiture.
BLIP-2 et OpenFlamingo se contentent de décrire la scène, et pas très exactement. LLaVA répond à la question, et relève le même point que GPT-4.
Les auteurs ouvrent ensuite une nouvelle conversation et demandent seulement « Que se passe-t-il dans cette scène ? » ; après avoir décrit la rue, LLaVA mentionne de lui-même que cet homme attire l'attention parce qu'il repasse sur le toit d'un véhicule en mouvement. Les données d'entraînement ne comptent qu'environ 80 000 images distinctes, et celle-ci n'en fait pas partie.
GPT-4 comme juge
Quelques exemples ne suffisent pas ; les auteurs conçoivent aussi une évaluation quantitative. LLaVA répond en regardant l'image, tandis que le GPT-4 texte seul répond à partir de la description textuelle de référence, ce qui sert de plafond approximatif ; on donne ensuite à GPT-4 la question, la description textuelle et les deux réponses, et il attribue une note de 1 à 10 selon quatre critères : utilité, pertinence, exactitude et niveau de détail. Le « score relatif » rapporté est la note de LLaVA divisée par celle de GPT-4.
Le premier jeu d'évaluation prend 30 images du jeu de validation de COCO, avec pour chacune trois types de questions générées de la même manière, soit 90 questions. On y compare différentes données d'entraînement :
| Données d'entraînement | Conv. | Détail | Raison. | Total |
|---|---|---|---|---|
| Toutes les données | 83.1 | 75.3 | 96.5 | 85.1 |
| Détail + raison. | 81.5 | 73.3 | 90.8 | 81.9 |
| Conv. + 5 % détail + 10 % raison. | 81.0 | 68.4 | 91.5 | 80.5 |
| Conv. seule | 76.5 | 59.8 | 84.9 | 73.8 |
| Sans instruction tuning | 22.0 | 24.0 | 18.5 | 21.5 |
D'après la Table 4 de l'article. Conv. = conversation, Détail = description détaillée, Raison. = raisonnement complexe.
Sans instruction tuning, le modèle n'obtient que 21.5 ; après fine-tuning, il dépasse 70, soit plus de 50 points d'écart. Avec les seules données de conversation, il obtient 73.8 ; ajouter une petite part de descriptions détaillées et de raisonnements complexes le fait monter à 80.5, et même le score sur les questions de conversation augmente. C'est avec les trois types de données qu'on obtient le meilleur résultat, 85.1.
Le second jeu d'évaluation est plus difficile, avec 24 images et 60 questions, dont des scènes d'intérieur et d'extérieur, des mèmes, des peintures et des croquis ; chaque image est accompagnée d'une description manuelle très détaillée :
| Modèle | Conv. | Détail | Raison. | Total |
|---|---|---|---|---|
| OpenFlamingo | 19.3 | 19.0 | 19.1 | 19.1 |
| BLIP-2 | 54.6 | 29.1 | 32.9 | 38.1 |
| LLaVA | 57.3 | 52.5 | 81.7 | 67.3 |
D'après la Table 5 de l'article (moyenne de trois inférences).
LLaVA obtient 67.3 au total, 29 points de plus que BLIP-2 et 48 de plus qu'OpenFlamingo.
Dans ces deux évaluations, le juge comme les réponses de référence viennent de GPT-4 ; les scores ne servent donc qu'à situer les modèles les uns par rapport aux autres.
Ce qu'il voit mal
Les auteurs présentent aussi deux exemples où LLaVA répond mal :
- Ichiran Ramen : à la question « Quel est ce restaurant ? », il faut reconnaître l'enseigne et savoir lire le japonais ; pour les accompagnements, il faudrait peut-être même chercher sur Internet.
- Un réfrigérateur ouvert : pour répondre à « De quelle marque est le yaourt à la myrtille ? », il faut bien distinguer le logo de Fage, ce qui demande une image en haute résolution et des connaissances suffisantes.
Le plus intéressant est la troisième question. Le réfrigérateur contient des yaourts et une barquette de fraises, mais pas de yaourt à la fraise ; à la question « Y a-t-il du yaourt à la fraise dans le réfrigérateur ? », LLaVA répond oui. Selon les auteurs, il traite parfois l'image comme un « sac de patchs » ; il a vu des yaourts, il a vu des fraises, mais n'a pas compris la relation entre les deux.
Cela tient beaucoup à la façon dont il a été entraîné, par un professeur qui ne voit pas les images. Si bonnes que soient les réponses écrites par GPT-4, elles ne reposent que sur des descriptions textuelles et des boîtes englobantes ; les détails présents dans l'image mais absents de la description, l'élève n'a aucune chance de les apprendre.
ScienceQA
ScienceQA rassemble 21 000 questions de sciences à choix multiples, qui couvrent les sciences naturelles, les sciences sociales et les sciences du langage ; certaines questions sont accompagnées d'une image, d'autres sont purement textuelles. LLaVA écrit d'abord son raisonnement, puis la réponse ; entraîné 12 époques, il atteint une précision de 90.92 %, proche du meilleur résultat de l'époque, 91.68 %.
Le GPT-4 texte seul, avec un prompt few-shot de deux exemples, obtient 82.69 % ; beaucoup de ses échecs viennent de ce qu'il répond qu'« il manque l'image ou le diagramme ». Les auteurs essaient deux combinaisons :
- GPT-4 complété par LLaVA : quand GPT-4 ne sait pas répondre, on prend la réponse de LLaVA ; 90.97 %, à peu près comme LLaVA seul.
- GPT-4 en arbitre : quand les deux réponses diffèrent, on soumet à nouveau la question et les deux réponses à GPT-4, qui donne la réponse finale ; 92.53 %, un nouveau record à l'époque.
Même sans voir les images, GPT-4 parvient à aider jusque sur les questions illustrées. Selon les auteurs, certaines questions accompagnées d'une image peuvent en fait se résoudre sans la regarder ; GPT-4 sait reconnaître ce type de question et corriger certaines erreurs de LLaVA.
Quelques ablations sur ScienceQA :
- Avec les caractéristiques CLIP de la dernière couche, on obtient 89.96 %, 0.96 de moins qu'avec l'avant-dernière. Les auteurs supposent que la dernière couche privilégie les propriétés globales et abstraites de l'image, tandis que l'avant-dernière conserve davantage de détails locaux.
- Pour savoir s'il vaut mieux écrire d'abord le raisonnement ou la réponse, la comparaison utilise les caractéristiques de la dernière couche. Avec la réponse en premier et 12 époques d'entraînement, on obtient 89.77 % ; avec le raisonnement en premier, on atteint ces 89.77 % en seulement 6 époques, puis on ne progresse presque plus. Les auteurs en concluent que raisonner d'abord accélère la convergence, mais aide peu sur le résultat final.
- Sans la première phase d'alignement des caractéristiques, en entraînant directement, on tombe à 85.81 %.
- En passant du modèle 13B au 7B, on tombe à 89.84 %.
La suite
Six mois plus tard, les mêmes auteurs publient LLaVA-1.5. Les changements sont peu nombreux : résolution d'image portée à 336 pixels, projection linéaire remplacée par un MLP, ajout de données académiques de questions-réponses visuelles, avec de simples consignes sur le format de réponse. La version 13B n'utilise que 1.2 million d'exemples publics, s'entraîne en un jour environ sur une seule machine à 8 A100, et obtient les meilleurs résultats de l'époque sur 11 évaluations.
Le squelette « encodeur visuel + couche de projection + modèle de langage » est facile à prendre en main, et bien des modèles multimodaux open source l'ont repris par la suite ; la notation par un juge GPT-4 est elle aussi devenue de plus en plus courante dans l'évaluation des modèles.
Conclusion
Les données d'instructions n'ont pas forcément besoin d'être écrites par des humains, même en multimodal. LLaVA traduit les images en texte pour que GPT-4 pose les questions, obtient ainsi 158K exemples, puis branche CLIP sur Vicuna avec une seule projection linéaire ; les deux phases d'entraînement réunies tiennent en un peu plus d'une demi-journée sur 8 A100, et la capacité à converser sur des images soutient déjà la comparaison avec les exemples du rapport de GPT-4.
L'ordre d'entraînement de cet article mérite d'être copié tel quel. On gèle d'abord les deux extrémités pour n'entraîner que la couche de projection, afin d'aligner les caractéristiques d'image sur les embeddings de mots du modèle de langage ; puis on libère le modèle de langage pour l'instruction tuning. Sautez la première étape, et ScienceQA perd 5 points de pourcentage.
Alors, y a-t-il du yaourt à la fraise dans ce réfrigérateur ? LLaVA affirme que oui, sans la moindre hésitation. Sans doute parce que tout ce que son professeur lui avait dit, c'est « il y a des yaourts dans le réfrigérateur, et aussi des fraises ».