Article original
Iterative Scale-Up ExpansionIoU and Deep Features Association for Multi-Object Tracking in Sports
- Publication
- WACV Workshops 2024Atelier (workshop)
- Premier dépôt sur arXiv
- arXiv:2306.13074
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingdeepeiou2023,
  title = {{Iterative Scale-Up ExpansionIoU and Deep Features Association for Multi-Object Tracking in Sports}},
  author = {Hsiang-Wei Huang and Cheng-Yen Yang and Jiacheng Sun and Pyong-Kun Kim and Kwang-Ju Kim and Kyoungoh Lee and Chung-I Huang and Jenq-Neng Hwang},
  year = {2023},
  eprint = {2306.13074},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2306.13074}
}
L'article SportsMOT contient un tableau d'ablation qui ne laisse pas indifférent. Avec la même association par IoU, la version qui prédit d'abord la position avec un filtre de Kalman obtient un HOTA de 64.1 ; sans prédiction, en comparant directement la boîte de la trajectoire à l'image précédente, on monte au contraire à 71.5.
Si la prédiction ne fait que nuire, pourquoi prédire ?
Hsiang-Wei Huang, Cheng-Yen Yang et Jiacheng Sun, du laboratoire de Jenq-Neng Hwang à l'Université de Washington, avec des collaborateurs de l'Electronics and Telecommunications Research Institute (ETRI) coréen et du National Center for High-performance Computing de Taïwan, proposent Deep-EIoU. La méthode supprime entièrement le filtre de Kalman, cherche les gens avec une boîte très agrandie, et ajoute des caractéristiques d'apparence pour savoir qui est qui.
Elle atteint un HOTA de 77.2 sur SportsMOT, 3 points de plus que la meilleure méthode de l'article SportsMOT.
Définir le problème
Les auteurs donnent trois raisons pour lesquelles les scènes sportives sont difficiles à suivre :
- Des occultations sévères. Les duels sont intenses ; les joueurs s'agglutinent souvent et se masquent les uns les autres, bien plus qu'en suivi de piétons.
- Des apparences similaires. Les joueurs d'une même équipe portent des maillots de la même couleur.
- Des mouvements imprévisibles. Dribble entre les jambes au basket-ball, tacle glissé au football, smash au volley-ball ; vitesse et direction changent en un instant.
Les traqueurs dominants, qu'ils combinent apparence et mouvement ou ne s'appuient que sur le mouvement, prédisent pour la plupart la position avec un filtre de Kalman. Celui-ci suppose un mouvement linéaire et un bruit gaussien ; dès que le mouvement de l'objet s'en écarte, la prédiction dérive. OC-SORT tente de réparer le filtre de Kalman ; C-BIoU le remplace par un déplacement moyen, et agrandit les boîtes pour compenser l'erreur d'estimation.
Deep-EIoU va plus loin et renonce même à toute estimation de mouvement.
Résoudre le problème
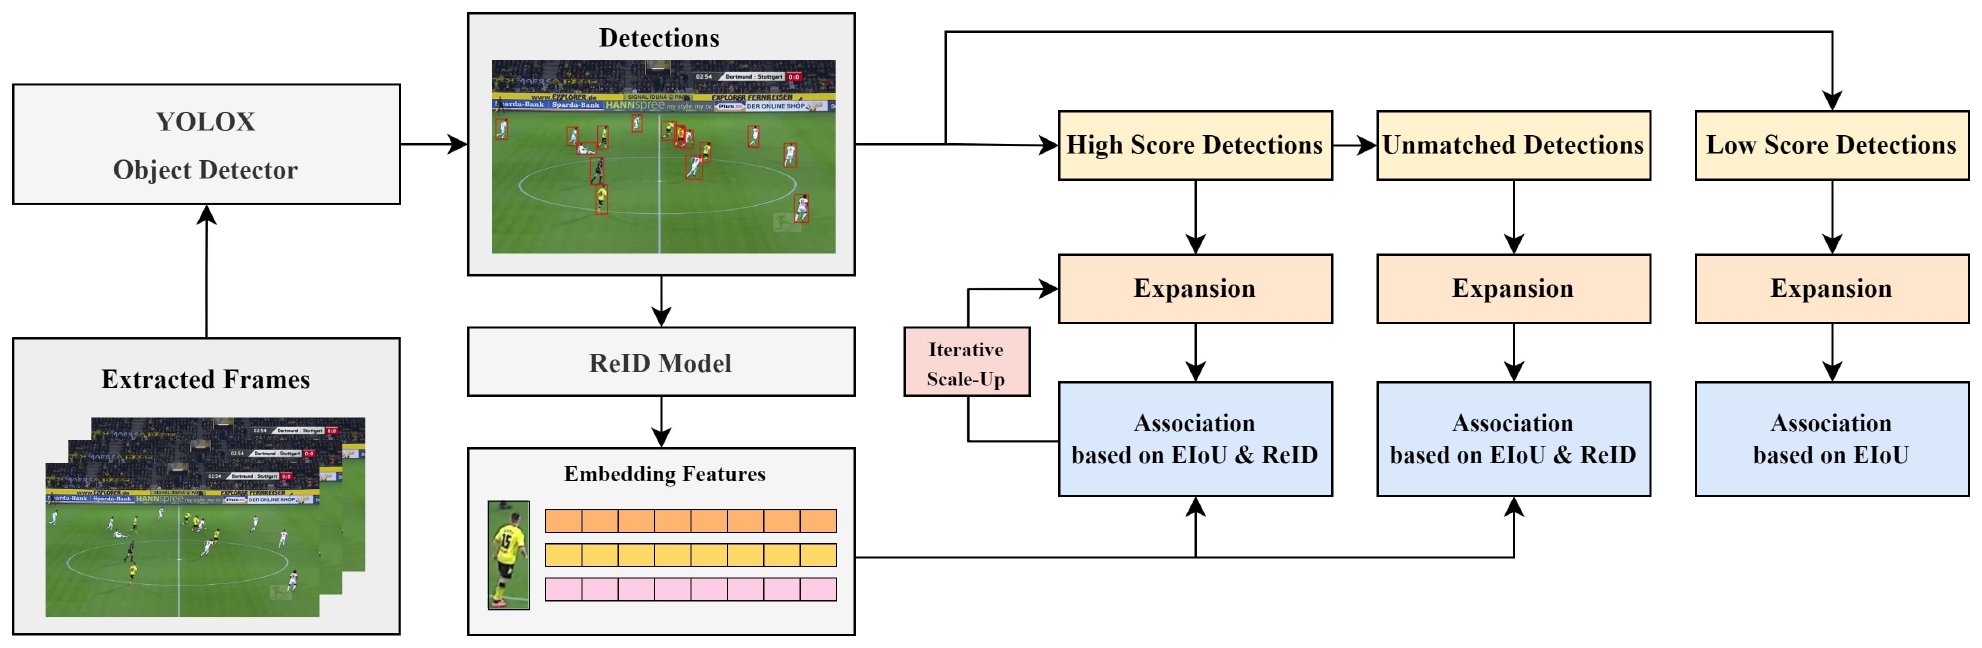
L'ensemble reste une architecture « détecter puis associer », qui n'utilise que les informations passées et présentes et peut tourner en ligne. À chaque image, YOLOX détecte les joueurs, un modèle ReID extrait la caractéristique d'apparence de chaque boîte, puis on calcule le coût entre trajectoires et détections, et l'algorithme hongrois se charge de l'appariement.
La grande différence avec un traqueur ordinaire tient à la boîte que la trajectoire utilise pour la comparaison. Deep-EIoU ne prédit pas où la trajectoire se trouvera dans l'image courante ; il compare directement la dernière boîte où la trajectoire a été vue aux nouvelles détections.
Une boîte très agrandie
Pour la position, la méthode utilise l'IoU d'expansion (ExpansionIoU, EIoU). Les auteurs précisent que l'idée vient de C-BIoU, mais ils ont constaté que, pour des sportifs, il vaut mieux agrandir les boîtes bien davantage.
L'expansion est réglée par un taux . Pour une boîte de largeur et de hauteur , les longueurs d'expansion sont
Chaque longueur est ensuite partagée en deux moitiés, ajoutées de part et d'autre de la boîte ; le coin supérieur gauche est repoussé vers l'extérieur de , et le coin inférieur droit de même. La boîte agrandie a donc une largeur et une hauteur égales à fois celles d'origine. Le code officiel est conforme à cette définition.
Avec la valeur par défaut , largeur et hauteur sont multipliées par 3.4, et l'aire par près de 12. Dans la notation de C-BIoU, cela correspond à un taux de marge de 1.2 ; sur DanceTrack, la meilleure marge de C-BIoU n'était que de 0.3 à 0.4.
Reprenons pour comparer l'exemple de la note sur C-BIoU. Un joueur de 40 pixels de large et 100 de haut se déplace de 50 pixels vers la droite à l'image suivante ; l'IoU d'origine vaut 0 :
| Boîte agrandie | Même joueur (50 px) | Voisin (70 px) | Voisin (100 px) | |
|---|---|---|---|---|
| C-BIoU () | 64 × 160 | 0.12 | 0 | 0 |
| Deep-EIoU () | 136 × 340 | 0.46 | 0.32 | 0.15 |
Exemple de calcul établi pour cette note ; les deux boîtes ont la même taille et sont alignées en hauteur.
Avec une boîte aussi grande, un joueur qui se déplace d'un coup de plus d'une largeur de corps reste repérable. Le prix à payer est tout aussi évident, puisque toute personne à moins de trois largeurs de corps, à gauche comme à droite, devient candidate. Il faut alors compter sur l'apparence pour départager les gens.
Comment combiner apparence et position
Le coût d'apparence est la distance cosinus entre les vecteurs de caractéristiques de la trajectoire et de la détection :
Beaucoup de méthodes font une somme pondérée du coût d'apparence et du coût d'IoU ; les auteurs ne procèdent pas ainsi, et reprennent l'approche de BoT-SORT. On commence par ajuster le coût d'apparence. Si ou , le coût d'apparence ajusté vaut ; sinon, . Le coût de la première étape est ensuite le plus petit des deux :
Ici, et .
Pour que l'apparence serve, il faut que les deux se ressemblent assez et que leurs positions soient assez proches (EIoU d'au moins 0.5). Si l'une des deux conditions n'est pas remplie, le coût d'apparence est fixé à 1, ce qui revient à ignorer l'apparence ; si les deux le sont, le coût d'apparence est encore divisé par deux. On prend enfin le plus petit des coûts d'apparence et de position.
L'apparence ne peut donc que rendre « plus sûr » un appariement déjà proche ; elle ne peut pas forcer l'appariement de deux personnes éloignées qui se ressemblent simplement. C'est particulièrement important quand les joueurs d'une même équipe portent tous le même maillot.
Les cas sûrs d'abord
L'appariement reprend les niveaux de ByteTrack. Les détections à score élevé, de confiance au moins égale à 0.6, sont en général moins occultées et ont des caractéristiques d'apparence plus fiables ; on les apparie donc en premier aux trajectoires, avec le coût combinant apparence et EIoU décrit plus haut. Les détections à faible score, de confiance comprise entre 0.1 et 0.6, sont appariées au second tour aux trajectoires restantes, avec l'EIoU seul ; celles sous 0.1 sont jetées directement.
Par ailleurs, les auteurs suppriment la contrainte de rapport largeur/hauteur que les traqueurs ordinaires imposent aux boîtes, car un joueur peut se retrouver au sol, alors que les piétons marchent pour la plupart debout. Les trajectoires perdues sont conservées 60 images, plus que les 30 habituelles en suivi de piétons, car les occultations sont plus sévères sur un terrain de sport.
Agrandir pas à pas, sans réglage
Les ablations de C-BIoU l'ont déjà montré, le taux de marge est un hyperparamètre sensible. Les auteurs relèvent qu'il est difficile à régler dans un vrai système de suivi de sportifs. Le système doit fonctionner en ligne et en temps réel, sans possibilité d'expérimenter à répétition après coup, et dans une scène réelle, on ne dispose pas de la vérité terrain des données de test, si bien qu'on n'a aucun moyen de le chercher.
Au lieu de chercher le meilleur , ils font donc croître pas à pas pendant la phase d'appariement des détections à score élevé, en répétant l'appariement :
part de 0. Le premier tour utilise et règle d'abord les appariements qui se recouvrent le plus, les plus sûrs ; ce qui reste sans partenaire est recherché au tour suivant avec une boîte un peu plus grande. Par défaut, et le pas vaut , sur deux tours, soit 0.7 puis 0.8.
Discussion
SportsMOT
Le détecteur est un YOLOX-X, parti de poids préentraînés sur COCO et affiné pendant 80 epochs sur les ensembles d'entraînement et de validation de SportsMOT. Le modèle ReID est un OSNet, parti des poids du jeu de données de ré-identification de piétons Market-1501, puis affiné sur 31 279 images de joueurs découpées dans les boîtes de vérité terrain de SportsMOT.
| Méthode | Données | HOTA | AssA | DetA | IDF1 |
|---|---|---|---|---|---|
| BoT-SORT | Entr. | 68.7 | 55.9 | 84.4 | 70.0 |
| OC-SORT | Entr. | 71.9 | 59.8 | 86.4 | 72.2 |
| Deep-EIoU | Entr. | 74.1 | 63.1 | 87.2 | 75.0 |
| OC-SORT | Entr. + val. | 73.7 | 61.5 | 88.5 | 74.0 |
| MixSort-OC | Entr. + val. | 74.1 | 62.0 | 88.5 | 74.4 |
| Deep-EIoU | Entr. + val. | 77.2 | 67.7 | 88.2 | 79.8 |
D'après la Table 2 de l'article, ensemble de test de SportsMOT ; Entr. = ensemble d'entraînement, val. = ensemble de validation. BoT-SORT a été relancé avec son code officiel ; les autres chiffres de référence viennent de l'article SportsMOT.
À données d'entraînement égales, Deep-EIoU est le meilleur dans les deux configurations. Avec entraînement et validation, il dépasse MixSort-OC de 3.1 points de HOTA et de 5.7 points d'AssA, la métrique d'association ; le DetA de la détection est à peu près le même, voire légèrement inférieur. L'écart vient presque entièrement de l'association.
SoccerNet
SoccerNet-Tracking compte 201 vidéos de football de 30 secondes chacune, où il faut suivre non seulement les joueurs, mais aussi les gardiens, les arbitres et le ballon. Pour ne comparer que le suivi, toutes les méthodes utilisent directement les boîtes de vérité terrain fournies par le jeu de données.
Deep-EIoU obtient un HOTA de 85.4 ; OC-SORT, deuxième, 78.1, BoT-SORT 77.0, et ByteTrack et DeepSORT seulement 71.5 et 69.6.
La contribution de chaque pièce
| Configuration | HOTA |
|---|---|
| Base (EIoU seul) | 71.4 |
| + apparence (ReID) | 75.3 |
| + agrandissement progressif | 77.2 |
| + interpolation linéaire | 77.2 |
D'après la Table 4 de l'article, ensemble de test de SportsMOT.
- L'apparence apporte le plus, 3.9 points. Les joueurs d'une même équipe ont beau se ressembler, l'apparence reste un indice important. C'est cohérent avec la conclusion de l'article SportsMOT, « similaires mais distinguables ».
- L'agrandissement progressif ajoute 1.9 point. Les auteurs précisent que cette étape allonge aussi la conservation des trajectoires perdues de 30 à 60 images ; ces 1.9 points sont donc l'effet combiné des deux.
- L'interpolation linéaire n'a presque aucun effet, avec un gain inférieur à 0.1 point.
La base qui n'utilise que l'EIoU, sans apparence, est à 71.4, très proche de la ligne « IoU sans Kalman » de l'article SportsMOT (71.5). Les deux articles n'entraînent pas leur détecteur de la même façon, et la comparaison reste approximative ; à en juger par ces chiffres, agrandir les boîtes à lui seul ne fait guère mieux qu'un IoU sans prédiction, et les points supplémentaires de Deep-EIoU viennent surtout de l'apparence et de l'agrandissement progressif.
Le taux d'expansion se passe-t-il vraiment de réglage ?
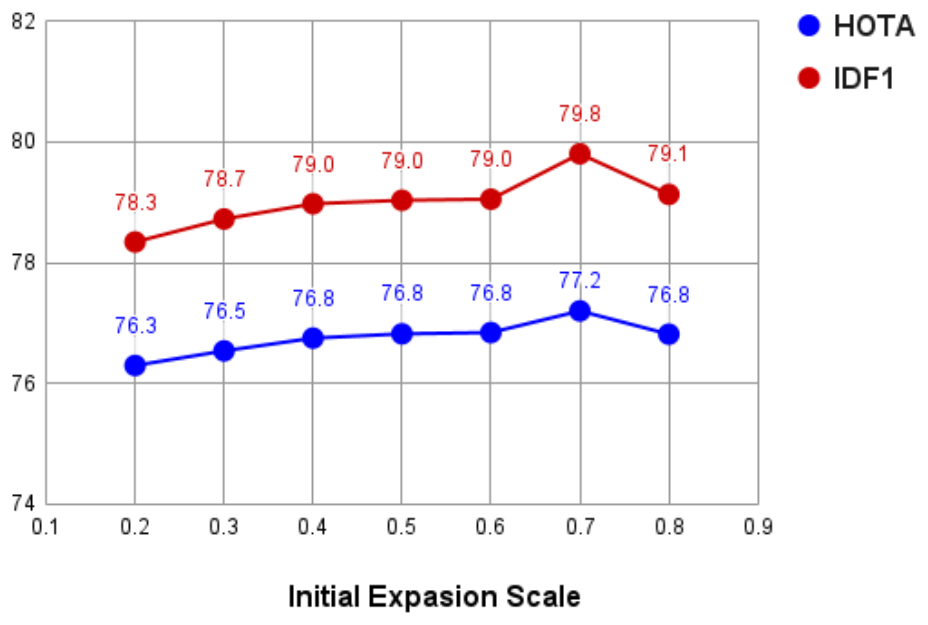
Les auteurs font varier le taux d'expansion initial de 0.2 à 0.8, sans rien changer d'autre. Le HOTA reste entre 76.3 et 77.2, toujours au-dessus du meilleur résultat antérieur, 74.1. Les auteurs en concluent que l'agrandissement progressif dispense la méthode de tout réglage.
On peut aussi lire cette figure autrement. Avec un taux initial de 0.2, les deux tours utilisent 0.2 et 0.3, et largeur et hauteur des boîtes sont multipliées par 2.4 à 2.6 ; à 0.7, elles le sont par 3.4 à 3.6, pour seulement 0.9 point de HOTA en plus. Dans cette plage, la taille de l'agrandissement compte en fait assez peu.
Cela dit, le plus petit agrandissement de la figure est déjà de 2.4 fois, plus que le réglage de C-BIoU. Les auteurs affirment qu'« agrandir davantage que C-BIoU est nettement meilleur », mais cette figure ne fait pas directement cette comparaison ; à en juger par le tableau d'ablation, ce qui donne vraiment de l'avance à Deep-EIoU reste l'apparence et l'agrandissement progressif.
L'EIoU aide aussi le filtre de Kalman
Enfin, les auteurs insèrent directement l'EIoU dans deux traqueurs fondés sur le filtre de Kalman ; boîtes prédites et boîtes de détection sont agrandies avant le calcul de l'IoU. Le HOTA de ByteTrack passe de 62.8 à 67.5, celui de BoT-SORT de 68.7 à 71.3.
L'EIoU ne se limite donc pas aux traqueurs sans prédiction ; c'est aussi une petite astuce prête à l'emploi. Mais même avec l'EIoU, ces deux traqueurs à Kalman restent derrière Deep-EIoU, qui ne prédit rien du tout.
Limites
Les auteurs relèvent deux limites dans l'article :
- Pas de correction hors ligne des trajectoires. Quand un joueur sort du champ puis revient, un traqueur en ligne a du mal à le reconnaître. Les auteurs évoquent la possibilité d'ajouter un post-traitement ou un mécanisme de mémoire plus puissant, mais ne le font pas dans cet article.
- La vitesse. Détecteur et modèle ReID compris, l'ensemble tourne à environ 14.6 images par seconde sur une RTX 4080, plus lentement que les traqueurs fondés sur le seul mouvement ; des détecteurs et des modèles ReID plus légers permettraient d'accélérer.
Conclusion
Deep-EIoU fait un choix audacieux pour les scènes sportives. Il ne prédit pas où sera le joueur à l'image suivante ; il prend seulement la dernière position observée, agrandit la boîte 3.4 fois pour chercher la personne, puis filtre par l'apparence les candidats qui affluent dans cette boîte agrandie. L'apparence ne peut que conforter un appariement déjà proche, sans attirer une personne lointaine qui se trouve simplement lui ressembler ; quant au taux d'expansion, on en essaie deux valeurs croissantes, ce qui évite le réglage.
Les ablations montrent que, des trois choix de conception, l'apparence apporte le plus, devant l'agrandissement progressif. La base qui n'utilise que l'EIoU reste proche de l'IoU sans prédiction de l'article SportsMOT.
Une revue de 2025 sur le suivi multi-objets décrit Deep-EIoU comme une généralisation de C-BIoU, passée de deux expansions fixes à un agrandissement progressif, et le classe deuxième dans son tableau comparatif sur SportsMOT, derrière la seule méthode des auteurs de la revue. Elle rappelle aussi que Deep-EIoU n'a été évalué que sur SportsMOT et SoccerNet.
Quant à la première limite reconnue par l'article, les joueurs qu'on ne reconnaît plus quand ils reviennent dans le champ, le même laboratoire y a répondu un peu plus d'un an plus tard avec GTA.