Article original
Evaluating Multiple Object Tracking Performance: The CLEAR MOT Metrics
- Publication
- EURASIP Journal on Image and Video Processing 2008Revue
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@article{multiobjecttrackingclearmot2008,
  title = {{Evaluating Multiple Object Tracking Performance: The CLEAR MOT Metrics}},
  author = {Keni Bernardin and Rainer Stiefelhagen},
  year = {2008},
  journal = {EURASIP Journal on Image and Video Processing},
  url = {https://doi.org/10.1155/2008/246309},
  doi = {10.1155/2008/246309}
}
Dans le tableau principal d'un article de suivi, la première colonne est presque toujours MOTA.
SORT, DeepSORT et FairMOT se classent tous grâce à lui. Dans l'article HOTA, il est décortiqué et critiqué ; trois changements d'identité (ID switches) n'y coûtent que 3 points, et la détection accapare presque tout le score.
Avec autant de défauts, pourquoi l'a-t-on conçu ainsi au départ ?
Cette fois, on remonte à la source. En 2008, Keni Bernardin et Rainer Stiefelhagen, de l'Université de Karlsruhe, en Allemagne, proposent deux métriques, MOTA et MOTP ; le CLEAR du titre est le nom de deux campagnes d'évaluation internationales, celles de 2006 et de 2007.
Fait intéressant, ce qu'il fallait évaluer à l'époque ressemblait très peu au suivi de piétons qui nous est familier. La tâche principale consistait, dans une salle de séminaire, à estimer avec plusieurs caméras l'endroit du sol où se tenait chaque personne, en centimètres ; s'y ajoutaient le suivi de visages, celui des piétons et des véhicules dans la rue, et même un suivi acoustique, qui repérait avec des réseaux de microphones la personne en train de parler. Bien des choix de conception de MOTA ont été imposés par ces tâches.
Définir le problème
Le suivi d'un objet unique s'évalue facilement ; il suffit de mesurer l'erreur de position à chaque image. Avec plusieurs objets, les choses se compliquent. Le traqueur peut produire plus de trajectoires qu'il n'y a d'objets réels, ou moins, et les trajectoires peuvent en plus s'intervertir.
Ce n'étaient pas les métriques qui manquaient à l'époque, c'était le consensus. Les auteurs passent en revue plusieurs méthodes d'évaluation existantes :
- Li et al. ont conçu trois mesures pour le suivi multi-caméras de joueurs de football ; deux ne s'appliquent qu'au football, et la plus générale ne tient compte ni des fausses trajectoires ni de l'erreur de localisation.
- Le projet ETISEO propose 8 métriques interdépendantes ; beaucoup ne s'interprètent qu'avec une ou deux autres à côté.
- Smith et al. sont les plus proches de l'idée de cet article, mais utilisent 9 mesures : 5 pour les erreurs de configuration des objets, 4 pour les incohérences d'étiquetage. Certaines mesures sont même définies deux fois, une fois côté traqueur et une fois côté objet, comme MT/MO et FIT/FIO.
Avec autant de métriques et des dizaines de systèmes à comparer dans une grande campagne, le lecteur n'arrive tout simplement pas à voir qui fait mieux que qui. Résultat, beaucoup d'articles renoncent à toute évaluation quantitative, ou en inventent chacun une.
Les auteurs décrivent d'abord le traqueur multi-objets idéal. À chaque instant, il trouve le bon nombre d'objets et estime leur position aussi précisément que possible ; chaque objet garde du début à la fin un seul identifiant, qui ne change pas, même quand l'objet revient après une brève occultation. Le contour, l'orientation ou la vitesse ne sont pas pris en compte.
Les exigences posées aux métriques en découlent :
- Juger la précision des positions estimées.
- Refléter si le traqueur suit chaque objet de façon cohérente, avec exactement une trajectoire par objet.
- Avoir le moins possible de paramètres et de seuils à régler.
- Être intuitives ; les chiffres restent sensés quand plusieurs types d'erreurs surviennent en même temps, ou quand les erreurs se répartissent inégalement dans le temps.
- Être générales ; on peut comparer des traqueurs 2D ou 3D, qui n'estiment que le centre ou qui estiment une boîte.
- Être peu nombreuses, mais en dire assez.
Les deux premiers points sont des objectifs, les quatre suivants des contraintes. La vraie difficulté, c'est « comment compter les erreurs ». Dans une vidéo, un traqueur change une fois l'identifiant d'une même personne : combien d'erreurs cela fait-il ? Réfléchissez-y avant de lire la suite.
Résoudre le problème
À chaque image, l'évaluation fait trois choses :
- Trouver la meilleure correspondance entre les hypothèses produites par le traqueur, , et les objets réels .
- Pour chaque paire mise en correspondance, calculer l'erreur de position.
- Cumuler trois types d'erreurs. Un objet auquel aucune hypothèse ne correspond est une détection manquée (miss) ; une hypothèse qui ne correspond à aucun objet réel est un faux positif (false positive) ; quand l'hypothèse associée à un objet diffère de la précédente, on compte une erreur d'appariement (mismatch).
Au final, deux nombres seulement résument les performances du traqueur : la précision des positions estimées, et le nombre total d'erreurs commises.
Presque tous les détails de la procédure se trouvent dans la première étape.
Trop loin, ça ne compte pas
L'approche la plus intuitive consiste à associer chaque objet à l'hypothèse la plus proche ; les objets restants sont des détections manquées, les hypothèses restantes des faux positifs. Le premier cas à traiter, c'est celui où même l'hypothèse la plus proche est très loin.
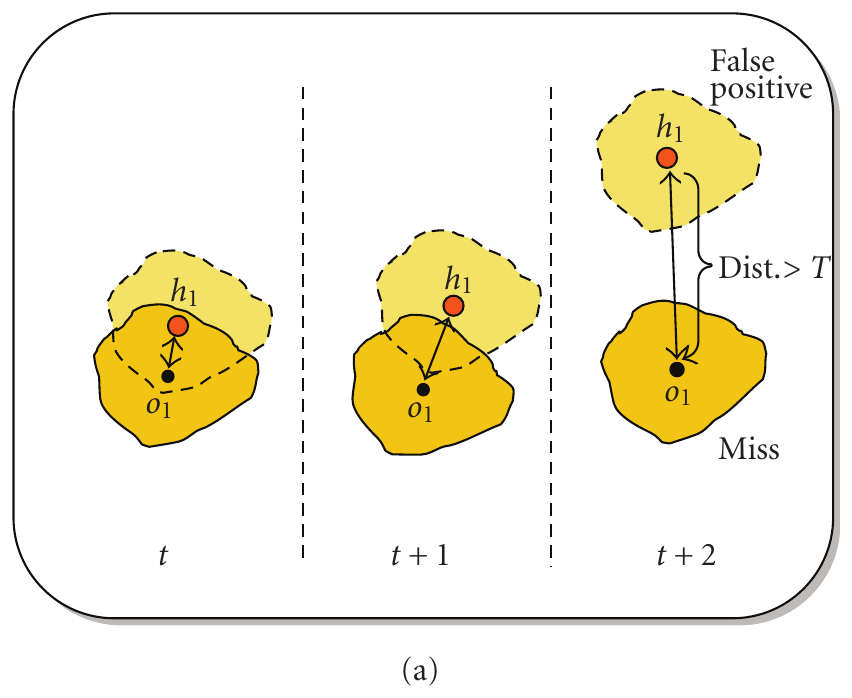
Dans la figure, dérive vers le haut à la troisième image. Suit-elle encore ? Pour les auteurs, au-delà d'une certaine distance, on ne peut plus parler de « position mal estimée » ; le traqueur a perdu l'objet et suit autre chose. Seules les correspondances dont la distance vérifie sont donc valides ; au-delà du seuil, l'objet compte pour une détection manquée et l'hypothèse pour un faux positif.
Le choix de dépend de la tâche et de la façon de calculer la distance. Pour un traqueur qui estime des boîtes, on peut utiliser le recouvrement, avec pour seuil « aucun recouvrement » ; pour un traqueur qui n'estime que le centre, on prend la distance euclidienne, et le seuil peut être la largeur moyenne d'une personne, en pixels ou en centimètres. Les auteurs le disent clairement, on ne peut pas donner à une valeur universelle, valable dans tous les cas, et l'article n'étudie pas non plus de méthode pour le fixer automatiquement à partir des données.
Changer de personne, combien d'erreurs ?
Vient ensuite la cohérence dans le temps.
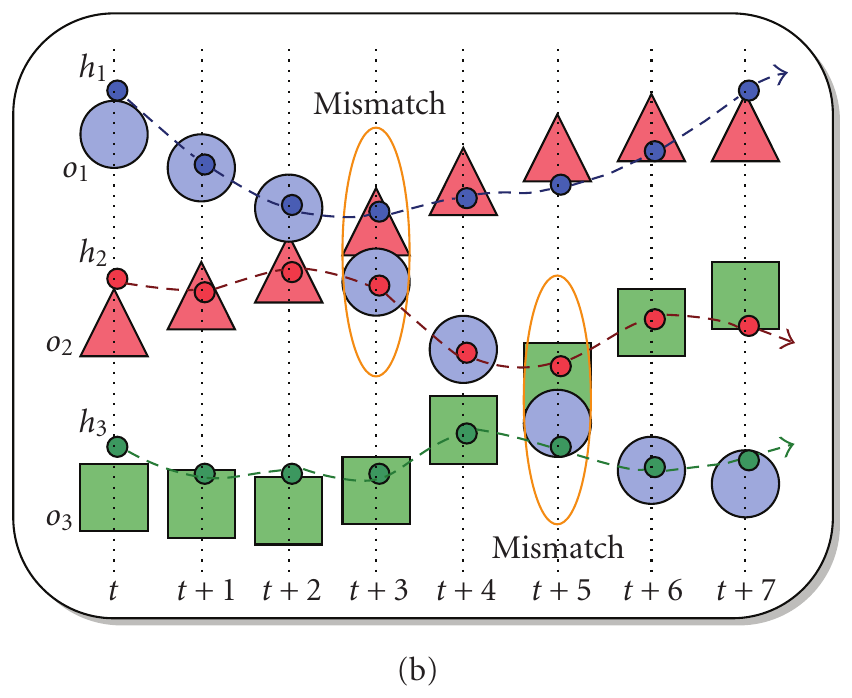
Au départ, , et suivent respectivement , et . À , le bleu et le rouge se rejoignent ; une fois qu'ils se séparent, suit et suit . À , croise cette fois le vert, et c'est au tour de de suivre , et de de suivre .
Comment compter ce genre d'erreur ?
Une idée serait de fixer d'abord, pour chaque objet, une « meilleure » hypothèse, par exemple la première qui lui a été associée, ou celle qui lui a été associée le plus souvent sur toute la vidéo, puis de compter comme erreur chaque image qui contredit cet appariement. Les auteurs montrent le problème de cette approche avec la figure suivante.
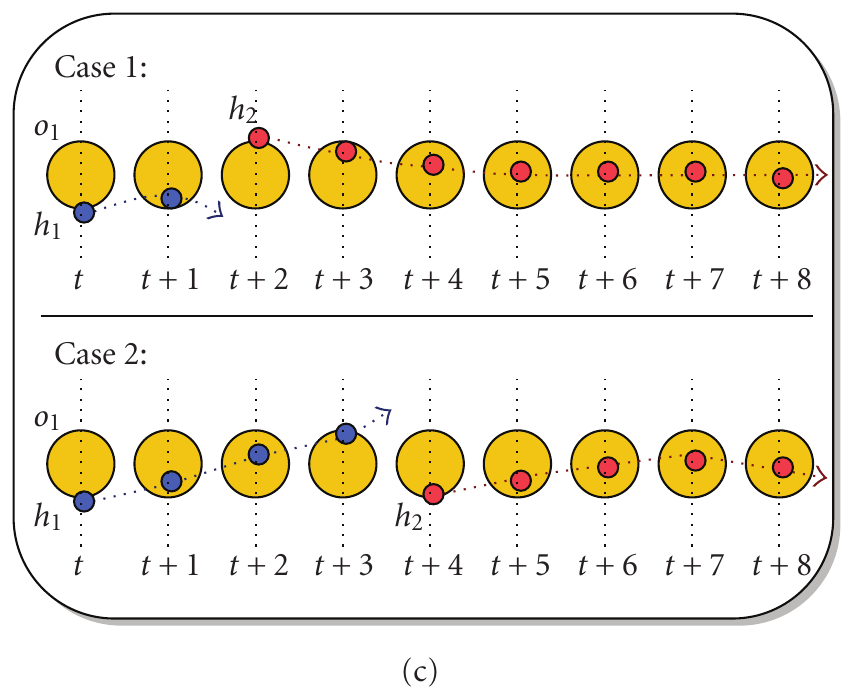
Dans les deux situations, l'hypothèse ne change qu'une fois ; c'est la même erreur. Mais est chaque fois l'hypothèse associée le plus souvent. Si l'on compte par rapport au « meilleur appariement », Case 1 ne le contredit que sur les 2 premières images, soit 2 erreurs ; Case 2 le contredit sur les 4 premières, soit 4 erreurs. Le nombre d'erreurs dépend alors du moment, précoce ou tardif, où l'échange a lieu.
Les auteurs choisissent plutôt de compter une seule erreur d'appariement, à l'image où la correspondance change, et de tenir tout le reste pour correct. Un changement, une erreur.
Recomptons la Figure 2(b) avec cette règle. Au croisement de , et changent chacun d'hypothèse, ce qui fait deux erreurs ; à celui de , et en changent chacun une fois, encore deux ; au total, quatre erreurs d'appariement. Ensuite, suit jusqu'au bout sans être pénalisée à chaque image pour avoir « suivi la mauvaise personne ».
Se souvenir de qui allait avec qui
Pour savoir que « la correspondance a changé », il faut se souvenir des correspondances précédentes. Les auteurs maintiennent une table de correspondances , qui enregistre tous les appariements jusqu'à l'instant ; elle est vide au départ, . Si, à , est apparié à , en contradiction avec le de la table, on compte une erreur d'appariement et on remplace l'entrée de la table par .
Cette table sert aussi à autre chose ; quand il existe plusieurs choix valides, c'est elle qui décide de l'appariement.
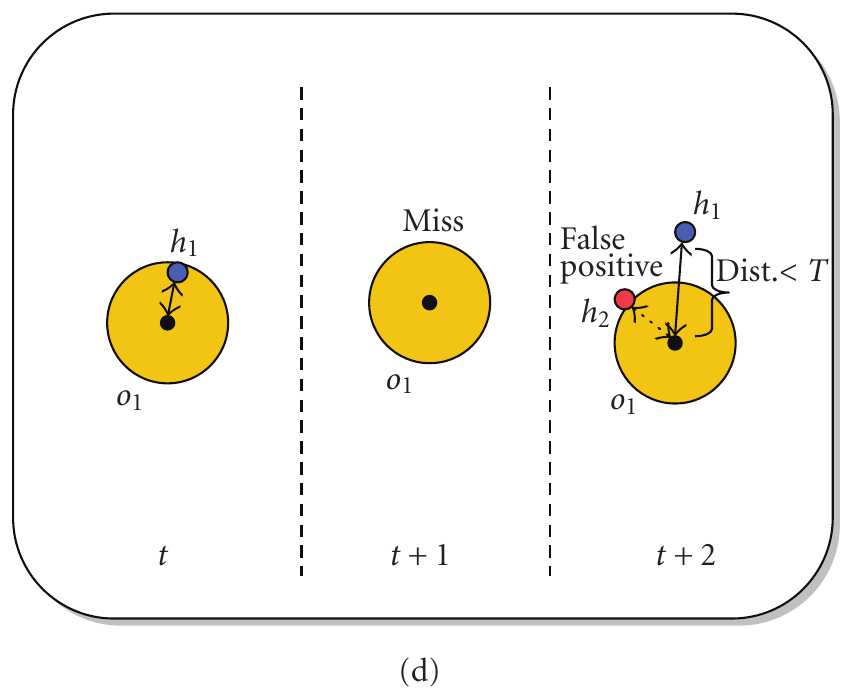
perd la cible à et revient à , tandis qu'apparaît à côté une plus proche. À ne regarder que la distance, il faudrait choisir ; mais la table contient , et les auteurs donnent la priorité à cet appariement, parce que c'est lui qui a le plus de chances d'être la bonne trajectoire. compte comme faux positif ; ce peut être une hypothèse en trop que le traqueur a produite pour la même personne, ou une hypothèse qui suivait quelqu'un d'autre et qui a dérivé jusque-là.
La procédure d'appariement complète
En réunissant tout cela, voici la procédure appliquée à chaque image :
- Reprendre d'abord les anciennes correspondances. Pour chaque paire de la table , si l'objet est toujours là, l'hypothèse aussi, et que la distance ne dépasse pas , la paire est directement appariée dans cette image.
- Apparier ensuite le reste. Entre les objets et les hypothèses encore libres, on cherche l'appariement de distance totale minimale, un à un et sans dépasser la distance . C'est un problème d'affectation de poids minimal, résolu par l'algorithme de Munkres (autrement dit l'algorithme hongrois). Si un nouvel appariement contredit , on met la table à jour et on compte une erreur d'appariement ; le nombre d'erreurs d'appariement de l'image est noté .
- Calculer les distances. L'image compte au total paires appariées ; pour chacune, on calcule la distance entre l'objet et son hypothèse.
- Compter le reste comme erreurs. Les hypothèses non appariées sont toutes des faux positifs, au nombre de ; les objets non appariés sont tous des détections manquées, au nombre de . Le nombre d'objets réels de l'image est noté .
- Passer à l'image suivante. À la première image, la table est vide ; tous les appariements sont nouveaux, et il ne peut y avoir aucune erreur d'appariement.
La première étape est le cœur de la procédure. Tant qu'un ancien appariement reste valide, on ne laisse pas l'algorithme hongrois en décider à nouveau, même si un nouvel appariement réduirait la distance totale. Ainsi, un traqueur qui suit le même objet de façon cohérente en est récompensé dans l'évaluation.
Deux métriques
Avec les décomptes de chaque image, la première métrique est la précision du suivi multi-objets (MOTP) :
C'est l'erreur de position moyenne sur toutes les correspondances établies. Elle ne répond qu'à la question « quand il y a appariement, la position est-elle bien estimée ? » ; que le traqueur ait trouvé le bon nombre d'objets ou changé d'identifiant n'y entre pas. Avec la distance euclidienne, plus elle est petite, mieux c'est ; avec le recouvrement des boîtes, plus elle est grande, mieux c'est.
La seconde métrique est l'exactitude du suivi multi-objets (MOTA) :
Le numérateur additionne les détections manquées, les faux positifs et les erreurs d'appariement de toutes les images ; le dénominateur est le nombre d'objets réels sur l'ensemble des images. Une fois décomposé, c'est la somme de trois taux d'erreur :
MOTA vaut donc 1 moins le taux d'erreur total. Les auteurs le comparent au taux d'erreur sur les mots (WER) de la reconnaissance vocale, qui additionne ce qui manque, ce qui est en trop et ce qui est mal reconnu, puis divise par la longueur de la transcription de référence.
Le taux d'erreur sur les mots peut dépasser 100 % ; MOTA peut donc tout naturellement être négatif. Quand les faux positifs sont nombreux, le numérateur peut dépasser le dénominateur.
Additionner d'abord, diviser ensuite
Dans la formule, la somme est faite séparément au numérateur et au dénominateur ; on ne calcule pas un taux par image pour en faire ensuite la moyenne. Cet ordre est délibéré.
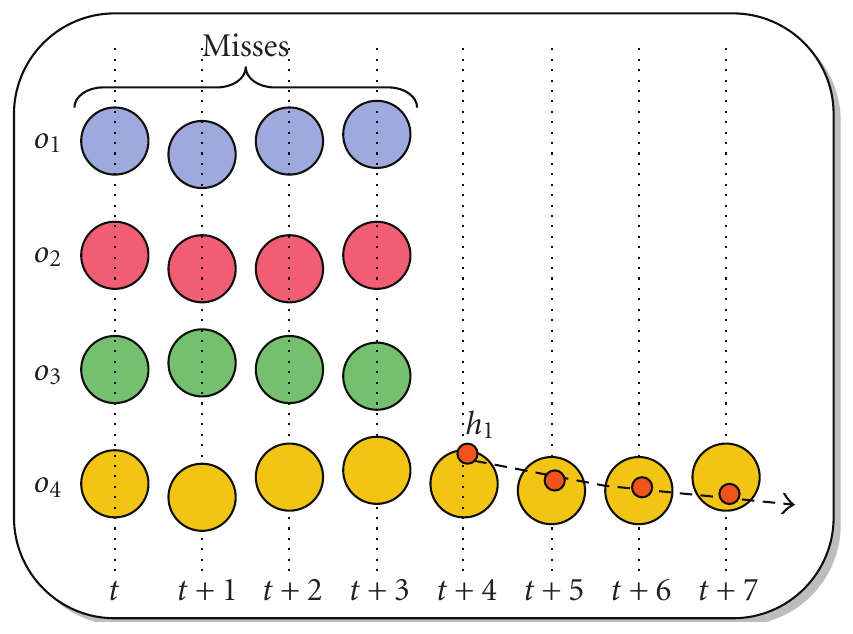
Calculons le taux de détections manquées sur cette figure.
Sur les 4 premières images, aucun des 4 objets n'est suivi ; le taux de détections manquées de chaque image est de 100 %. Sur les 4 dernières, il ne reste qu'un objet, et il est suivi ; le taux est de 0 %. Si l'on calcule d'abord le taux de chaque image, puis la moyenne :
Si l'on additionne d'abord les erreurs avant de diviser, les 4 premières images comptent 16 détections manquées, les 8 images au total objets, et le taux de détections manquées est de .
Ce traqueur manque de toute évidence la plupart des objets, et pourtant la moyenne par image dit qu'il en manque la moitié. Les auteurs relèvent que les mesures de faux positifs et de détections manquées de Smith et al. reposent justement sur une moyenne par image, d'où ce genre de résultat contre-intuitif.
En pratique dans les évaluations CLEAR
Le nom complet de CLEAR est Classification of Events, Activities and Relationships. Ces campagnes étaient organisées conjointement par le projet européen CHIL, le projet américain VACE et le National Institute of Standards and Technology (NIST) des États-Unis, rejoints en 2007 par le projet AMI. En 2006, certaines tâches utilisaient encore d'autres métriques ; en 2007, toutes les tâches liées au suivi, qu'il s'agisse d'un ou de plusieurs objets, d'images ou de son, sont évaluées avec les métriques MOT.
D'une tâche à l'autre, seuls changent le calcul de la distance et le seuil :
- Suivi visuel 3D de personnes : des scènes de séminaires et de réunions, où plusieurs caméras servent à estimer la position de chaque personne sur le sol. La distance est la distance euclidienne au sol, avec un seuil de 50 cm. Les fusions et scissions de trajectoires, fréquentes en suivi sur images 2D, n'ont guère de sens dans ce contexte 3D multi-caméras ; il faut au contraire bien distinguer erreur de localisation, faux positif et appariement à la mauvaise personne. Selon les auteurs, c'est cette tâche qui a dicté l'essentiel de la conception des métriques MOT.
- Suivi 2D de visages : estimer la position et l'étendue des visages dans chaque vue ; la distance devient le recouvrement des boîtes, avec pour seuil l'absence totale de recouvrement.
- Suivi 2D de piétons et de véhicules : des scènes de circulation en extérieur, là encore avec le recouvrement des boîtes.
- Suivi 3D acoustique et multimodal de personnes : localiser la personne qui parle à l'aide de réseaux de microphones répartis. Détections manquées et faux positifs correspondent exactement aux erreurs de segmentation de la parole, et MOTP à la précision de localisation. Le suivi acoustique n'exige pas de savoir qui parle ; les erreurs d'appariement n'y sont donc pas comptées, et cette version s'appelle A-MOTA.
Sept systèmes, trois ex aequo
Voici les résultats du suivi visuel 3D multi-personnes de 2007 :
| Système | MOTP | Manqués | Faux pos. | Err. app. | MOTA |
|---|---|---|---|---|---|
| A | 92 mm | 30.86 % | 6.99 % | 1 139 | 59.66 % |
| B | 91 mm | 32.78 % | 5.25 % | 1 103 | 59.56 % |
| C | 141 mm | 20.66 % | 18.58 % | 518 | 59.62 % |
| D | 155 mm | 15.09 % | 14.5 % | 378 | 69.58 % |
| E | 222 mm | 23.74 % | 20.24 % | 490 | 54.94 % |
| F | 168 mm | 27.74 % | 40.19 % | 720 | 30.49 % |
| G | 147 mm | 13.07 % | 7.78 % | 361 | 78.36 % |
D'après la Figure 7 de l'article, CLEAR 2007, suivi visuel 3D multi-personnes.
Commençons par MOTP. La plupart des systèmes ont une erreur de localisation moyenne inférieure à 20 cm, ce qui semble très précis, d'autant que la position réelle, obtenue en projetant le centre de la tête sur le sol, n'est elle-même annotée qu'à 5 à 8 cm près. Mais les auteurs préviennent que le seuil de 50 cm empêche MOTP de beaucoup grimper ; tout ce qui dépasse 50 cm est écarté comme détection manquée, et même si les erreurs se répartissaient uniformément sous le seuil, MOTP ne vaudrait que 25 cm. Vu sous cet angle, les 222 mm de E ne sont en réalité pas très précis, alors que les 91 mm de B sont remarquablement précis.
Passons à MOTA. Le meilleur, G, est à 78 %, le pire, F, à 30 % ; ça se voit au premier coup d'œil. Mais A, B et C utilisent des caractéristiques et des algorithmes très différents, et leur MOTA tourne pourtant autour de 59.6 %.
À ne regarder que MOTA, ces trois systèmes se valent. Si l'on décompose le score, B a les positions les plus précises et le moins de faux positifs, mais le plus de détections manquées, et plus de deux fois plus d'erreurs d'appariement que C ; C manque peu, a beaucoup de faux positifs et peu d'erreurs d'appariement. Les deux traqueurs ont des points forts complètement différents. Il a donc finalement été décidé de publier, en plus de MOTP et de MOTA, leurs trois composantes : détections manquées, faux positifs et erreurs d'appariement.
Des erreurs d'appariement trop bon marché
Dans le tableau, les erreurs d'appariement sont des décomptes, pas des taux. Derrière ce choix se cache un problème que les auteurs avaient repéré dès 2006, et qui n'était toujours pas résolu à la publication de l'article.
Les séquences de CLEAR durent chacune plusieurs minutes, et ne sont annotées qu'une fois par seconde. Pour un traqueur raisonnable, le nombre d'erreurs d'appariement est dérisoire comparé au nombre total d'objets réels ; le taux d'erreurs d'appariement est généralement inférieur à 2 %, alors que les détections manquées et les faux positifs atteignent 20 à 40 %. Manquer quelqu'un pendant un court moment coûte plus de points que plusieurs changements d'identifiant, et les erreurs d'identité pèsent très peu sur MOTA.
Les auteurs ne tranchent pas. Savoir si une erreur d'identité est une faute plus légère dépend de l'application ; mais le consensus des ateliers d'évaluation était de donner davantage de poids aux erreurs d'identité, par exemple en passant à des mesures d'erreur fondées sur des trajectoires entières, pour sortir d'une situation dominée par les détections manquées et les faux positifs comptés image par image.
Ces lignes datent de 2008. Huit ans plus tard, IDF1 apparie des trajectoires entières ; quatre ans après encore, HOTA sépare détection et association en deux scores. C'est exactement ce qui était demandé.
Plus tard, MOTChallenge annote chaque image. Ce qui suit relève de la conjecture de cette note. Si chaque image est annotée, les détections manquées et les faux positifs augmentent proportionnellement au nombre d'images, alors qu'un échange d'identité ne compte toujours qu'une fois ; le déséquilibre que CLEAR voyait déjà ne peut que s'aggraver. L'exemple de l'article HOTA, où « trois changements d'identité ne coûtent que 3 points », en est le reflet en miniature.
Le seuil décide de tout
Le paramètre pèse lui aussi très lourd. Avec infini, une correspondance reste valide pour toujours une fois établie, aussi loin que l'hypothèse dérive ; MOTA se réduit à vérifier que « le nombre d'objets est juste », et MOTP ne sert plus à rien. Quand tend vers zéro, tous les objets finissent comptés comme détections manquées, et aucune des deux métriques n'a plus de sens.
Les 50 cm ont été fixés à l'intuition, avec des résultats plutôt raisonnables. Quant à la façon de choisir le seuil optimal, les auteurs disent que la question reste ouverte.
Pourquoi MOTA peut être négatif
En 2006, le suivi 3D d'une seule personne ne suivait que l'orateur sur l'estrade. Le pire système du tableau, A, obtient un MOTA de .
Son erreur de localisation moyenne est de 246 mm ; la part de détections manquées dues à une distance supérieure à 50 cm atteint 88.75 %, alors que les vraies détections manquées, faute d'hypothèse produite, ne sont que de 2.28 %.
Voilà pourquoi MOTA devient négatif. Chaque fois que l'erreur de localisation dépasse le seuil, l'objet compte pour une détection manquée et l'hypothèse pour un faux positif ; la même erreur est pénalisée deux fois.
Les auteurs disent que c'est voulu. Certains traqueurs s'appuient sur leur niveau de confiance pour ne rien produire du tout quand leur estimation est mauvaise ; d'autres continuent de produire des positions fausses. Les premiers devraient être mieux notés. Pour reprendre l'article, un traqueur qui ne détecte pas l'orateur pendant la moitié de la séquence fait mieux qu'un traqueur qui, pendant la même durée, suit obstinément un tableau noir vide.
Les types d'erreurs comptent, certes, mais la façon de compter les erreurs au fil de la séquence influe tout autant sur le comportement de la métrique ; c'est l'observation la plus importante de l'article.
Il en va de même pour le suivi acoustique ; le meilleur système, G, obtient un A-MOTA de 54.63 %, et le pire, B, de . Quant au suivi de visages de 2007, les MOTP (recouvrement des boîtes) des deux systèmes sont de 0.66 et 0.68 ; une fois le visage trouvé, leurs boîtes sont aussi précises l'une que l'autre. Leurs MOTA, eux, sont de 33.07 % contre 68.81 %, et toute la différence tient à trouver le visage et à ne plus le lâcher.
Conclusion
Avec une procédure d'appariement explicite, cet article range les erreurs du suivi multi-objets en trois catégories, détections manquées, faux positifs et erreurs d'appariement, puis les résume en deux nombres : MOTP mesure la précision des positions estimées, MOTA le nombre total d'erreurs.
Sa valeur tient à la procédure. Au-delà du seuil, pas d'appariement ; un ancien appariement encore valide est prioritaire ; une erreur d'appariement ne compte qu'une fois, à l'image où la correspondance change ; on additionne d'abord, on divise ensuite. Derrière chaque règle se tient un contre-exemple concret.
Ses problèmes, les auteurs les ont vus eux aussi dans les évaluations de l'époque. Trois systèmes de styles complètement différents peuvent obtenir presque le même MOTA ; les erreurs d'appariement sont sans commune mesure avec les détections manquées et les faux positifs, si bien qu'une erreur d'identité ne change presque rien au score ; et le choix du seuil reste sans réponse. MOTChallenge a ensuite fixé le seuil à un IoU de 0.5 pour tout le monde ; quant au poids des erreurs d'identité, il a fallu attendre IDF1 et HOTA pour que quelqu'un s'y attaque de front.
La prochaine fois que vous voyez un MOTA négatif, ne soupçonnez pas trop vite un bug dans le code d'évaluation. L'article le disait déjà ; un traqueur qui court après un tableau noir doit faire moins bien qu'un traqueur qui ne produit rien du tout.