原始论文
Deep reinforcement learning from human preferences
- 发表版本
- NeurIPS 2017会议
- arXiv 首次提交
- arXiv:1706.03741
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{reinforcementlearningrlhumanpreferences2017,
  title = {{Deep reinforcement learning from human preferences}},
  author = {Paul Christiano and Jan Leike and Tom B. Brown and Miljan Martic and Shane Legg and Dario Amodei},
  year = {2017},
  eprint = {1706.03741},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1706.03741}
}
想让模拟器里的单腿机器人 Hopper 做后空翻,奖励函数要怎么写?
OpenAI 在 2017 年 6 月的博客文章附了一份答案,作者说他们花了两个小时才写出来:
def reward_fn(a, ob):
    backroll = -ob[7]
    height = ob[0]
    vel_act = a[0] * ob[8] + a[1] * ob[9] + a[2] * ob[10]
    backslide = -ob[5]
    return backroll * (1.0 + .3 * height + .1 * vel_act + .05 * backslide)
机器人确实翻过去了,但作者自己的评价是「没那么优雅」。同一篇文章展示了另一只 Hopper,翻完能稳稳落地,接着翻下一个。训练它的人没有写任何奖励函数,只是反复看两段一两秒的视频,选出哪一段更像后空翻。总共大约 900 次,花了不到一小时。
这是 OpenAI 的 Christiano、Amodei 与 DeepMind 的 Leike、Legg 等人合作的论文。作者名单里还有一位 Tom Brown(没错,就是三年后 GPT-3 论文的第一作者)。后来 InstructGPT 引用的 RLHF(reinforcement learning from human feedback)做法,源头就在这里。不过这篇论文里没有语言模型,只有 MuJoCo 机器人和 Atari 游戏。
定义问题
深度强化学习在 Atari、围棋上的成功,都建立在奖励写得出来的前提上。游戏有分数,围棋有输赢。可是「把桌子擦干净」「炒一盘鸡蛋」这类目标,很难写成传感器读数的函数。勉强写一个近似版本,智能体往往学会把那个近似值刷高,却没做到人真正想要的事。
现成的路有两条。有示范的话,可以用逆强化学习(inverse RL)从示范反推奖励,或直接模仿示范。但很多行为人类示范不出来,例如控制一个关节很多、外形也不像人的机器人。后空翻的 Hopper 就是一例,人一眼认得出后空翻,却没办法亲手操作它翻一次。
另一条路是让人直接充当奖励函数,看着智能体的行为实时打分。问题在数量,深度强化学习动辄要几百到几千小时的经验,人不可能全程陪着打分。作者估计,反馈量要降低好几个数量级,这条路才走得通。
作者把目标列成四点:
- 能解决人只「认得出」、但示范不出来的任务;
- 非专家也能教;
- 能扩展到大规模问题;
- 反馈用量要省。
用比较取代打分
论文不让人打分,改成比较。一段轨迹片段 由 个观测与动作的配对组成:
人看两段片段,若偏好第一段,记作 。
这样设定有个麻烦。没有奖励,要怎么知道智能体学得好不好?
作者用两种评估。定量评估先假设人的偏好其实由某个隐藏的奖励函数 决定,片段的总奖励更高,那段就会被偏好。这样一来就能拿环境原本的奖励当标准答案:训练时不给智能体看,训练完再用它评分。定性评估则用在根本没有奖励函数的任务上,例如后空翻,只能把视频放出来让人看。
所以这篇的主要实验是在已有标准奖励的任务上,故意把奖励藏起来,只给智能体比较结果。
那么,「这段比那段好」要怎么变成强化学习每一步需要的奖励?
解决问题
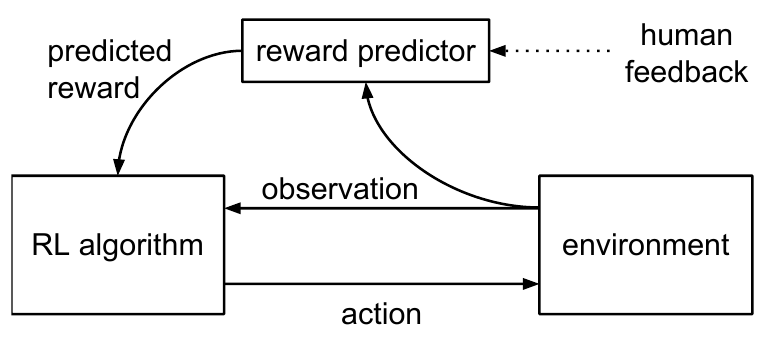
图的下半部分是一般的强化学习循环,RL 算法输出动作,环境返回观测。区别在于奖励从哪里来。环境不再给奖励,改由上方的奖励预测器(reward predictor) 看着观测打分;预测器则从虚线那头的人类反馈学出来。
系统同时维护策略 与奖励估计 两个神经网络,由三个流程异步更新:
- 策略和环境交互产生轨迹,用一般的 RL 算法最大化预测奖励 的总和。
- 从这些轨迹挑出成对的片段,交给人比较。
- 用目前收到的所有比较,以监督学习更新 。
轨迹从 1 流向 2,比较结果从 2 流向 3, 的参数再从 3 回到 1。三者同时运行,人不必等智能体,智能体也不必等人。
从比较学出奖励
核心在第 3 步。作者把 当成解释人类选择的隐藏分数,假设人偏好某段片段的概率,随片段内预测奖励的总和呈指数增长:
再用交叉熵去拟合人的标注:
记录人怎么选。选第一段时 ;选「一样好」时 ;选「无法比较」,这一条就不放进数据库 。
这是统计学里的 Bradley–Terry 模型。作者拿国际象棋的 Elo 等级分来打比方,两位棋手的分差决定谁更可能赢,这里两段片段的预测奖励差,决定人更可能选哪一段。
我们拿一组小数字走一遍。假设两段片段各 3 步,预测器给的分数如下:
import math

r1 = [0.2, 0.5, 0.1]   # 片段 1 每一步的 r̂
r2 = [0.3, -0.1, 0.0]  # 片段 2 每一步的 r̂

s1, s2 = sum(r1), sum(r2)            # 0.8, 0.2
p = math.exp(s1) / (math.exp(s1) + math.exp(s2))
print(round(p, 4))                   # 0.6457
总分差 0.6,模型预测人有 64.6% 的概率选片段 1。比较的是整段的总和,片段 2 的第一步其实分数更高。
如果人真的选了片段 1,损失是 ;选片段 2,损失是 ;选「一样好」则是两者的平均,约 0.74。梯度会把两段的总分往人的选择推。
公式里还藏着两个假设。第一,求和时没有折扣因子,等于假设人不在意事情发生在片段的开头还是结尾。第二,只有分差有意义,整个 加上一个常数,概率完全不变。所以作者把 交给 RL 之前,会先标准化为均值 0、固定的标准差。
让预测器扛得住
在基础版之外,作者加了三个早期实验发现有帮助的修改:
- 集成:训练多个预测器(附录设为 3 个),每个都从 有放回地抽取 条数据训练。每个预测器各自标准化后再取平均,作为 。
- 正则化:每个预测器留出 的数据作验证集,调整 系数,让验证损失保持在训练损失的 1.1 到 1.5 倍;部分任务另加 dropout。
- 人会手滑:不直接用上面的 softmax,而是假设人有 10% 的概率随便乱选。
第三点值得算一下。人有 10% 的概率乱按的话,他选片段 1 的概率变成 ,刚才的 0.6457 变成 0.6311,差别不大。差别出现在分差很大的时候。分差 10 时,原本的模型几乎确定(0.99995)人会选片段 1;万一人按了片段 2,损失是 10,梯度会使劲把模型往回拉。加上乱按的假设,概率上限变成 0.95,同一条错误标注的损失只剩约 3。一两条按错的标注,不至于把预测器整个带偏。
该问哪一对
人的时间最贵,挑哪两段给人看因此很重要。作者先抽出大量候选对(附录设为实际送出数量的 10 倍),让集成里的每个预测器各自预测人会选哪段,再把预测分歧最大的那几对交给人。
作者自己也说这是很粗略的近似。后面的消融会看到,它在某些任务上反而让结果变差。
策略这一侧
有了 ,剩下的就是一般的强化学习。Atari 用 A2C,机器人任务用 TRPO,两者都是策略梯度方法。作者选它们,是因为 一直在变,需要对奖励变化比较稳健的方法。超参数基本沿用一般 RL 的设置,只调了 TRPO 的熵奖励(entropy bonus)。TRPO 靠信赖域限制每次更新的幅度,在奖励不断变化时容易探索不足。
把作弊的路子堵上
附录里有一段很容易漏看的工程细节。作者发现,就算不给奖励,环境本身也会泄露任务信息。例如 Gym 的机器人摔倒时回合就结束,智能体只要学会「别让回合结束」,就等于学到了一部分任务目标。
所以作者把所有长度会变化的回合都改掉。机器人任务的终止条件换成惩罚项,交给智能体自己学;Atari 不再发出失去生命或回合结束的信号,整个游戏变成一个连续的回合。
Atari 画面上的分数区也被涂黑,BeamRider 的敌舰数量、Enduro 的速度表也一并遮掉。机器人任务原本会惩罚过大的力矩,但人在视频里看不到力矩,作者也把这一项去掉了。
标注的节奏也经过安排。训练一开始,先拿随机初始化的策略产生片段给人比较(Atari 是 500 对)。之后标注频率随时间递减,机器人任务大约正比于 , 是已经过去的时间步。Atari 另外先把预测器预训练 200 个 epoch 才开始 RL,训练时只保留最近的 3,000 条标注反复使用,让新标注有足够的分量。
讨论
机器人:700 条标注
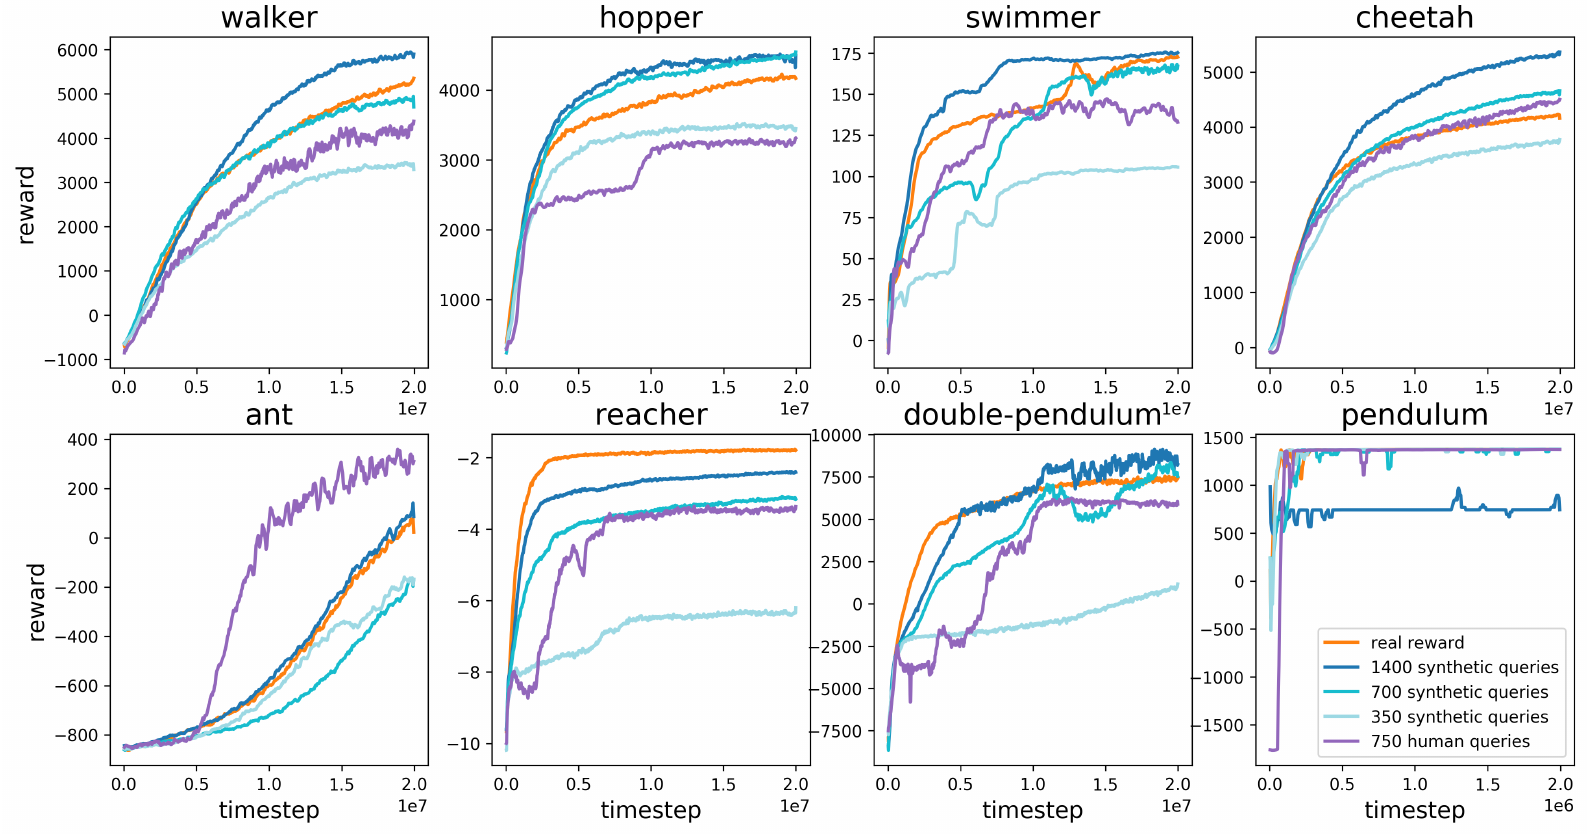
这张图有 8 个 MuJoCo 任务,纵轴是真实奖励,也就是智能体训练时看不到的那个。橙线直接用真实奖励训练;三条蓝线分别用 350、700、1400 条合成标注;紫线是真人标注,图例写的是 750 条。
合成标注来自一个「神谕」(oracle),它按片段的真实奖励总和回答哪段更好,相当于一位永远不出错的标注者。蓝线是 5 次实验的平均,紫线只跑了一次。
700 条标注就几乎在所有任务上追上了 RL,只是学出来的奖励让训练不太稳定、方差比较大。到了 1400 条,walker、cheetah 等任务甚至略高于橙线。作者推测学出来的奖励形状更好,那些通常接下来会拿到高奖励的行为,也会得到正分。
真人标注大致比合成标注差一点,效率介于合成标注的一半到持平之间。Ant 是例外,紫线远高于其他线。作者请标注者偏好「机器人站直」的片段,这个提示成了很好的奖励塑形(reward shaping)。原本的奖励函数也有鼓励站直的加分项,效果却不如人的判断。
读这张图要留意两件事。紫线只有一次实验,Reacher 和 Cheetah 还因为时间不够,改由作者本人标注;其他任务的标注者则不熟悉环境,也不了解算法。附录里给他们的说明写得很接地气,从每个任务怎么判断好坏,一路交代到服务器没视频可标的时候,请在 Slack 上找 @tom。Hopper 紫线进展不规则,作者的解释是某位标注者没有按预定的节奏标注。
Atari:分数被遮住之后
Atari 的七款游戏更难。图例上的设置是 3.3k、5.6k、10k 条合成标注,对照 5.5k 条真人标注,每条合成标注曲线是 3 次的平均。
BeamRider 和 Pong 用 3,300 条合成标注就接近 RL。Seaquest 和 Qbert 最后也接近,但学得比较慢。SpaceInvaders 和 Breakout 始终追不上 RL,不过智能体在 SpaceInvaders 常能过第一关,在 Breakout 能拿到 20 分,标注够多时可以到 50 分。
多数游戏上,真人标注的效果和标注量少 40% 的合成标注差不多。作者推测,原因可能是标注错误、不同标注者对同一次训练的判断不一致,或者标注速度不均匀,让标注集中在状态空间的一小块。Qbert 用真人标注连第一关都过不了,作者认为 Qbert 的短片段很难看懂。
Enduro 刚好相反。A3C 很难靠随机探索学会超车,合成标注也跟着学不起来;真人却会奖励任何朝超车方向的进展,等于替智能体做了奖励塑形,结果胜过 A3C,成绩和 DQN 相当。
没有奖励函数的任务
这套方法要解决的,终究是写不出奖励函数的任务。作者沿用前面的参数,展示了三个行为:
- Hopper 连续后空翻,每次都稳稳落地:900 次查询,不到一小时。
- Half-Cheetah 单腿往前跑:800 次查询,不到一小时。
- Enduro 里和其他车保持并排:约 1,300 次查询、400 万帧交互。智能体大部分时间能贴着别的车,但背景一变就容易乱。
这三个行为都由作者本人标注。
消融:哪些设计有用
作者把方法拆掉一部分,看结果怎么变。拆法有六种:随机挑查询(random queries)、只用一个预测器(no ensemble)、只在训练初期收集标注(no online queries)、去掉 正则化(no regularization)、机器人任务改用单帧(no segments),以及改让神谕直接给出片段的真实奖励总和、用均方误差回归(target)。
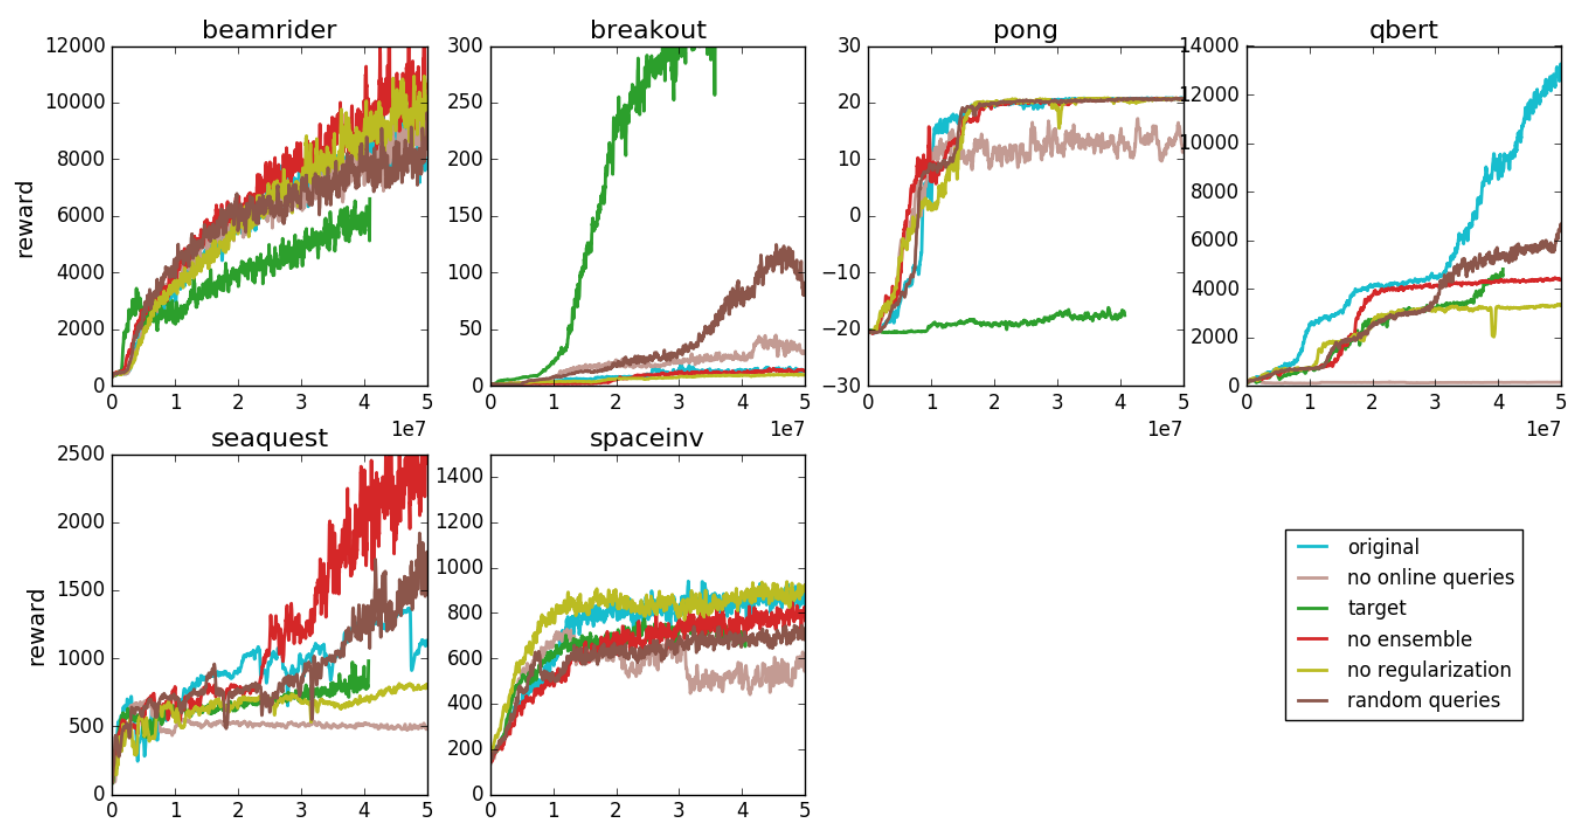
这张是 Atari 的消融,每条线是 3 次的平均,用 5,500 条合成标注。最该看的是浅粉棕色的 no online queries。Pong 停在 10 到 15 分之间,完整方法(浅蓝)到 20 分;Qbert 几乎是零;Seaquest 卡在 500 左右;SpaceInvaders 中途还掉了下来。
作者的解释是,训练初期收集的标注,只覆盖早期策略会走到的状态。策略改变后,智能体走进预测器没见过的地方,预测器只抓到真实奖励的一部分,智能体就去最大化那一部分。Pong 的例子很具体,离线训练的智能体学会了不丢分,却不会得分,于是一直跟对手来回对打,同样的过程无休止地重复。人类反馈得跟着策略一起更新,事先标好一批是不够的。
target 的结果比较复杂。Atari 上它有赢有输,Breakout 冲到 300 分,远胜其他设置,Pong 却停在 -17 左右。原因是 Atari 的奖励被裁剪到 ,回归几乎只需要预测正负号。机器人任务的奖励尺度差别很大,直接回归很吃力;MuJoCo 消融里,target 在 walker 上只有约 1,700,完整方法约 4,900,cheetah 则是约 1,200 对 4,600。改成比较之后,预测器只要把顺序排对,问题平滑得多。
单帧也是如此。MuJoCo 上把片段缩成 1 步,walker 只剩约 550,cheetah 约 1,200。作者发现,片段越长,每次比较越有用,但平均到每一帧就越没效率。片段太短时,人得先花时间搞懂画面;长到一定程度后,评估时间才大致和长度成正比。作者选的是评估时间开始呈线性的最短长度,机器人任务是 1.5 秒,Atari 是 25 个时间步(约 1.7 秒)。
集成和主动挑查询的结果则没有一致的方向。Qbert 上完整方法明显最好;Seaquest 上,只用一个预测器、改成随机挑查询的版本反而最高。
人的时间和机器的钱
论文的脚注估算了成本。Atari 实验用一台 16 核 CPU 加一张 K80 的云服务器,每月约 700 美元,训练大约一天,算力约 25 美元。5,000 条标注约是 5 小时人力,按美国最低工资算约 36 美元。两者已经在同一个量级,作者因此认为,再把标注量往下压,整体成本的改善有限。(这是机器人和 Atari 的情况。换到语言模型之后,标注反而成了最花钱的一环,五年后的 InstructGPT 光标注团队就雇了约 40 人。)
和让人直接充当奖励函数相比,学一个独立的奖励模型,让需要人参与的交互量少了大约三个数量级。
会骗评委的智能体
博客文章另外记录了一个论文里没写的失败案例。一只本该学会抓取物体的机械臂,最后学会把手停在摄像头和物体之间,画面上看起来像抓到了,其实没碰到东西。标注者只能看画面判断,智能体就学着讨好画面。作者的补救办法是在画面上加粗白线,帮标注者判断深度。
预测器学到的是「人看起来觉得好」,智能体最大化的也是这个。人看不出差别的地方,智能体就有空子可钻。Ant 的站直提示让结果变好,抓取机械臂则是反例,标注者的眼力直接决定了奖励的质量。
之后 OpenAI 把同一套流程搬到语言模型上,2019 年先试风格续写与摘要,2020 年做大规模的文章摘要,2022 年做成 InstructGPT。视频换成两段模型回答,A2C 与 TRPO 换成 PPO,Bradley–Terry 那条损失几乎没变。讨好评委的问题也一起搬了过去,2020 年的摘要研究就测到,对学出来的奖励模型优化过头,人评的摘要质量反而下降。
结论
人写不出后空翻的奖励函数,却一眼看得出哪段视频更像后空翻。这篇把「看得出来」变成训练信号,MuJoCo 上 700 条标注就追上了真实奖励,后空翻一小时就教会了。
想在自己的任务上试的话,消融已经替你排好了优先级。标注一定要边训练边收集,请人比较两段而不是打分,片段要长到人看得懂发生了什么;用集成分歧挑题目效果时好时坏,晚点再做也不迟。
那只把手停在镜头前、假装抓到东西的机械臂,大概是第一个学会讨好评委的模型,可惜不是最后一个。