原始論文
Deep reinforcement learning from human preferences
- 發表版本
- NeurIPS 2017會議
- arXiv 首次提交
- arXiv:1706.03741
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{reinforcementlearningrlhumanpreferences2017,
  title = {{Deep reinforcement learning from human preferences}},
  author = {Paul Christiano and Jan Leike and Tom B. Brown and Miljan Martic and Shane Legg and Dario Amodei},
  year = {2017},
  eprint = {1706.03741},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1706.03741}
}
想讓模擬器裡的單腳機器人 Hopper 做後空翻,獎勵函數要怎麼寫?
OpenAI 在 2017 年 6 月的部落格文章附了一份答案,作者說他們花了兩個小時才寫出來:
def reward_fn(a, ob):
    backroll = -ob[7]
    height = ob[0]
    vel_act = a[0] * ob[8] + a[1] * ob[9] + a[2] * ob[10]
    backslide = -ob[5]
    return backroll * (1.0 + .3 * height + .1 * vel_act + .05 * backslide)
機器人確實翻過去了,但作者自己的評語是「沒那麼優雅」。同一篇文章展示了另一隻 Hopper,翻完能穩穩落地,接著翻下一次。訓練它的人沒有寫任何獎勵函數,只是反覆看兩段一兩秒的影片,點選哪一段比較像後空翻。總共大約 900 次,花了不到一小時。
這是 OpenAI 的 Christiano、Amodei 與 DeepMind 的 Leike、Legg 等人合作的論文。作者名單裡還有一位 Tom Brown(對,就是三年後 GPT-3 論文的第一作者)。後來 InstructGPT 引用的 RLHF(reinforcement learning from human feedback)做法,源頭就在這裡。不過這篇論文裡沒有語言模型,只有 MuJoCo 機器人和 Atari 遊戲。
定義問題
深度強化學習在 Atari、圍棋上的成功,都建立在獎勵寫得出來的前提上。遊戲有分數,圍棋有輸贏。可是「把桌子擦乾淨」「炒一盤蛋」這類目標,很難寫成感測器讀數的函數。勉強寫一個近似版本,代理往往學會把那個近似值衝高,卻沒做到人真正想要的事。
現成的路有兩條。有示範的話,可以用逆強化學習(inverse RL)從示範反推獎勵,或直接模仿示範。但很多行為人類示範不出來,例如控制一隻關節很多、外型也不像人的機器人。後空翻的 Hopper 就是一例,人一眼認得出後空翻,卻沒辦法親手操作它翻一次。
另一條路是讓人直接當獎勵函數,看著代理的行為即時打分。問題在數量,深度強化學習動輒要幾百到幾千小時的經驗,人不可能全程陪著打分。作者估計,回饋量要降低好幾個數量級,這條路才走得通。
作者把目標列成四點:
- 能解決人只「認得出」、但示範不出來的任務;
- 非專家也能教;
- 能擴展到大型問題;
- 回饋用量要省。
用比較取代打分
論文不讓人打分數,改成比較。一段軌跡片段 是 個觀測與動作的配對:
人看兩段片段,若偏好第一段,記成 。
這樣設定有個麻煩。沒有獎勵,要怎麼知道代理學得好不好?
作者用兩種評估。量化評估先假設人的偏好其實由某個隱藏的獎勵函數 決定,片段的總獎勵比較高,那段就會被偏好。如此一來就能拿環境原本的獎勵當標準答案:訓練時不給代理看,訓練完再用它評分。質化評估則用在根本沒有獎勵函數的任務上,例如後空翻,只能把影片放出來讓人看。
所以這篇的主要實驗是在已有標準獎勵的任務上,故意把獎勵藏起來,只給代理比較結果。
那麼,「這段比那段好」要怎麼變成強化學習每一步需要的獎勵?
解決問題
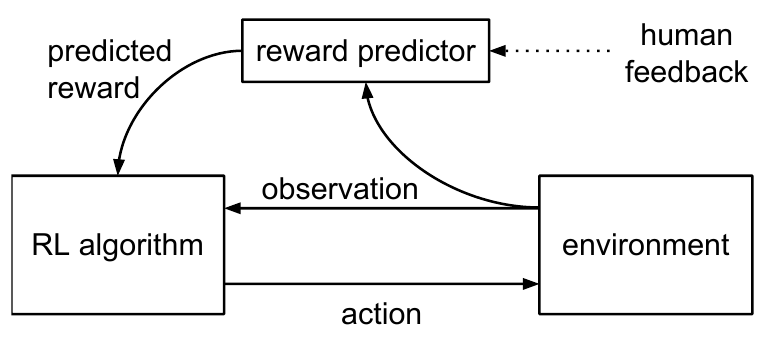
圖的下半部是一般的強化學習迴圈,RL 演算法送出動作,環境回傳觀測。差別在獎勵從哪裡來。環境不再給獎勵,改由上方的獎勵預測器(reward predictor) 看著觀測打分;預測器則從虛線那頭的人類回饋學出來。
系統同時維護策略 與獎勵估計 兩個神經網路,由三個流程非同步更新:
- 策略和環境互動產生軌跡,用一般的 RL 演算法最大化預測獎勵 的總和。
- 從這些軌跡挑出成對的片段,送給人比較。
- 用目前收到的所有比較,以監督式學習更新 。
軌跡從 1 流向 2,比較結果從 2 流向 3, 的參數再從 3 回到 1。三者同時跑,人不必等代理,代理也不必等人。
從比較學出獎勵
核心在第 3 步。作者把 當成解釋人類選擇的隱藏分數,假設人偏好某段片段的機率,隨片段內預測獎勵的總和呈指數增加:
再用交叉熵去擬合人的標註:
記錄人怎麼選。選第一段時 ;選「一樣好」時 ;選「無法比較」,這筆就不放進資料庫 。
這是統計學裡的 Bradley–Terry 模型。作者拿西洋棋的 Elo 等級分來比喻,兩位棋手的分差決定誰比較可能贏,這裡兩段片段的預測獎勵差,決定人比較可能選哪一段。
我們拿一組小數字走一遍。假設兩段片段各 3 步,預測器給的分數如下:
import math

r1 = [0.2, 0.5, 0.1]   # 片段 1 每一步的 r̂
r2 = [0.3, -0.1, 0.0]  # 片段 2 每一步的 r̂

s1, s2 = sum(r1), sum(r2)            # 0.8, 0.2
p = math.exp(s1) / (math.exp(s1) + math.exp(s2))
print(round(p, 4))                   # 0.6457
總分差 0.6,模型預測人有 64.6% 的機率選片段 1。比較的是整段的加總,片段 2 的第一步其實分數比較高。
如果人真的選了片段 1,損失是 ;選片段 2,損失是 ;按「一樣好」則是兩者平均,約 0.74。梯度會把兩段的總分往人的選擇推。
公式還藏著兩個假設。第一,加總時沒有折扣因子,等於假設人不在意事情發生在片段的開頭還是結尾。第二,只有分差有意義,整個 加上一個常數,機率完全不變。所以作者把 交給 RL 之前,會先正規化成平均 0、固定的標準差。
讓預測器撐得住
在基本版之外,作者加了三個早期實驗發現有幫助的修改:
- 集成:訓練多個預測器(附錄設定為 3 個),每個都從 有放回地抽 筆資料訓練。每個預測器各自正規化後再平均,當成 。
- 正則化:每個預測器保留 的資料作驗證集,調整 係數,讓驗證損失維持在訓練損失的 1.1 到 1.5 倍;部分任務另加 dropout。
- 人會手滑:不直接用上面的 softmax,而是假設人有 10% 的機率隨便亂選。
第三點值得算一下。人有 10% 機率亂按的話,他選片段 1 的機率變成 ,剛才的 0.6457 變成 0.6311,差別不大。差別出現在分差很大的時候。分差 10 時,原本的模型幾乎確定(0.99995)人會選片段 1;萬一人按了片段 2,損失是 10,梯度會用力把模型往回拉。加上亂按的假設,機率上限變成 0.95,同一筆錯誤標註的損失只剩約 3。一兩筆按錯的標註,不至於把預測器整個拉歪。
該問哪一對
人的時間最貴,挑哪兩段給人看因此很重要。作者先抽出大量候選配對(附錄設定為實際送出數量的 10 倍),讓集成裡的每個預測器各自預測人會選哪段,再把預測最分歧的那幾對送給人。
作者自己也說這是很粗略的近似。後面的消融會看到,它在某些任務上反而讓結果變差。
策略這一側
有了 ,剩下就是一般的強化學習。Atari 用 A2C,機器人任務用 TRPO,兩者都是策略梯度法。作者選它們,是因為 一直在變,需要對獎勵變動比較穩健的方法。超參數幾乎沿用一般 RL 的設定,只調了 TRPO 的熵獎勵(entropy bonus)。TRPO 靠信賴域限制每次更新的幅度,在獎勵不斷變動時容易探索不足。
把作弊的管道堵起來
附錄有一段很容易漏掉的工程細節。作者發現,就算不給獎勵,環境本身也會洩漏任務資訊。例如 Gym 的機器人跌倒時回合就結束,代理只要學會「別讓回合結束」,就等於學到一部分任務目標。
所以作者把所有長度會變動的回合都改掉。機器人任務的終止條件換成懲罰項,交給代理自己學;Atari 不再傳送失去生命或回合結束的訊號,整個遊戲變成一個連續的回合。
Atari 畫面上的分數區也被塗黑,BeamRider 的敵艦數量、Enduro 的速度表一併遮掉。機器人任務原本會懲罰過大的扭力,但人在影片上看不到扭力,作者也把這項拿掉。
標註的節奏也經過安排。訓練一開始,先拿隨機初始化的策略產生片段給人比較(Atari 是 500 對)。之後標註頻率隨時間遞減,機器人任務大約正比於 , 是已經過的時間步。Atari 另外先把預測器預訓練 200 個 epoch 才開始 RL,訓練時只保留最近的 3,000 筆標註反覆使用,讓新標註有足夠的份量。
討論
機器人:700 筆標註
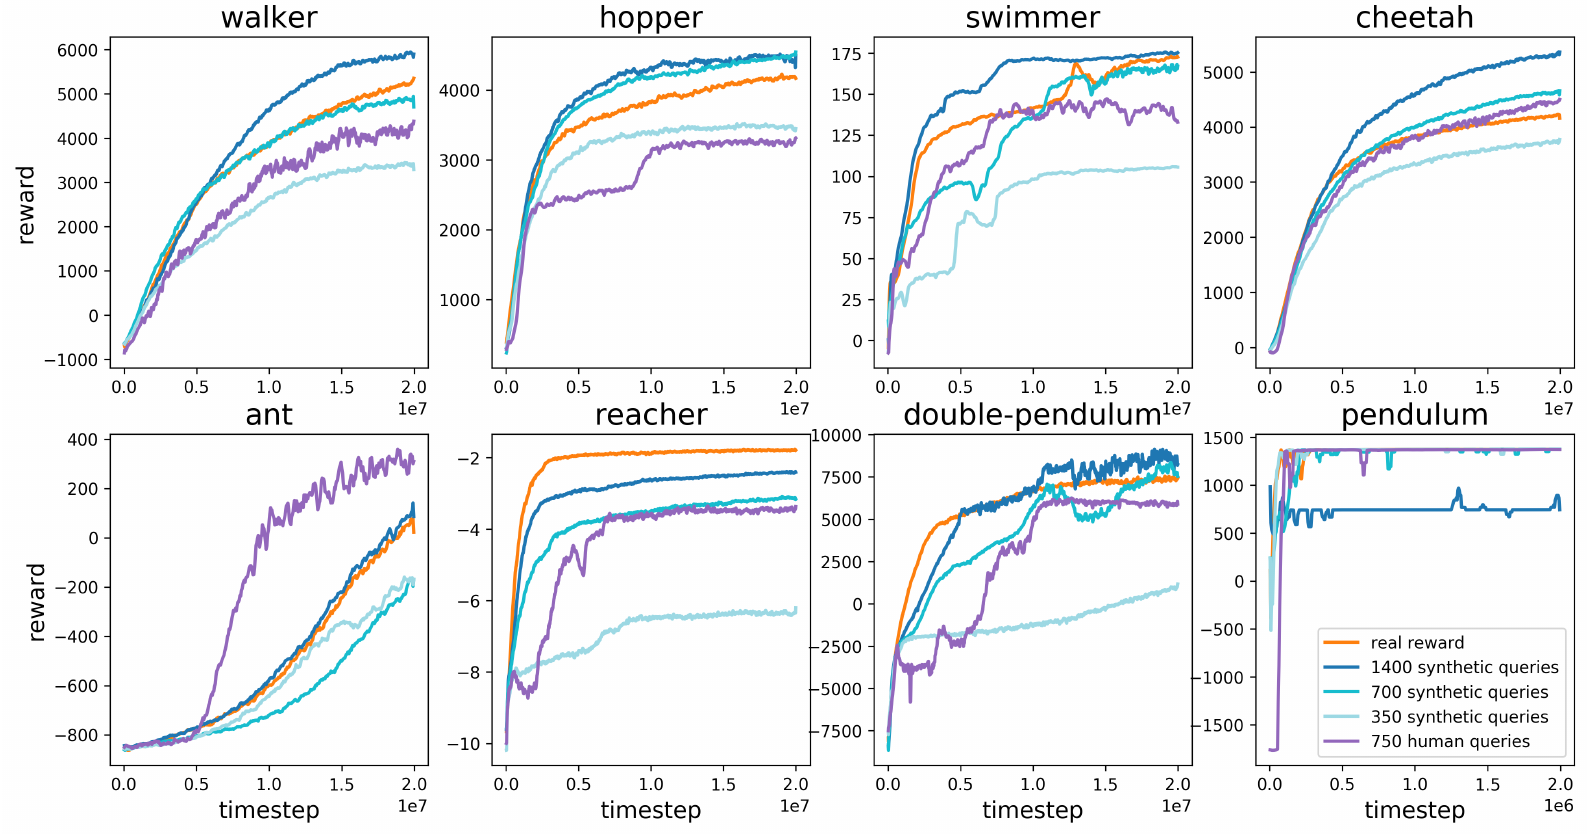
這張圖有 8 個 MuJoCo 任務,縱軸是真實獎勵,也就是代理訓練時看不到的那個。橘線直接用真實獎勵訓練;三條藍線分別用 350、700、1400 筆合成標註;紫線是真人標註,圖例寫 750 筆。
合成標註來自一個「神諭」(oracle),它按片段的真實獎勵總和回答哪段比較好,相當於一位永遠不出錯的標註者。藍線是 5 次實驗的平均,紫線只跑了一次。
700 筆標註就幾乎在所有任務上追到 RL,只是學出來的獎勵讓訓練比較不穩、變異比較大。到了 1400 筆,walker、cheetah 等任務甚至略高於橘線。作者推測學出來的獎勵形狀比較好,那些通常接著會拿到高獎勵的行為,也會被給正分。
真人標註大致比合成標註差一點,效率介於合成標註的一半到相同之間。Ant 是例外,紫線遠高於其他線。作者請標註者偏好「機器人站直」的片段,這個提示成了很好的獎勵塑形(reward shaping)。原本的獎勵函數也有鼓勵站直的加分項,效果不如人的判斷。
讀這張圖要留意兩件事。紫線只有一次實驗,Reacher 和 Cheetah 還因為時間不夠,改由作者本人標註;其他任務的標註者則不熟悉環境,也不了解演算法。附錄裡給他們的說明寫得很生活化,從每個任務怎麼判斷好壞,一路交代到伺服器沒影片可標的時候,請在 Slack 上找 @tom。Hopper 紫線的不規則進展,作者的解釋是某位標註者沒有照預定的節奏標註。
Atari:分數被遮住之後
Atari 的七款遊戲更難。圖例上的設定是 3.3k、5.6k、10k 筆合成標註,對照 5.5k 筆真人標註,每條合成標註曲線是 3 次平均。
BeamRider 和 Pong 用 3,300 筆合成標註就接近 RL。Seaquest 和 Qbert 最後也接近,但學得比較慢。SpaceInvaders 和 Breakout 始終追不上 RL,不過代理在 SpaceInvaders 常能過第一關,在 Breakout 能拿到 20 分,標註夠多時可到 50 分。
多數遊戲上,真人標註的效果和少 40% 標註量的合成標註差不多。作者推測,原因可能是標註錯誤、不同標註者對同一次訓練的判斷不一致,或標註速度不均,讓標註集中在狀態空間的一小塊。Qbert 用真人標註連第一關都過不了,作者認為 Qbert 的短片段很難看懂。
Enduro 剛好相反。A3C 很難靠隨機探索學會超車,合成標註也跟著學不起來;真人卻會獎勵任何往超車方向的進展,等於替代理做了獎勵塑形,結果勝過 A3C,成績和 DQN 相當。
沒有獎勵函數的任務
這套方法要解的,終究是寫不出獎勵函數的任務。作者沿用前面的參數,展示了三個行為:
- Hopper 連續後空翻,每次都站穩落地:900 次查詢,不到一小時。
- Half-Cheetah 單腳往前跑:800 次查詢,不到一小時。
- Enduro 裡和其他車保持並排:約 1,300 次查詢、400 萬幀互動。代理大部分時間能貼著別的車,但背景一變就容易混亂。
這三個行為都由作者本人標註。
消融:哪些設計有用
作者把方法拆掉一部分,看結果怎麼變。拆法有六種:隨機挑查詢(random queries)、只用一個預測器(no ensemble)、只在訓練初期收集標註(no online queries)、拿掉 正則化(no regularization)、機器人任務改用單一幀(no segments),以及改讓神諭直接給片段的真實獎勵總和、用均方誤差回歸(target)。
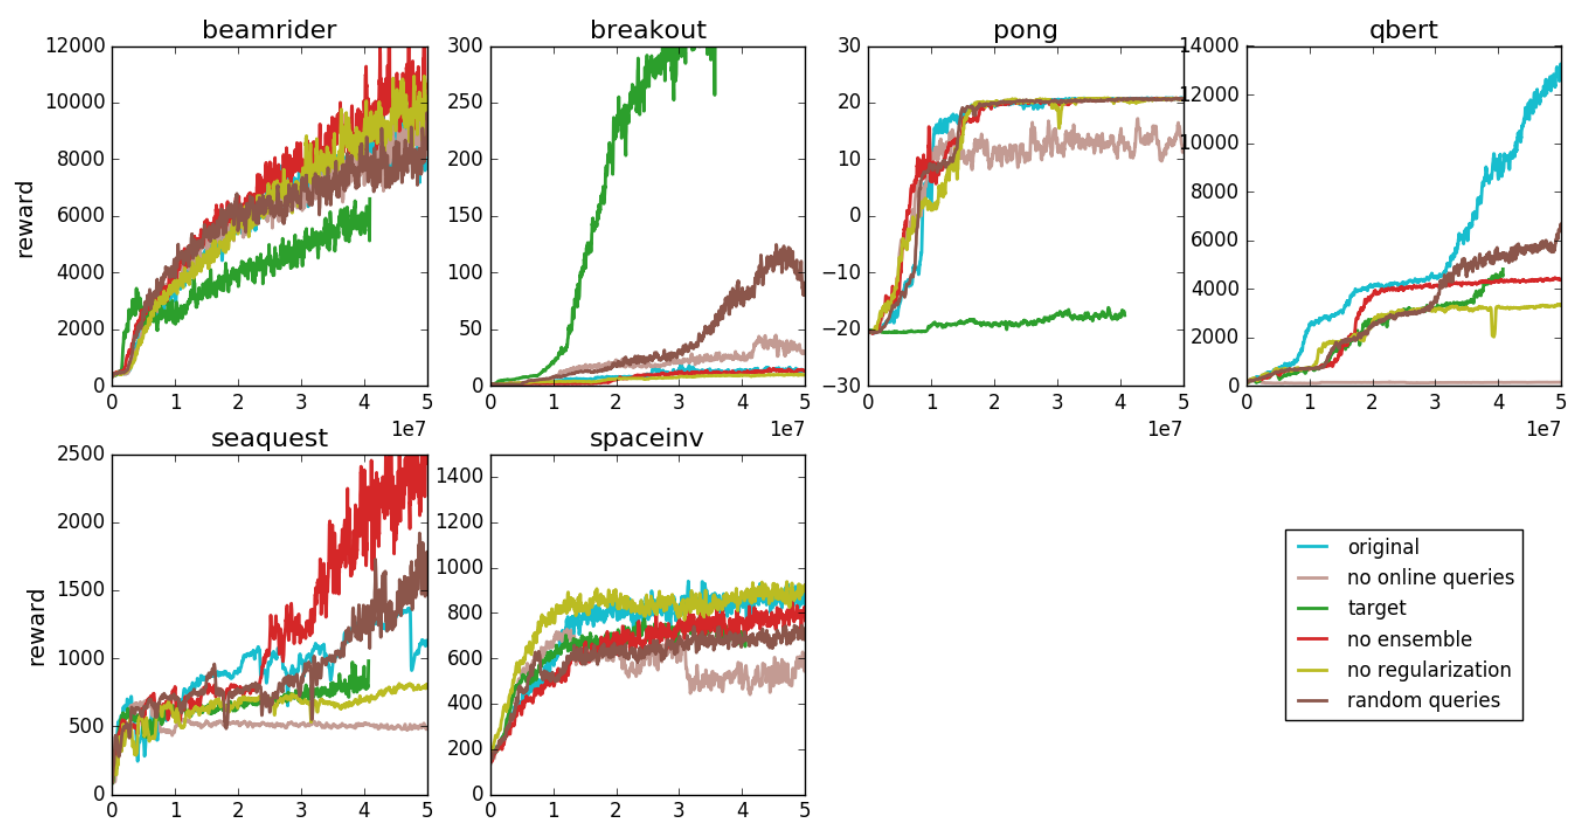
這張是 Atari 的消融,每條線是 3 次平均,用 5,500 筆合成標註。最該看的是淺粉棕色的 no online queries。Pong 停在 10 到 15 分之間,完整方法(淺藍)到 20 分;Qbert 幾乎是零;Seaquest 卡在 500 左右;SpaceInvaders 中途還掉下來。
作者的解釋是,訓練初期收集的標註,只涵蓋早期策略會走到的狀態。策略改變後,代理走進預測器沒見過的地方,預測器只抓到真實獎勵的一部分,代理就去最大化那一部分。Pong 的例子很具體,離線訓練的代理學會不失分,卻不會得分,於是一直跟對手來回對打,同樣的過程無止盡地重複。人類回饋得跟著策略一起更新,事先標好一批是不夠的。
target 的結果比較複雜。Atari 上它有贏有輸,Breakout 衝到 300 分,遠勝其他設定,Pong 卻停在 -17 左右。原因是 Atari 的獎勵被截斷到 ,回歸幾乎只需要預測正負號。機器人任務的獎勵尺度差很多,直接回歸很吃力;MuJoCo 消融裡,target 在 walker 上只有約 1,700,完整方法約 4,900,cheetah 則是約 1,200 對 4,600。改成比較之後,預測器只要把順序排對,問題平滑很多。
單一幀也是。MuJoCo 上把片段縮成 1 步,walker 只剩約 550,cheetah 約 1,200。作者發現,片段越長,每次比較越有用,但平均到每一幀就越沒效率。片段太短時,人得先花時間搞懂畫面;長到一定程度後,評估時間才大致和長度成正比。作者選的是評估時間開始呈線性的最短長度,機器人任務是 1.5 秒,Atari 是 25 個時間步(約 1.7 秒)。
集成和主動挑查詢的結果則沒有一致的方向。Qbert 上完整方法明顯最好;Seaquest 上,只用一個預測器、改成隨機挑查詢的版本反而最高。
人的時間和機器的錢
論文的註腳估了成本。Atari 實驗用一台 16 核 CPU 加一張 K80 的雲端機器,每月約 700 美元,訓練大約一天,算力約 25 美元。5,000 筆標註約是 5 小時人力,以美國最低工資計約 36 美元。兩者已經在同一個量級,作者因此認為,再把標註量往下壓,整體成本的改善有限。(這是機器人和 Atari 的情況。換到語言模型之後,標註反而成了最花錢的一段,五年後的 InstructGPT 光標註團隊就請了約 40 人。)
和讓人直接當獎勵函數相比,學一個獨立的獎勵模型,讓需要人參與的互動量少了大約三個數量級。
會騙評審的代理
部落格文章另外記了一個論文沒寫的失敗案例。一隻應該學會抓取物體的機械手臂,最後學會把手停在攝影機和物體之間,畫面上看起來像抓到了,其實沒碰到東西。標註者只能看畫面判斷,代理就學著討好畫面。作者的修補方式是在畫面上加上粗白線,幫標註者判斷深度。
預測器學到的是「人看起來覺得好」,代理最大化的也是這個。人看不出差別的地方,代理就有空間鑽。Ant 的站直提示讓結果變好,抓取手臂則是反例,標註者的眼力直接決定了獎勵的品質。
之後 OpenAI 把同一套流程搬到語言模型上,2019 年先試風格續寫與摘要,2020 年做大規模的文章摘要,2022 年做成 InstructGPT。影片換成兩段模型回答,A2C 與 TRPO 換成 PPO,Bradley–Terry 那條損失幾乎沒變。討好評審的問題也一起搬了過去,2020 年的摘要研究就量到,對學出來的獎勵模型最佳化過頭,人評的摘要品質反而下降。
結論
人寫不出後空翻的獎勵函數,卻一眼看得出哪段影片比較像後空翻。這篇把「看得出來」變成訓練訊號,MuJoCo 上 700 筆標註就追上真實獎勵,後空翻一小時就教會了。
想在自己的任務上試的話,消融已經替你排好優先順序。標註一定要邊訓練邊收,請人比較兩段而不是打分數,片段要長到人看得懂發生了什麼;用集成分歧挑題目效果時好時壞,晚點再做也不遲。
那隻把手停在鏡頭前、假裝抓到東西的機械手臂,大概是第一個學會討好評審的模型,可惜不是最後一個。