原始論文
Robust fine-tuning of zero-shot models
- 發表版本
- CVPR 2022會議
- arXiv 首次提交
- arXiv:2109.01903
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmergingwiseft2021,
  title = {{Robust fine-tuning of zero-shot models}},
  author = {Mitchell Wortsman and Gabriel Ilharco and Jong Wook Kim and Mike Li and Simon Kornblith and Rebecca Roelofs and Raphael Gontijo-Lopes and Hannaneh Hajishirzi and Ali Farhadi and Hongseok Namkoong and Ludwig Schmidt},
  year = {2021},
  eprint = {2109.01903},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2109.01903}
}
CLIP 剛出來的時候,大家最驚訝的一點是它的穩。
它還沒用 ImageNet 的標籤做任務微調,就能靠圖文預訓練學到的表示,把「a photo of a {類別}」的文字向量當成分類器,做零樣本分類。更特別的是,換到 ImageNet 的各種變體上,例如重新蒐集的 ImageNetV2、素描版的 ImageNet-Sketch、藝術風格的 ImageNet-R,它的準確率掉得比一般 ImageNet 模型少很多。
這份穩定,一微調就不見了。CLIP 原論文和 BASIC 的實驗都發現,在 ImageNet 上微調之後,ImageNet 本身的準確率大幅提升,好幾個分布偏移資料集上的準確率卻比零樣本模型還低。
華盛頓大學、OpenAI、Columbia、Google 與 AI2 等單位的 Wortsman、Ilharco 等人,想要兩者兼得。
定義問題
論文先引入一個量法,叫有效穩健性(effective robustness)。
把一堆在 ImageNet 上訓練的一般模型畫成散佈圖,橫軸是 ImageNet 準確率,縱軸是分布偏移資料集的平均準確率。這些點大致落在一條直線上(座標軸做過 logit 縮放)。有效穩健性就是一個模型高出這條線的距離:
是那條一般模型的趨勢線。零樣本 CLIP 落在另一條更高的線上,有效穩健性很大;微調之後,點往右移(ImageNet 變高),卻往下掉向一般模型那條線。
作者在微調時還觀察到兩個麻煩。第一,超參數稍微一變,偏移資料上的準確率就差很多,例如兩個學習率在 ImageNet 上只差 0.3 個百分點,偏移資料上卻差到 8 個百分點,而且光看 ImageNet 的表現挑不出來。第二,微調得越用力,例如學習率越大,ImageNet 進步越多,穩健性也掉得越多。
解決問題
兩步
WiSE-FT(weight-space ensembles for fine-tuning)只有兩步:
- 照一般方式微調零樣本模型。
- 把零樣本模型和微調後的模型,在權重空間線性混合:
是零樣本模型, 是微調後的模型,中間的值不需要再訓練,混出來就是一個模型,推論成本和原本一樣。
分類頭怎麼辦?
要混合,兩個模型的每一組權重都得對得上。CLIP 的零樣本分類器其實就是一個線性層 ,每一欄是一個類別描述「a photo of a {類別}」的文字向量;輸出是影像特徵和每一欄的內積。
端到端微調時,作者用這個零樣本分類器初始化最後的分類層,再連同影像編碼器一起訓練。兩個模型的結構和參數形狀完全相同,起點也相同,逐個權重混合就沒有問題。
實驗的分類頭還包含 CLIP 學到的溫度尺度,類別文字則用多種 prompt 的向量平均來建構,ImageNet 使用原作者提供的 80 種模板。做合併時,類別順序、特徵正規化與尺度都得沿用同一套定義。只確認矩陣都是 ,還沒確認第 欄是否仍然代表同一個類別。
把 LC 的情況攤開來算,固定影像表示 後:
等號右邊就是兩組 logits 的加權平均。例如某張圖的兩類分數分別是 和 , 時得到 ;把兩個分類頭先平均,會得到同樣的分數。先對各自 logits 做 softmax 再平均機率,則是另一個運算。
端到端微調會改變 ,上面那個分配律就不能把整個網路拆成兩個輸出。因此論文分開量權重平均與輸出集成。兩種方法都能改善穩健性,端到端的權重平均在比較中更有利,且只跑一個編碼器;輸出集成需要兩次影像編碼。LC 則可共用固定特徵,差別主要在分類頭的計算。
討論
散佈圖上的曲線
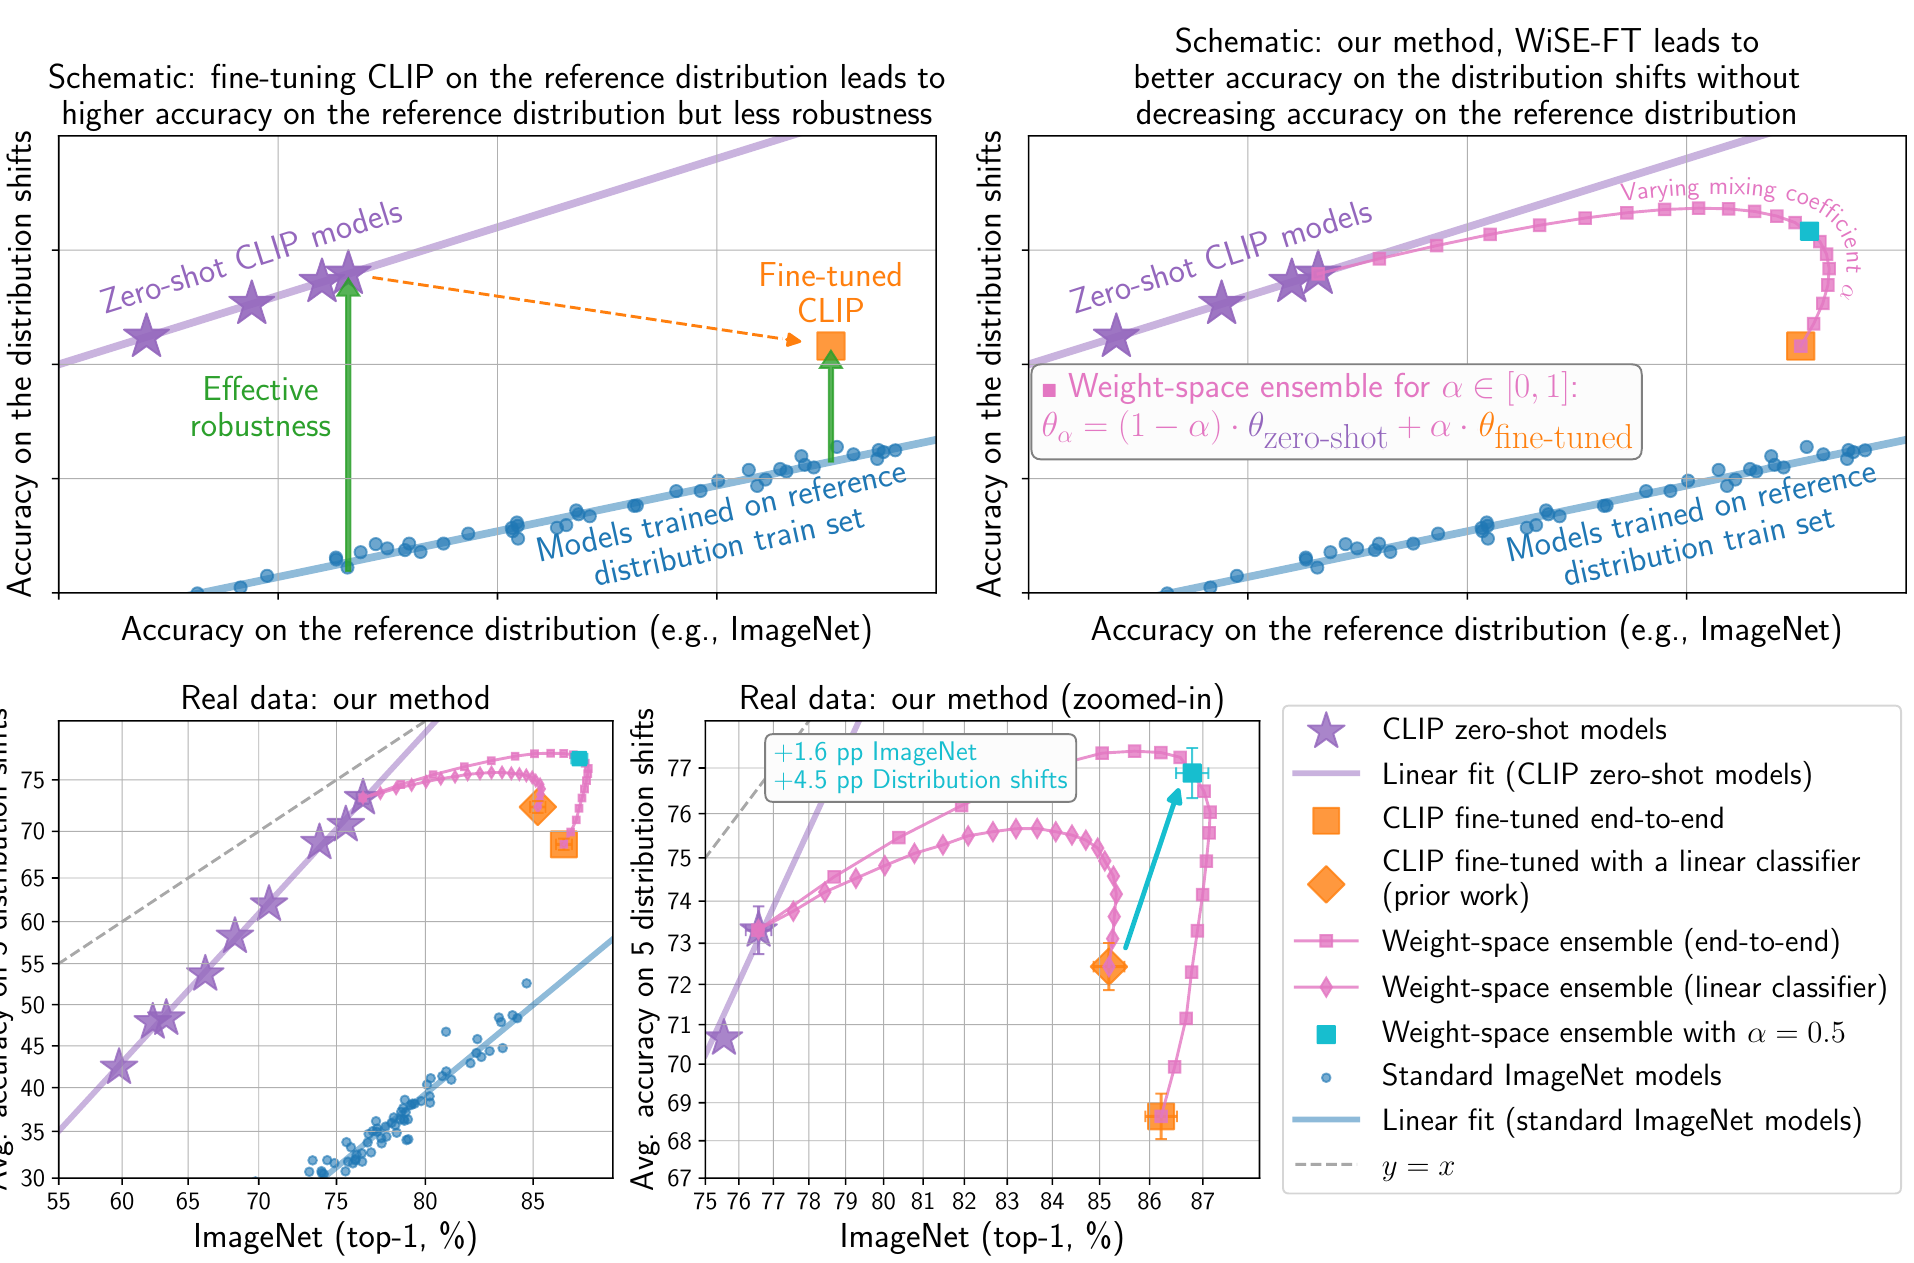
上排是示意。左圖裡,零樣本 CLIP(紫色星號)在一般模型的趨勢線上方,綠色箭頭的長度就是有效穩健性;微調後的 CLIP(橘色方塊)往右移,卻往下掉。右圖是 WiSE-FT, 從 0 調到 1,粉紅色的點畫出一條往右上拱起的曲線,中間有一段同時比兩端更右、更高。
下排換成真實資料,ViT-L/14@336px。右下的放大圖裡,粉紅色方塊是端到端微調的混合,從零樣本的紫色星號出發,往右上拱,最後才落回微調模型的橘色方塊。
數字
作者主要使用的 CLIP ViT-L/14@336px,在 ImageNet 與五個衍生的分布偏移資料集上:
| 模型 | ImageNet | 五個偏移資料集平均 |
|---|---|---|
| 零樣本(PyTorch 重現) | 76.6 | 73.4 |
| 微調線性分類器 | 85.2 | 72.6 |
| 端到端微調 | 86.2 | 68.6 |
| WiSE-FT,端到端, | 86.8 | 76.9 |
| WiSE-FT,端到端,每欄最佳的 | 87.1 | 77.4 |
準確率(%),整理自原論文 Table 1。最後一列的 各欄分別挑選。
端到端微調讓 ImageNet 從 76.6% 升到 86.2%,五個偏移資料集的平均卻從 73.4% 掉到 68.6%。WiSE-FT 取 ,ImageNet 是 86.8%,比端到端微調還高一點;偏移資料平均 76.9%,比零樣本模型也高。對照 CLIP 原論文的線性分類器微調,偏移資料集上高出 4 到 6 個百分點。
五個偏移資料集考的是不同變化。ImageNetV2 重新蒐集相近分布的照片;ImageNet-R 換成雕塑、繪畫等呈現,只有 200 個類別;Sketch 換成素描;ObjectNet 測不同背景與視角,和 ImageNet 重疊 113 類;ImageNet-A 則挑出一組原本會被 ResNet-50 誤判的自然影像,也涵蓋 200 類。評測要限制在各自對應的類別集合,不能把它們當成同一個一千類測試集。
| 資料集 | 零樣本 | 端到端微調 | WiSE-FT, |
|---|---|---|---|
| ImageNetV2 | 70.5 | 76.8 | 79.5 |
| ImageNet-R | 89.0 | 79.8 | 89.4 |
| ImageNet-Sketch | 60.9 | 57.9 | 64.7 |
| ObjectNet | 69.1 | 63.3 | 71.1 |
| ImageNet-A | 77.7 | 65.4 | 79.9 |
準確率(%),同一個 ViT-L/14@336px,整理自原論文 Table 1。
ImageNetV2 的微調本來就有幫助,混合後再進步;ImageNet-R 和 ImageNet-A 則先因微調掉了許多,再由混合拉回。只報五個資料集平均,會把這兩種情況混在一起。也別把每欄各選最佳 的一列當成同一個模型的成績,那一列包含各自對不同目標最有利的選擇。
結果不只在 CLIP 成立。作者在 ALIGN、BASIC 與 JFT 預訓練的 ViT 上看到類似的趨勢;另外六個分布偏移(WILDS 的衛星影像與野生動物相機、CIFAR-10.1 與 10.2、影片幀的擾動),以及七個一般的遷移學習資料集,WiSE-FT 也都有幫助,後者相對錯誤率降低 4% 到 49%。
超參數變簡單了
我們把散佈圖改成直接對 畫準確率。六張圖的橫軸都從零樣本的 0 走到微調後的 1,粉紅線是權重插值;斜虛線是把端點準確率線性混合的基準,水平虛線是兩端較好的那一個。
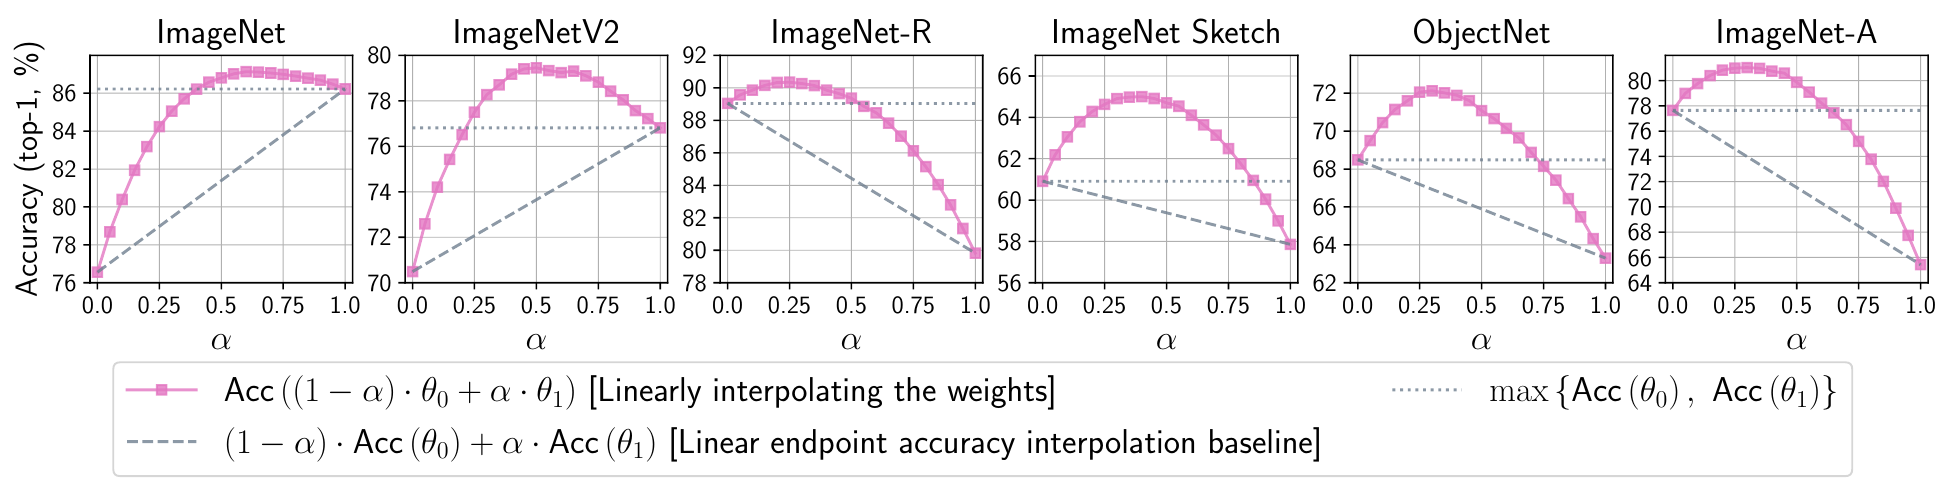
粉紅線在中間拱起,六個資料集各有一段超過兩個端點,最佳位置卻不完全一樣。它讓我們看到取捨曲線,也提醒我們單一最佳係數取決於要服務的資料。
回到前面的第一個麻煩。超參數變一點,偏移資料上的表現就差很多,而且從 ImageNet 看不出來。
WiSE-FT 把這個問題換成只調一個 。作者發現,即使用一個讓微調模型穩健性很差的學習率,套上 WiSE-FT 調整 ,也能在 ImageNet 與偏移資料之間拿回好的取捨;而且調 不需要重新訓練。在他們的實驗裡,能達到這條最佳曲線的方法,只有平均權重這一類,WiSE-FT 或對所有迭代點取指數移動平均。
不過 是好用的起點,副標題裡的「一半」也從這裡來,沒有推導要求它永遠最好。附錄比較過固定一半和各設定的最佳值,在 ImageNet 與五個偏移資料的綜合平均上,差距約 0 到 0.4 個百分點。若已有代表部署情境的驗證集,就沿插值線掃係數;每個候選仍要做前向評測,省下的是重新微調的時間。
互補究竟發生在哪裡
作者先在固定特徵的 LC 設定分析兩個分類器。除了計算預測分歧,也看分歧時哪個分類器決定集成結果。在 ImageNet 上,微調分類器較常占上風;在多數偏移資料上,零樣本分類器較常占上風,ImageNetV2 是例外。
這和分數的信心尺度有關。作者用最高與次高 logit 的差距當 margin,發現微調模型在參考分布上 margin 較大,零樣本模型在偏移資料上較大。當兩者對不同樣本各有擅長之處,加權的 logits 就有機會保留這種互補。這是 LC 的實驗分析,端到端微調還牽涉表示的變化,作者把後者留在誤差地形的經驗觀察。
其他基線也有認真比。作者掃過學習率、訓練長度、提早停止,以及向零樣本權重的 正則化;在 LC 設定還比過向零樣本輸出蒸餾、label smoothing、 與 weight decay。這些方法有的能取回部分穩健性,仍要重新訓練或選正則化強度。WiSE-FT 的實用處,是先把微調做完,再用便宜的權重插值調整取捨。
它處理的範圍也很具體。主結果針對自然分布偏移,沒有把對抗攻擊或所有未知分布都涵蓋進來;權重混合要求相容架構與類別語意。若兩個模型連編碼器都不同,就只能改比輸出層的集成,不能照抄這一行權重平均。
結論
WiSE-FT 的做法用一行公式就寫得完。微調完,往回走一半。
在這篇的設定裡,零樣本 CLIP 和微調後的 CLIP 共享預訓練權重,分類頭也從同一個零樣本分類器出發;沿線的實驗確認中間有好用的區域。拿自己的模型試時,先保留微調前的 checkpoint,再用驗證資料把那條線走一遍,通常比再猜一輪正則化係數省事。
同一組作者半年後又往前走了一步。被丟掉的那些不同超參數的微調模型,能不能也一起加進來平均?那篇論文叫 Model Soups。