原始论文
From Intuition to Investigation: A Tool-Augmented Reasoning MLLM Framework for Generalizable Face Anti-Spoofing
- 发表版本
- CVPR 2026会议
- arXiv 首次提交
- arXiv:2603.01038
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{faceantispoofingtarfas2026,
  title = {{From Intuition to Investigation: A Tool-Augmented Reasoning MLLM Framework for Generalizable Face Anti-Spoofing}},
  author = {Haoyuan Zhang and Keyao Wang and Guosheng Zhang and Haixiao Yue and Zhiwen Tan and Siran Peng and Tianshuo Zhang and Xiao Tan and Kunbin Chen and Wei He and Jingdong Wang and Ajian Liu and Xiangyu Zhu and Zhen Lei},
  year = {2026},
  eprint = {2603.01038},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2603.01038}
}
2012 年 Idiap 发布 Replay-Attack 数据集时,拿来当基线的方法是 LBP。每个像素拿周围八个邻居和自己比亮度,邻居不比中心暗就记 1、比中心暗就记 0,凑成一个 8 位的编码,再把整张脸的编码统计成直方图。纸张的纤维、屏幕的像素格,纹理都和皮肤不一样,直方图也会跟着不一样。
十几年后,人脸防伪换上了多模态大语言模型。I-FAS 让模型回答「这是真人吗?」,先答 Yes 或 No,再补一句说明。只是这句说明常常长这样:
This is a picture of a man wearing glasses.
说的都对,但和真假没什么关系。
中科院自动化所雷震的团队,加上百度做 I-FAS 的原班人马,这次把 LBP 找了回来。它没有被放回网络里当特征,而是做成一个工具,让大语言模型自己决定什么时候把它叫出来看。
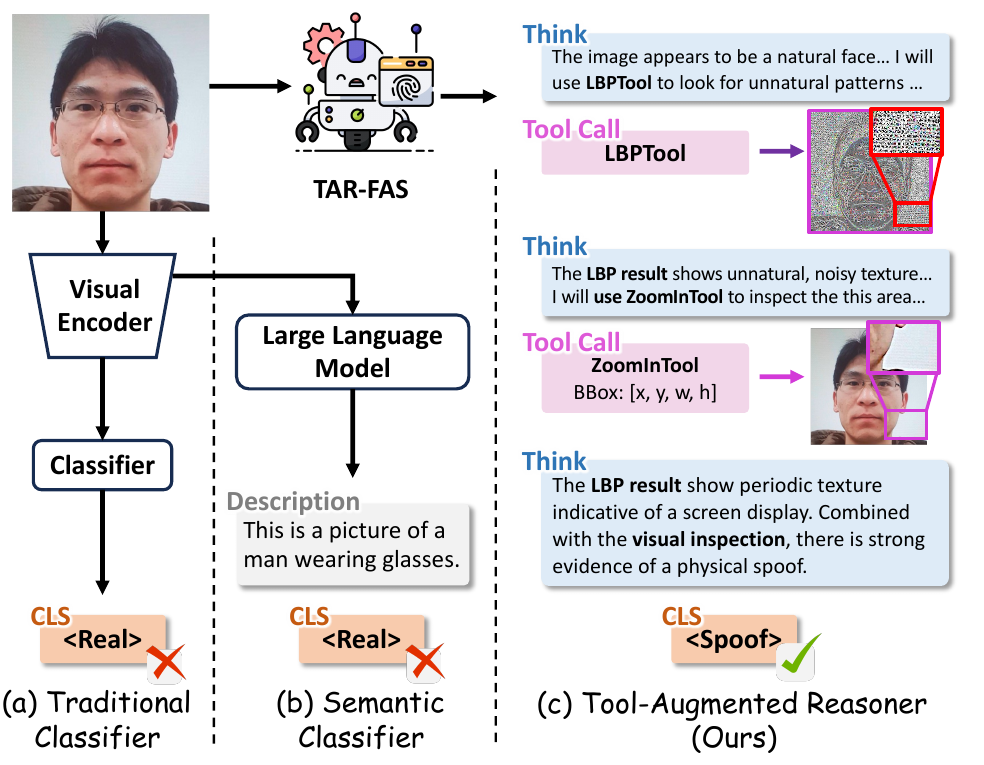
图中间那一列就是 I-FAS 的输出格式。右边是这篇的做法,模型先看一眼,觉得像真人,接着把 LBP 工具叫出来,在输出图上看到一块不自然的纹理,再把那一块放大,最后改判为攻击。
定义问题
I-FAS 把防伪改写成看图问答,跨数据集的成绩比 CLIP 系列的方法好上一大截。作者认为它的天花板就在那句描述上。他们引用先前的研究指出,多模态大语言模型对低层视觉特征本来就有些盲点,训练目标又只要求它写一句短短的说明,模型学到的多半是「戴了面具」「拿着屏幕」这种看得见的语义线索。翻拍屏幕留下的摩尔纹、打印机的网点、面具材质的细微反光,很难写进一句话里,也就没被学到。
FaceCoT 的附录有一张表,让这件事看得更清楚。通用模型零样本判断 Rose-Youtu 的攻击图像,戴面具的大多认得出来,纸质和屏幕重放却一张都没抓到。
那么,要怎么让大语言模型去看那些像素级的痕迹?
传统防伪一直在处理这件事,LBP、HOG、FFT 都是当年常用的手段。另一边,近来的多模态模型已经能在推理途中调用外部工具,例如 DeepEyes 让模型自己决定要放大图上的哪一块。作者把两边接了起来,让模型在推理时调用这些老牌的图像算子。
解决问题
工具箱
作者准备了六个工具,分成四类:
- ZoomIn:给一个框,把那一块裁出来放大。
- 纹理:LBP,看皮肤的纹理是否自然,纸张和面具材质常在这里露出破绽。
- 频率:FFT 和小波变换,看频率分布有没有异常,屏幕和印刷品常带有周期性的信号。
- 结构:HOG 和 Laplacian 边缘检测,看边界和梯度,面具的边缘、屏幕的边框会在这里浮现出来。
每个工具的输出都是一张图,会再喂回模型。所以模型「看工具结果」,其实是在看一张 LBP 编码图、一张频谱图或一张边缘图。
FFT 图为什么看得出屏幕?下面这张示意图把两张 64×64 的图像变换到频谱上。上排是一张平滑的亮度起伏,代替直接拍的脸;下排在同一张脸上叠了一组每 8 个像素重复一次的竖条纹,模拟隔着屏幕拍照时出现的周期纹路。
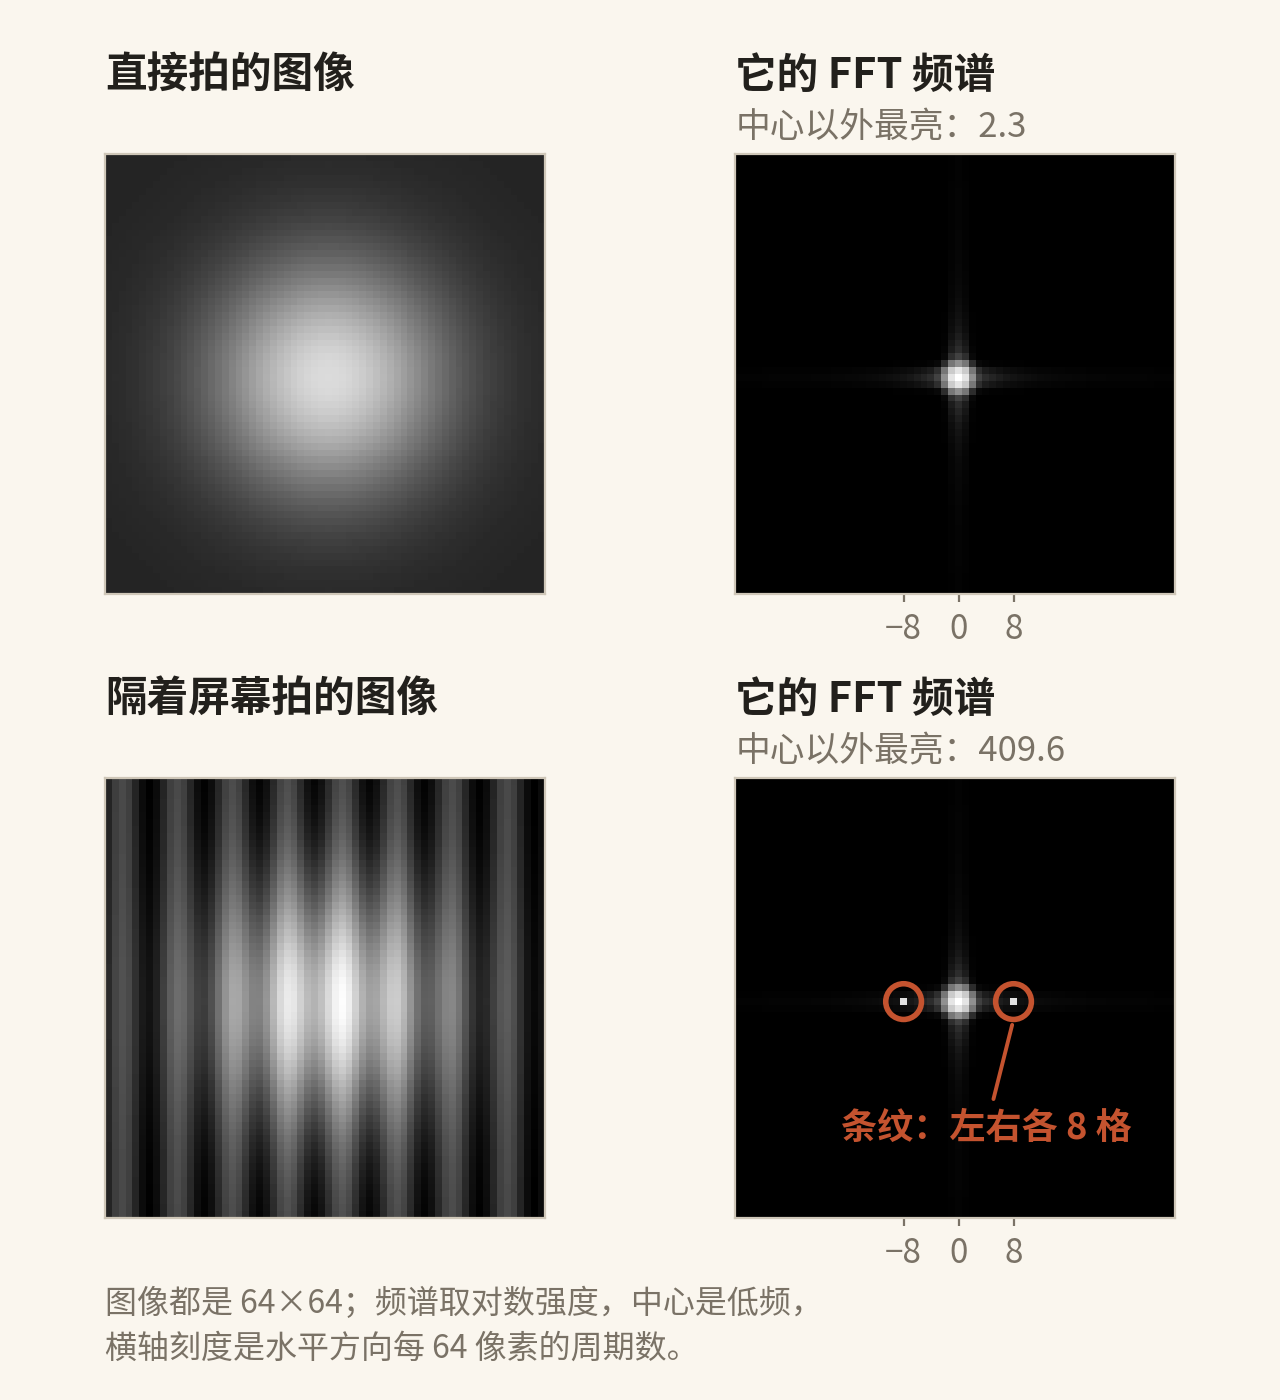
右上的频谱只有中心一团,那是平滑亮度起伏的低频能量,离中心越远越暗。右下多了两个小亮点,刚好落在横轴 −8 和 +8。64 个像素宽、每 8 个像素一个周期,刚好是 8 个周期,所以亮点离中心 8 格,左右对称各一个,强度是直接拍时中心以外最亮处的一百多倍。
条纹在左下的图像里和脸的亮度混在一起,不太好分;变换到频谱上,它被集中成两个点,一眼就看得出来。真实的摩尔纹方向和周期都比较乱,频谱上的亮点也会散开,但道理一样。TAR-FAS 的 FFT 工具返回的就是这种频谱图,模型要学的是在图上找偏离中心的亮点。
论文没有交代各个工具的实现参数,这张图只用来说明 FFT 工具返回的东西长什么样子。
ToolFAS-16K:先请知道答案的老师示范
模型一开始不会用工具,得先有示范。作者从 CelebA-Spoof 挑了 16,172 张图像,将近一半是真人,其余涵盖 10 种攻击,再请 Gemini-2.5 Pro 一轮一轮地写出使用工具的推理过程。
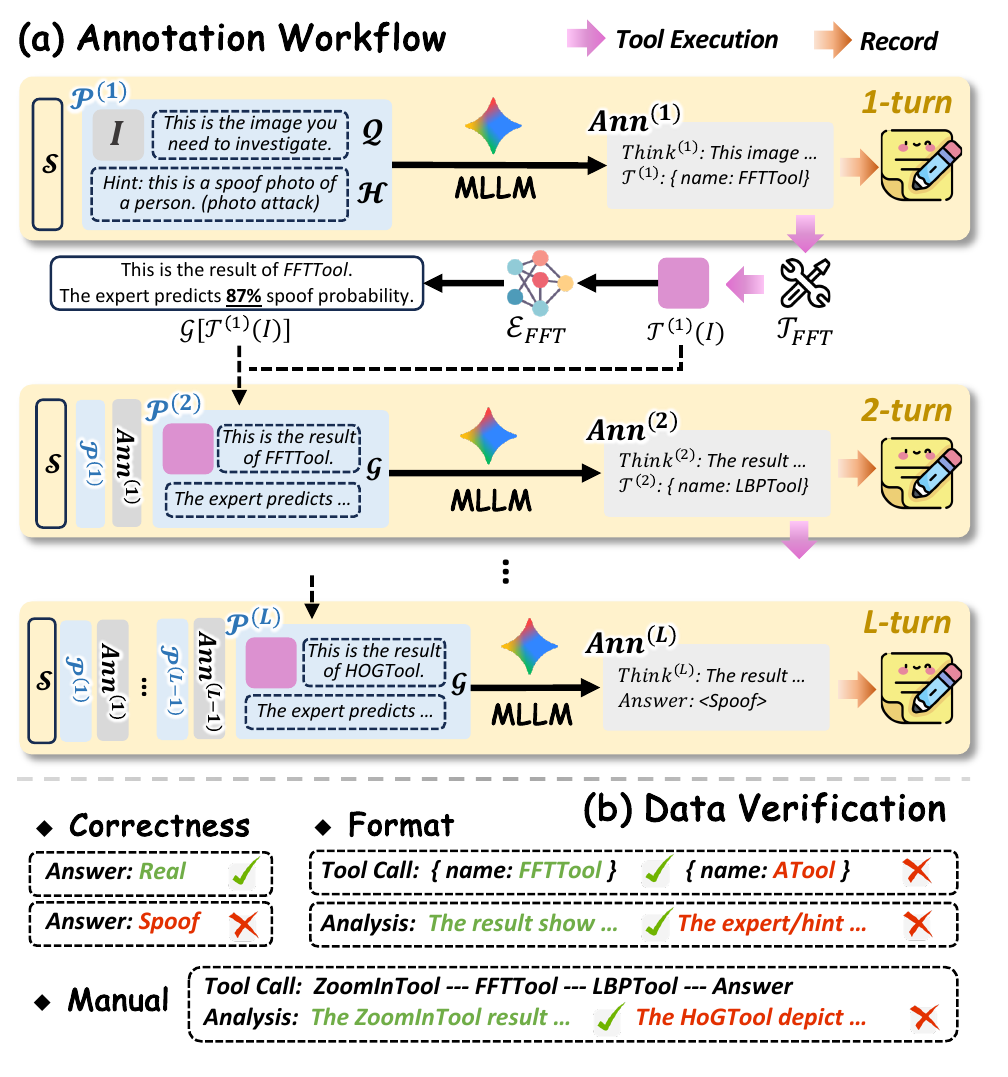
从图的第一轮看起。Gemini 收到的除了图像和一句「这是你要调查的图像」,还有一个提示 ,直接写出这张图是真人还是哪一种攻击。系统提示词也讲明了,最终的分类必须和提示一致,而且推理时不能提到提示。
Gemini 要求调用某个工具后,工具结果除了送回给它看,还会先交给一个「专家模型」。每个工具(ZoomIn 除外)各有一个专家,是只有三层卷积的小 CNN,输入只有工具的输出图,看不到原始图像,输出这张图带有攻击痕迹的概率。作者用 CelebA-Spoof 的 4,000 个身份训练、1,000 个身份测试,这些小模型在阈值 0.5 下大约有八到九成的准确率。下一轮的提示里就会多一句「这是 FFTTool 的结果,专家预测有 87% 的概率带有攻击痕迹」。
一份标注最多 6 轮,Gemini 给出答案就结束。之后有三道检查。答案要和标签一致;工具调用要符合格式,分析里不能出现提示或专家概率;最后由人工确认工具分析和结论在逻辑上接得上。没通过的重标一次,再不通过就丢掉。
所以这份数据是一位事先知道答案、旁边还有助手报概率的老师,写给学生看的解题示范。提示和专家概率在检查时都被挡掉了,学生看不到。学生从这里学到的是「怎么调用工具、怎么写推理」;它自己看工具结果做判断的能力,要靠下一阶段的强化学习来练。
三段训练
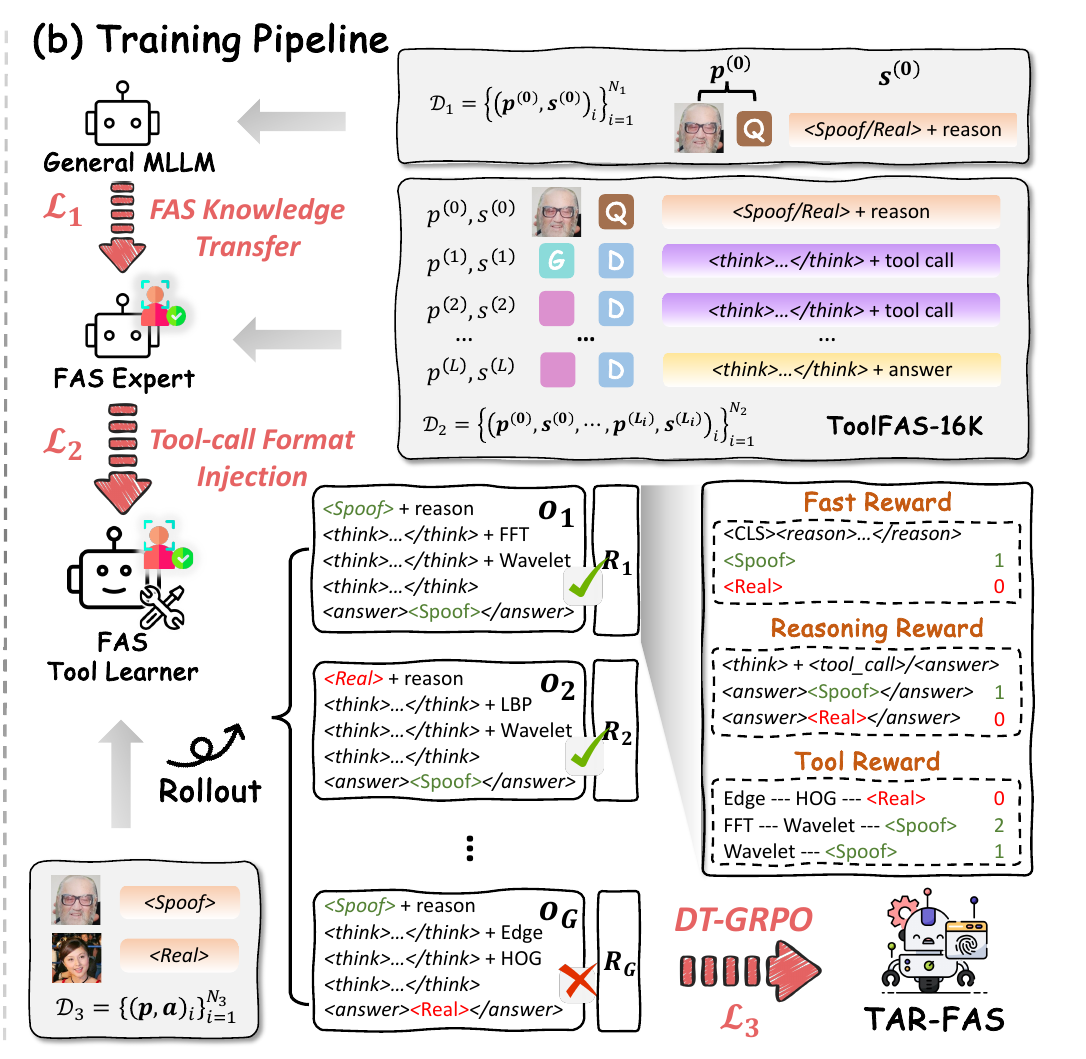
骨干是 InternVL3-8B。图上从上往下有三个阶段:
-
FAS 知识迁移(KT):用 I-FAS 格式的数据做监督微调。问题固定是「Is this photo of a real person?」,答案是
<Real>或<Spoof>加一句理由。这一步让通用模型先搞懂防伪在问什么。 -
工具调用格式注入(FI):在 ToolFAS-16K 上微调。每条数据的第一轮和上一阶段一模一样,是快速回答;之后才是一轮轮的思考与工具调用。损失函数是
第一轮占九成的权重。多轮数据很长,如果每个 token 权重一样,快速回答的那一小段很容易被稀释,模型学会了用工具,却忘了怎么直接分类。
-
DT-GRPO:只用 CelebA-Spoof 的图像和真假标签做强化学习,不再需要推理示范。
前两阶段用 LoRA(rank 16),最多 4,000 步;第三阶段放开全部参数,学习率 1e-6,每个问题采样 8 个回答,最多 300 步,KL 惩罚设为 0。
DT-GRPO 的奖励
GRPO 的做法是对同一个问题采样一组回答,每个回答算一个分数 ,再减去组内平均、除以组内标准差,得到优势值 。比平均好的回答被加强,比平均差的被压低。
这篇的分数由三项加权:
- :第一轮快答。格式错扣 1 分,否则答对 1 分、答错 0 分。
- :最后的答案。推理格式错或工具调用无效扣 1 分,否则答对 1 分、答错 0 分。
- :每用到一种不同的工具加 0.2,同一种工具调用两次只算一次;最后答错,这一项整个归零。
我们拿一张攻击图像、五个回答算一遍:
import numpy as np

beta_fast, beta_rsn, beta_tool, gamma = 0.1, 0.5, 0.4, 0.2

def reward(fast_ok, tools, final_ok, fmt_ok=True):
    r_fast = 1.0 if fast_ok else 0.0
    if not fmt_ok:                       # 推理格式错或工具调用无效
        return beta_fast * r_fast + beta_rsn * -1.0
    r_rsn = 1.0 if final_ok else 0.0
    r_tool = gamma * len(set(tools)) if final_ok else 0.0   # 同一种工具只算一次,答错归零
    return beta_fast * r_fast + beta_rsn * r_rsn + beta_tool * r_tool

# 同一张攻击图像(标签 Spoof)采样出的五个回答
rollouts = [
    ("快答 Real,查 FFT、Wavelet 后改判 Spoof", reward(False, ["FFT", "Wavelet"], True)),
    ("快答 Spoof,不查工具直接下结论", reward(True, [], True)),
    ("快答 Real,查 Edge、HOG 后仍判 Real", reward(False, ["Edge", "HOG"], False)),
    ("快答 Spoof,FFT 查两次再加 LBP", reward(True, ["FFT", "FFT", "LBP"], True)),
    ("快答 Spoof,工具调用格式写错", reward(True, [], False, fmt_ok=False)),
]
r = np.array([ri for _, ri in rollouts])
adv = (r - r.mean()) / r.std()           # GRPO:组内标准化
for (name, ri), ai in zip(rollouts, adv):
    print(f"R={ri:+.2f}  A={ai:+.2f}  {name}")
R=+0.66  A=+0.75  快答 Real,查 FFT、Wavelet 后改判 Spoof
R=+0.60  A=+0.61  快答 Spoof,不查工具直接下结论
R=+0.00  A=-0.72  快答 Real,查 Edge、HOG 后仍判 Real
R=+0.76  A=+0.97  快答 Spoof,FFT 查两次再加 LBP
R=-0.40  A=-1.61  快答 Spoof,工具调用格式写错
把五个回答放在一起比较:
- 答对才是大头。最后答对值 0.5,工具奖励最多只到 (最多三次工具调用,三种都不同)。不查工具直接答对的回答,优势值仍然是正的。
- 工具是加分题。同样答对,多看一种工具的回答就多 0.08。第一个回答的快答错了,靠工具翻盘,分数仍然比直接答对的高。
- FFT 调用两次不会多拿分,所以模型被推向「换一种工具看看」,名字里的 Diverse-Tool 就是这个意思。
- 格式错的回答分数是负的,优势值也最低。
- 奖励里没有任何一项鼓励少调用工具。只要答对,三次调用用满、三种都不同,分数最高。推理开销唯一的上限,是最多三次工具调用的规定。
推理阶段
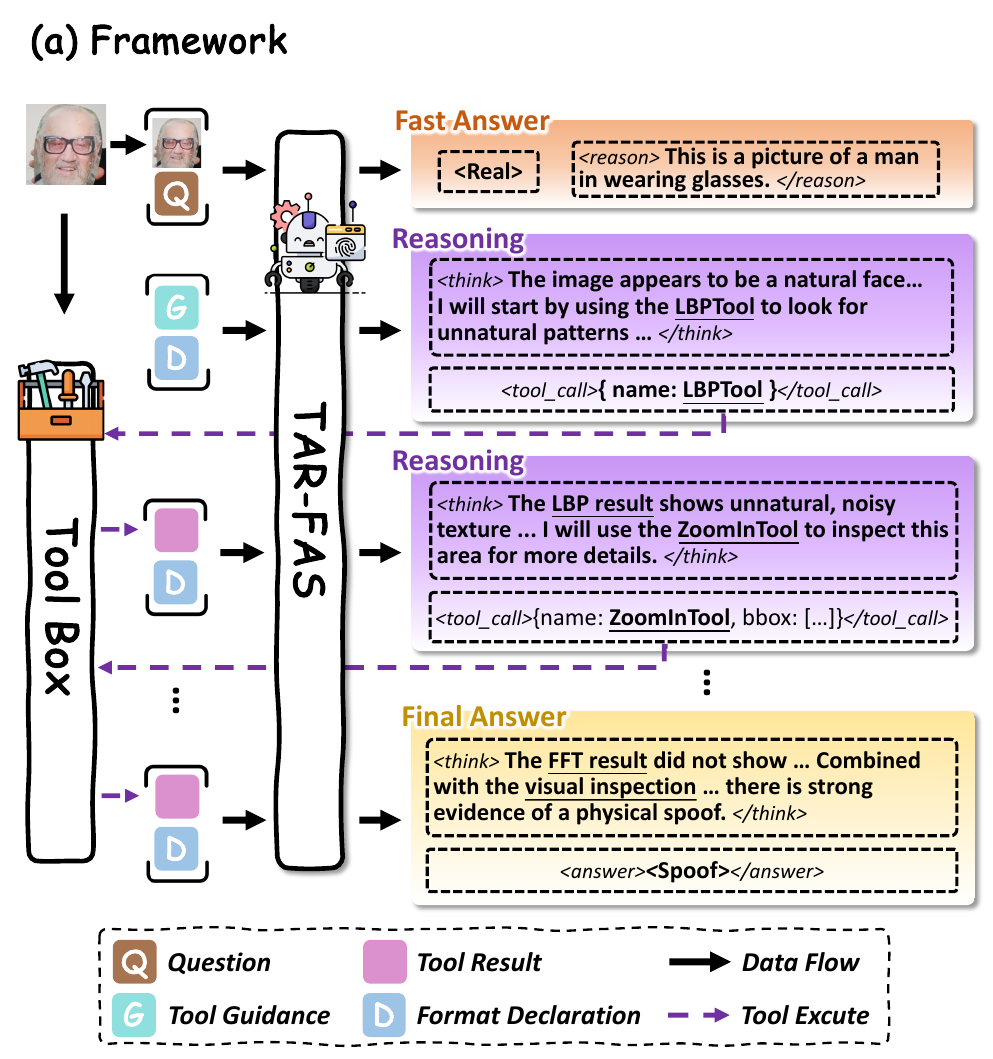
推理阶段分两步。第一轮问「Is this photo of a real person?(不要用工具)」,模型按 I-FAS 的格式快速回答。第二轮送进一句提示:
Wait, you should re-examine the image and give the final answer (use tools if needed).
模型开始写 <think>,需要时输出 <tool_call>,外部程序执行工具,把结果图送回去,如此反复,最多三次工具调用,最后写出 <answer>。计算 HTER 和 AUC 时,分数取自最终答案里那个分类 token 的 logits。
推理阶段没有专家模型,也没有攻击类型的提示,模型只能自己读工具的输出图。
讨论
One-to-Eleven
主实验沿用 I-FAS 的 Protocol 2,只用 CelebA-Spoof 训练,直接拿去测试 11 个数据集,每组跑三个随机种子取平均。输入是对齐裁剪后的 224×224 人脸,InternVL 会再放大到 448×448 处理。
平均下来,TAR-FAS 的 HTER 是 7.54%,AUC 是 96.67%;I-FAS 是 11.30% 与 93.71%,FLIP 是 18.73% 与 87.90%。
逐个数据集的 HTER(%)如下:
| 测试数据集 | I-FAS | TAR-FAS |
|---|---|---|
| CASIA-MFSD | 1.11 | 0.00 |
| CASIA-SURF-3DMask | 6.18 | 2.09 |
| HKBU-MARs-V1+ | 18.64 | 3.48 |
| HiFiMask | 28.23 | 17.97 |
| MSU-MFSD | 5.63 | 5.71 |
| OULU-NPU | 14.86 | 14.45 |
| Replay-Attack | 9.15 | 5.75 |
| Rose-Youtu | 5.52 | 3.61 |
| SiW | 4.02 | 8.35 |
| SiW-M-V2 | 10.89 | 11.72 |
| WMCA | 20.07 | 9.78 |
| 平均 | 11.30 | 7.54 |
进步最大的是有面具攻击的数据集。HKBU-MARs-V1+ 从 18.64% 降到 3.48%,WMCA 从 20.07% 降到 9.78%,HiFiMask 和 CASIA-SURF-3DMask 也都降了不少。作者特别提到,HKBU-MARs-V1+ 和 CASIA-SURF-3DMask 里有源域数据中没有的攻击方式与材质。
有意思的是,论文开头拿来示范的例子是屏幕的周期纹理,频率工具也是冲着纸质和屏幕攻击准备的,但以纸质和屏幕攻击为主的数据集,表现有进有退。Replay-Attack 和 Rose-Youtu 进步了,MSU-MFSD 和 OULU-NPU 几乎没动,SiW 从 4.02% 退到 8.35%。攻击种类最杂的 SiW-M-V2 也小幅变差。
工具和训练阶段
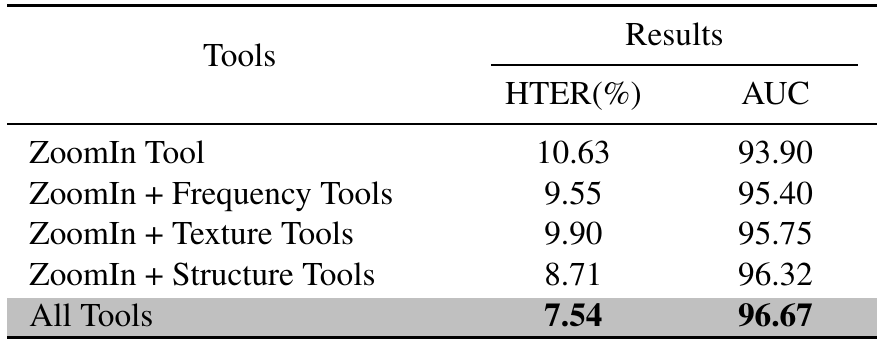
只给 ZoomIn 时 HTER 是 10.63%,已经比 I-FAS 低一点。三类工具里,单独加上结构工具的帮助最大,降到 8.71%;全部给齐是 7.54%。
这张表能说明工具有用,但也提醒我们,HTER 从 11.30% 降到 7.54% 这一段并非全部来自工具。只有放大镜的版本已经吃掉了其中一部分,那部分来自新的骨干和整套训练流程。
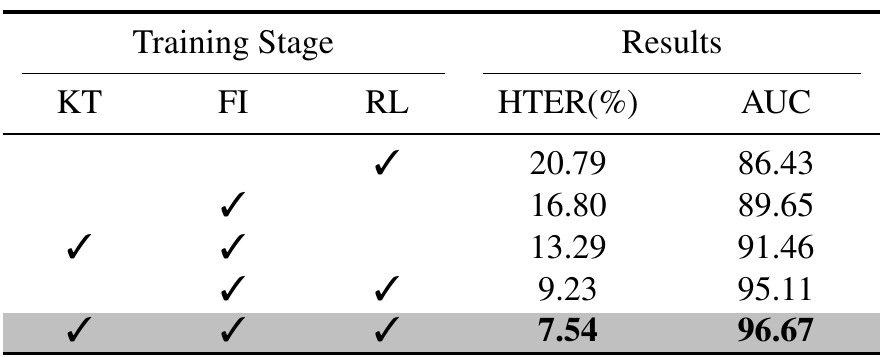
这张表更有故事。
- 跳过示范、直接做强化学习,HTER 是 20.79%。附录的训练曲线里,这种做法训练时的推理准确率一直在七成多上下震荡,完整流程则在九成五附近。模型连工具怎么调用都不会,奖励很难把它带到正确的方向。
- 只模仿 Gemini 的示范(FI),HTER 是 16.80%,比 I-FAS 还差。照着老师的解题过程抄,抄不出泛化能力。
- 示范之后接强化学习,从 16.80% 降到 9.23%,这是整张表最大的一步。
- 前面再加上知识迁移,最后到 7.54%。
还有几组对照
- 快答和推理答:同一个模型,第一轮快答的 HTER 是 10.54%,查完工具后的最终答案是 7.54%。快答已经比 I-FAS 好一些,用工具查过一轮,再降 3 个百分点。
- 只准放大:DeepEyes 的 ST-GRPO 只允许 ZoomIn,奖励只看格式、答对与否和有没有用工具。换成它,HTER 是 9.98%,比 DT-GRPO 的 7.54% 高。
- 工具次数上限:附录的曲线里,上限从 1 次放宽到 3 次,HTER 从大约 9.2% 一路降到 7.54%;放宽到 4 次反而回升到 8% 出头。作者认为是回答变长、采样的波动变大。
- 骨干与分辨率:换成 Qwen2.5-VL-7B,直接吃 224×224 的 HTER 是 9.45%,放大到 448×448 是 8.60%,InternVL3-8B 是 7.54%。分辨率和骨干各贡献一点,不过三个数字都比 I-FAS 低。
旧考法
附录另外跑了 OCIM(O、C、I、M 四个数据集轮流当测试集)。平均 HTER 是 1.30%,I-FAS 是 1.33%,几乎打平。四组里各有输赢,OCM→I 从 3.22% 降到 0.43%,OCI→M 却从 0.32% 升到 2.86%。
这组考法的数字已经挤在 1% 附近,很难再分出高下。训练步数只设了上限(SFT 最多 4,000 步、RL 最多 300 步),论文没有提到在目标数据集上挑 checkpoint;HTER 用的阈值怎么确定,则没有交代。
推理写得像样,但未必是这样推的
最后看论文挑的四个例子。
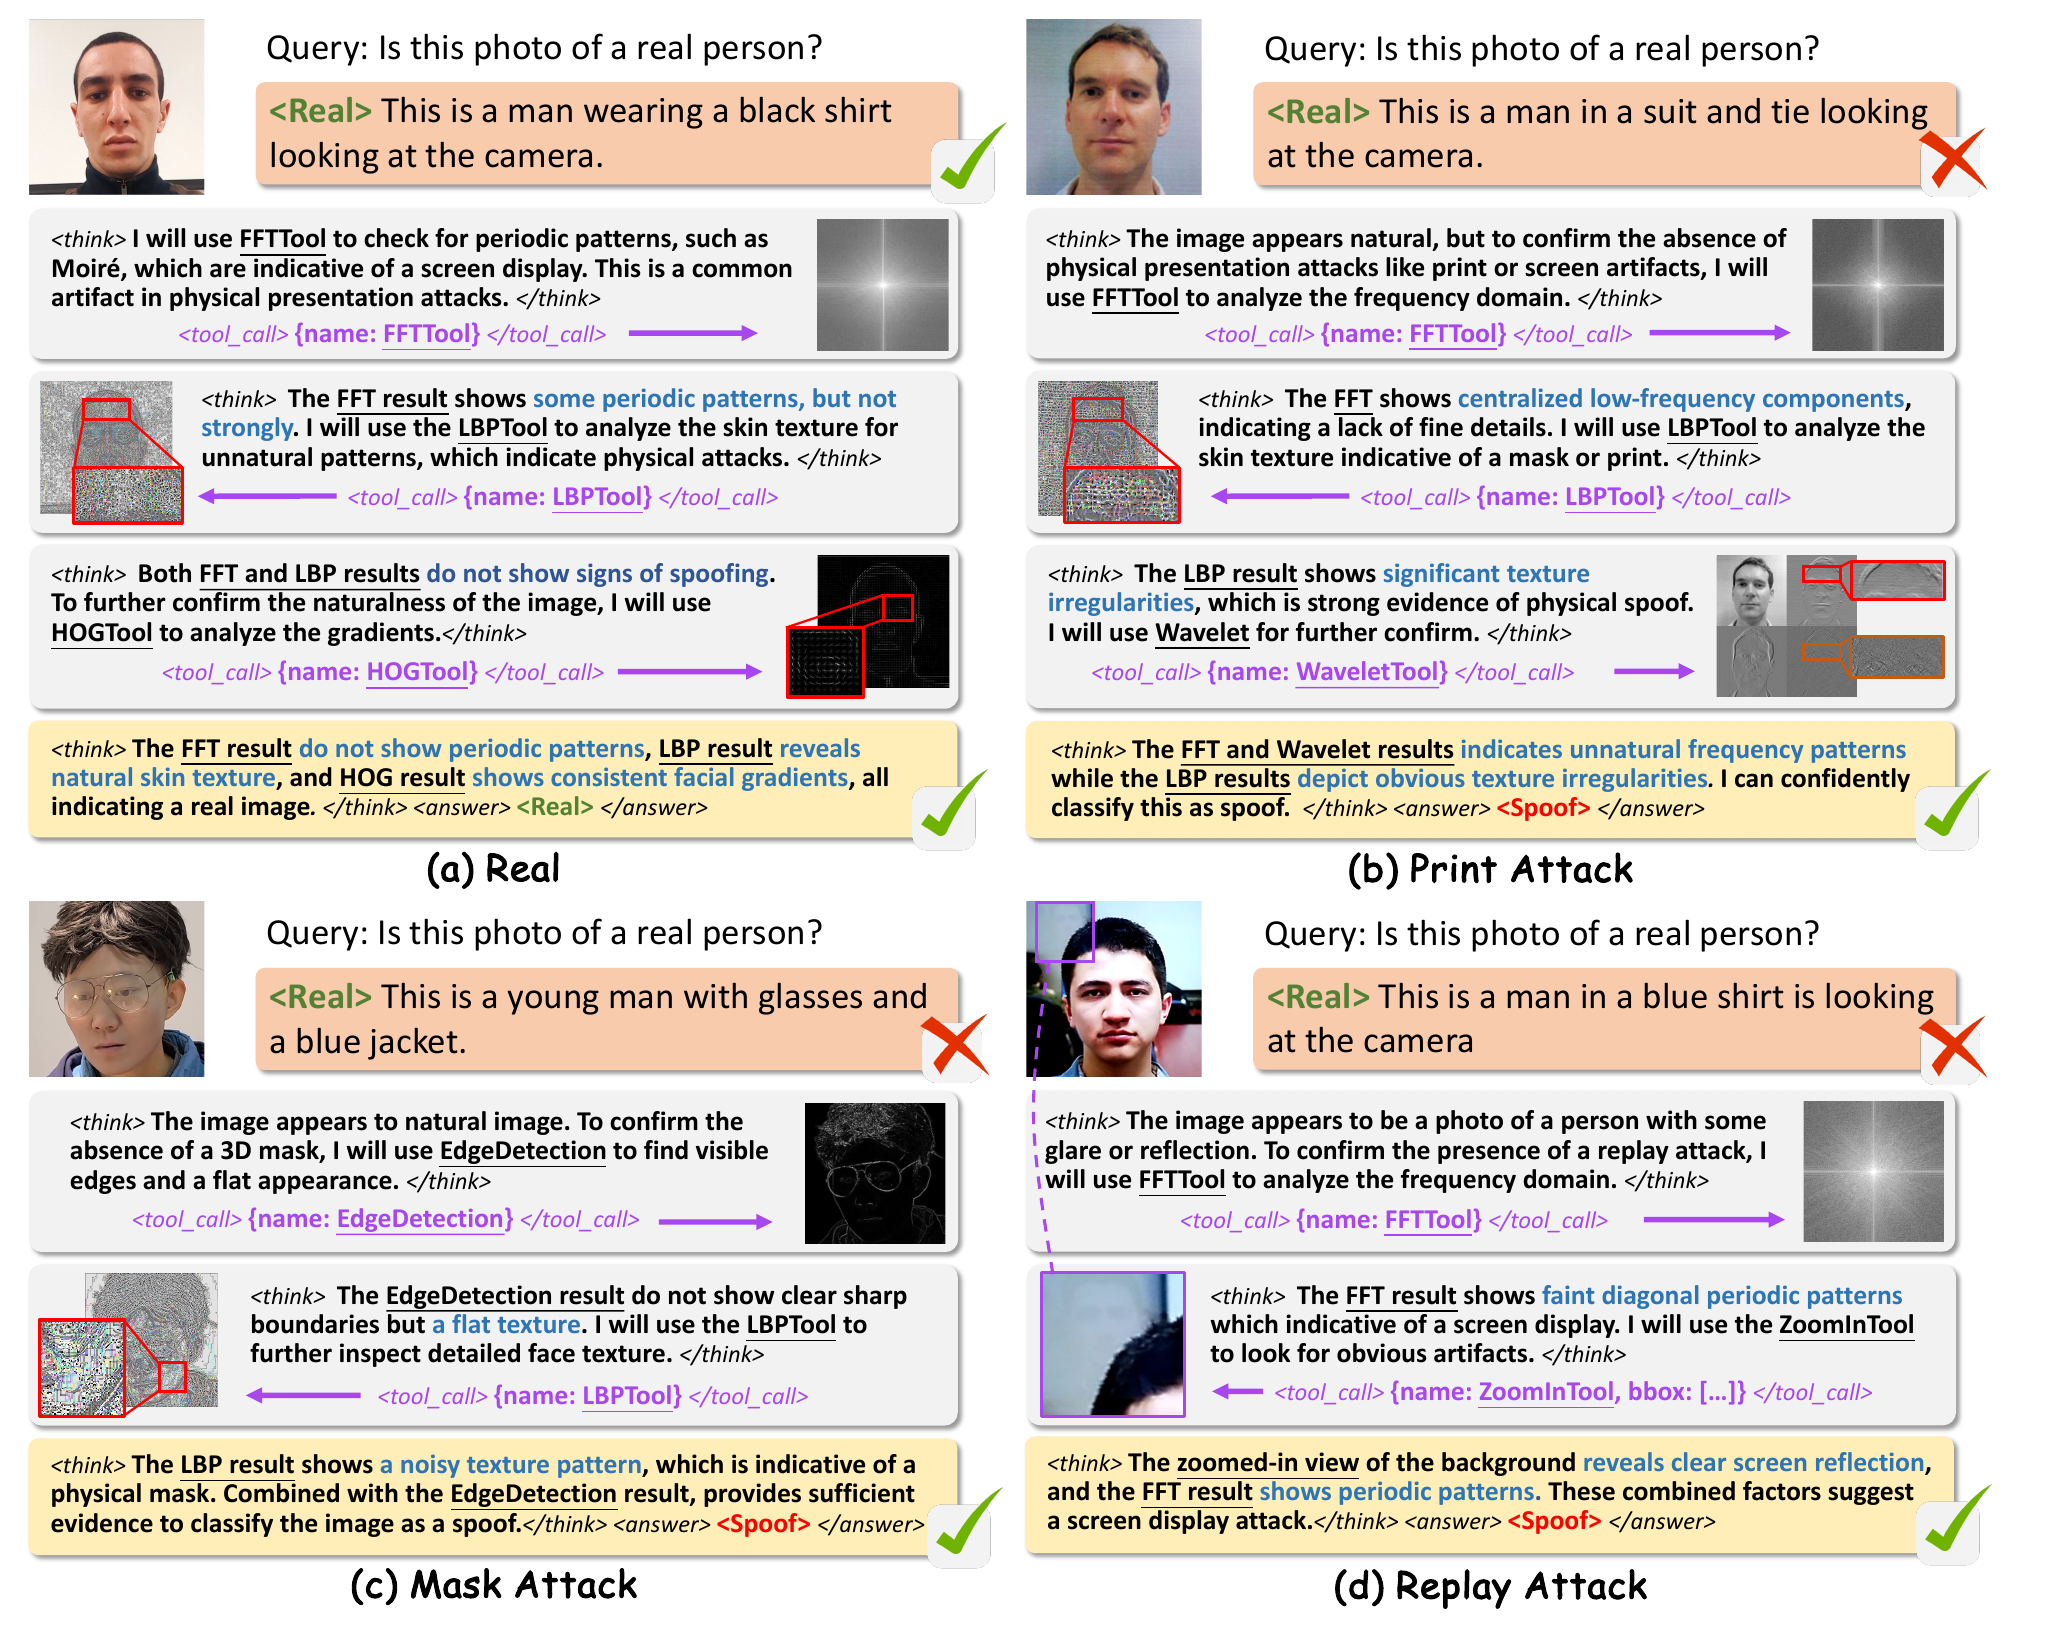
四个例子的快答全都是 Real,其中三个是攻击,靠工具翻盘。作者观察到,模型遇到纸质和屏幕攻击偏好频率工具,遇到面具偏好结构工具,纹理工具则各种攻击都会用到。
再仔细读 (a) 那个真人例子。查完 FFT 后,模型写的是「FFT 结果显示有一些周期纹路,但不明显」;到了最后一段总结,变成「FFT 结果没有显示周期纹路」。前面的那点保留,到了结论就不见了,整段推理被整理成一个干净的故事。
这不影响这一题的答案,但提醒我们,写出来的推理和模型实际依赖的线索,未必是一回事。论文没有检验工具结果是否真的左右了判断,例如把工具输出换成无关的图,看答案会不会变。
另外有两件事论文没有给,部署时一定会被问到。一是推理耗时。8B 的模型先快答一次,再最多来回三轮,每轮都要重新读一张工具图。一般的手机活体模型只要跑一次 CNN,差距可想而知,但论文没有测。二是代码,目前还没有公开。
结论
TAR-FAS 让多模态大语言模型在推理途中调用 LBP、FFT、HOG 这些老牌算子,在只用 CelebA-Spoof 训练、测试 11 个数据集的设定下,把平均 HTER 从 I-FAS 的 11.30% 降到 7.54%,面具类数据集进步最大。
这篇最值得带走的是消融表里的那一步。只模仿 Gemini 的示范,成绩比 I-FAS 还差;同一个模型接上只看真假标签的 GRPO,HTER 从 16.80% 降到 9.23%。示范教的是怎么用工具,用得好不好,是强化学习练出来的。
附录里还有一个小发现。那些只有三层卷积、只看 LBP 或 FFT 输出图的专家小模型,在 CelebA-Spoof 上就有八到九成的准确率。它们在论文里只负责在标注时给 Gemini 递纸条,推理阶段并没有上场。
至于要不要把 8B 模型搬进刷脸门禁,等代码放出来、测过延迟再说吧。