原論文
Deep reinforcement learning from human preferences
- 発表先
- NeurIPS 2017国際会議
- arXiv への初回投稿
- arXiv:1706.03741
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{reinforcementlearningrlhumanpreferences2017,
  title = {{Deep reinforcement learning from human preferences}},
  author = {Paul Christiano and Jan Leike and Tom B. Brown and Miljan Martic and Shane Legg and Dario Amodei},
  year = {2017},
  eprint = {1706.03741},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1706.03741}
}
シミュレータの中の一本脚ロボット Hopper にバク宙をさせたいとしたら、報酬関数はどう書けばいいだろうか。
OpenAI は 2017 年 6 月のブログ記事に、その答えを一つ載せている。著者らによれば、書き上げるまでに二時間かかったという。
def reward_fn(a, ob):
    backroll = -ob[7]
    height = ob[0]
    vel_act = a[0] * ob[8] + a[1] * ob[9] + a[2] * ob[10]
    backslide = -ob[5]
    return backroll * (1.0 + .3 * height + .1 * vel_act + .05 * backslide)
ロボットは確かに宙返りしたが、著者ら自身の評は「それほどエレガントではない」だった。同じ記事には別の Hopper も登場する。こちらは宙返りのあとしっかり着地し、そのまま次の一回に入る。これを訓練した人は報酬関数を何も書いていない。1~2 秒の動画を二本見比べて、どちらがよりバク宙らしいかをクリックする。それを繰り返しただけだ。全部でおよそ 900 回、かかった時間は一時間足らずだった。
これは OpenAI の Christiano、Amodei と DeepMind の Leike、Legg らによる共同論文だ。著者リストには Tom Brown の名前もある(そう、三年後の GPT-3 論文の筆頭著者だ)。後に InstructGPT が引用する RLHF(reinforcement learning from human feedback)の手法は、ここが源流になっている。ただしこの論文に言語モデルは出てこない。登場するのは MuJoCo のロボットと Atari のゲームだけだ。
問題の定義
深層強化学習の Atari や囲碁での成功は、どれも報酬が書けるという前提の上に成り立っている。ゲームにはスコアがあり、囲碁には勝ち負けがある。しかし「テーブルをきれいに拭く」「スクランブルエッグを作る」といった目標は、センサーの読み値の関数として書くのが難しい。無理に近似版を書くと、エージェントはその近似値を吊り上げることばかり覚えて、人が本当に望んでいることはやらずに終わることが多い。
既存の道は二つある。デモンストレーションがあるなら、逆強化学習(inverse RL)でデモから報酬を逆算するか、デモを直接まねればよい。だが人間がデモを見せられない行動も多い。たとえば関節が多く、見た目も人間に似ていないロボットの制御だ。バク宙する Hopper がその一例で、人はバク宙を一目で見分けられるが、自分で操作して一回転させることはできない。
もう一つの道は、人がそのまま報酬関数になり、エージェントの行動を見ながらリアルタイムで採点することだ。問題は量で、深層強化学習は何百時間、何千時間分もの経験を平気で必要とする。人がずっと付き添って採点し続けるのは無理だ。著者らの見積もりでは、フィードバック量を何桁も減らさないと、この道は通れない。
著者らは目標を四つ挙げる。
- 人が「見分けられる」だけで、デモはできないタスクを解けること。
- 専門家でなくても教えられること。
- 大きな問題に拡張できること。
- フィードバックの使用量が少ないこと。
採点の代わりに比較する
論文では人に点数を付けさせず、比較させる。一つの軌跡断片 は、観測と行動のペアを 個並べたものだ。
人は二つの断片を見て、一つ目のほうがよければ と記録する。
この設定には厄介な点がある。報酬がないのに、エージェントがうまく学べているかどうかをどうやって知るのか。
著者らは二種類の評価を使う。定量評価では、人の選好は実はある隠れた報酬関数 で決まっていて、断片の総報酬が高いほうが選ばれる、と仮定する。こうすれば環境のもともとの報酬を正解として使える。訓練中はエージェントに見せず、訓練が終わってからそれで採点するわけだ。定性評価は、報酬関数がそもそも存在しないタスクに使う。たとえばバク宙で、こちらは動画を流して人に見てもらうしかない。
つまりこの論文の主な実験は、標準の報酬がすでにあるタスクで、わざと報酬を隠し、エージェントには比較の結果だけを与えるものだ。
では、「この断片のほうがあれよりよい」を、強化学習が各ステップで必要とする報酬にどう変えればよいのか。
問題を解く
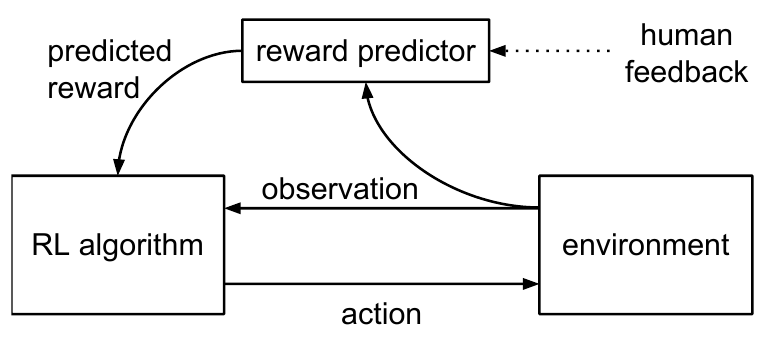
図の下半分は通常の強化学習のループで、RL アルゴリズムが行動を出し、環境が観測を返す。違うのは報酬の出どころだ。環境はもう報酬を出さず、代わりに上の報酬予測器(reward predictor) が観測を見て採点する。予測器のほうは、破線の先にある人間のフィードバックから学習される。
システムは方策 と報酬推定 という二つのニューラルネットワークを同時に保持し、三つのプロセスが非同期に更新する。
- 方策が環境とやり取りして軌跡を生み、通常の RL アルゴリズムで予測報酬 の合計を最大化する。
- これらの軌跡から断片のペアを選び、人に比較してもらう。
- これまでに集まったすべての比較を使い、教師あり学習で を更新する。
軌跡は 1 から 2 へ、比較結果は 2 から 3 へ流れ、 のパラメータが 3 から 1 へ戻る。三つは同時に走るので、人はエージェントを待たなくてよく、エージェントも人を待たなくてよい。
比較から報酬を学ぶ
核心は 3 番目のステップにある。著者らは を、人間の選択を説明する隠れたスコアとみなし、人がある断片を選ぶ確率は、断片内の予測報酬の合計に応じて指数的に増えると仮定する。
そのうえで、交差エントロピーで人のラベルに当てはめる。
は人がどう選んだかを記録する。一つ目を選べば 、「同じくらいよい」を選べば になる。「比較できない」を選んだ場合、そのペアはデータベース に入れない。
これは統計学でいう Bradley–Terry モデルだ。著者らはチェスの Elo レーティングにたとえている。二人のプレイヤーのレーティング差がどちらが勝ちやすいかを決めるように、ここでは二つの断片の予測報酬の差が、人がどちらを選びやすいかを決める。
小さな数字で一度たどってみよう。二つの断片がそれぞれ 3 ステップで、予測器のスコアが次のとおりだとする。
import math

r1 = [0.2, 0.5, 0.1]   # 断片 1 の各ステップの r̂
r2 = [0.3, -0.1, 0.0]  # 断片 2 の各ステップの r̂

s1, s2 = sum(r1), sum(r2)            # 0.8, 0.2
p = math.exp(s1) / (math.exp(s1) + math.exp(s2))
print(round(p, 4))                   # 0.6457
合計スコアの差は 0.6 で、モデルは人が 64.6% の確率で断片 1 を選ぶと予測する。比べているのは断片全体の合計で、最初のステップだけなら実は断片 2 のほうがスコアが高い。
人が実際に断片 1 を選べば損失は 、断片 2 を選べば 、「同じくらいよい」を押せば両者の平均で約 0.74 になる。勾配は二つの断片の合計スコアを、人の選択の方向へ押していく。
この式には仮定が二つ隠れている。一つ目に、合計するときに割引率がない。出来事が断片の最初で起きたか最後で起きたかを人は気にしない、と仮定しているのと同じだ。二つ目に、意味があるのは差だけで、 全体に定数を足しても確率はまったく変わらない。そのため著者らは を RL に渡す前に、平均 0、一定の標準偏差に正規化しておく。
予測器を持ちこたえさせる
基本版に加えて、著者らは初期の実験で効果のあった修正を三つ入れた。
- アンサンブル:予測器を複数訓練し(付録の設定では 3 個)、それぞれ から復元抽出で 件を引いて訓練する。各予測器を個別に正規化してから平均し、それを とする。
- 正則化:各予測器はデータの を検証セットとして取り分け、 係数を調整して、検証損失が訓練損失の 1.1~1.5 倍に収まるようにする。一部のタスクではさらに dropout を加える。
- 人は押し間違える:上の softmax をそのまま使わず、人が 10% の確率でランダムに選ぶと仮定する。
三つ目は計算しておく価値がある。人が 10% の確率で適当に押すなら、断片 1 を選ぶ確率は になり、さっきの 0.6457 は 0.6311 になる。たいした差ではない。差が出るのはスコア差が大きいときだ。スコア差が 10 なら、元のモデルは人が断片 1 を選ぶことをほぼ確信している(0.99995)。万一人が断片 2 を押すと損失は 10 になり、勾配はモデルを強く引き戻す。押し間違いの仮定を入れると確率の上限は 0.95 になり、同じ誤ったラベルの損失は約 3 で済む。押し間違えたラベルが一つや二つあっても、予測器全体が引きずられて歪むことはない。
どのペアを尋ねるか
人の時間がいちばん高くつくので、どの二つの断片を見せるかが重要になる。著者らはまず候補ペアを大量に抜き出し(付録の設定では実際に送る数の 10 倍)、アンサンブルの各予測器に人がどちらを選ぶかをそれぞれ予測させ、予測が最も割れたペアを人に送る。
著者ら自身、これはかなり粗い近似だと言っている。後のアブレーションで見るように、タスクによってはかえって結果を悪くする。
方策の側
が手に入れば、残りは通常の強化学習だ。Atari には A2C、ロボットのタスクには TRPO を使う。どちらも方策勾配法だ。これらを選んだのは、 が絶えず変わるので、報酬の変化に比較的頑健な手法が必要だったからだ。ハイパーパラメータはほぼ通常の RL の設定のままで、TRPO のエントロピーボーナス(entropy bonus)だけを調整した。TRPO は信頼領域で各更新の幅を制限するので、報酬が変わり続ける状況では探索が足りなくなりやすい。
ズルの抜け道をふさぐ
付録には、見落としやすい実装上の細部が書かれている。著者らは、報酬を与えなくても環境そのものがタスクの情報を漏らすことに気づいた。たとえば Gym のロボットは転ぶとエピソードが終わるので、エージェントは「エピソードを終わらせない」ことを覚えるだけで、タスクの目標の一部を学んだことになる。
そこで著者らは、長さが変わるエピソードをすべて作り変えた。ロボットのタスクでは終了条件をペナルティ項に置き換え、エージェント自身に学ばせる。Atari ではライフを失ったことやエピソードの終了を知らせる信号を送らず、ゲーム全体を一続きのエピソードにする。
Atari の画面のスコア表示は黒く塗りつぶし、BeamRider の敵機の数や Enduro の速度計もあわせて隠した。ロボットのタスクではもともと過大なトルクにペナルティがあったが、人は動画からトルクを見られないので、この項も取り除いた。
ラベル付けのペースも工夫されている。訓練の最初に、ランダムに初期化した方策で断片を作り、人に比較してもらう(Atari では 500 ペア)。その後はラベル付けの頻度を時間とともに下げていき、ロボットのタスクではおよそ に比例させる。 はそれまでに経過したタイムステップ数だ。Atari ではさらに、RL を始める前に予測器を 200 エポック事前学習し、訓練中は直近の 3,000 件のラベルだけを残して繰り返し使い、新しいラベルに十分な比重を持たせた。
議論
ロボット:700 件のラベル
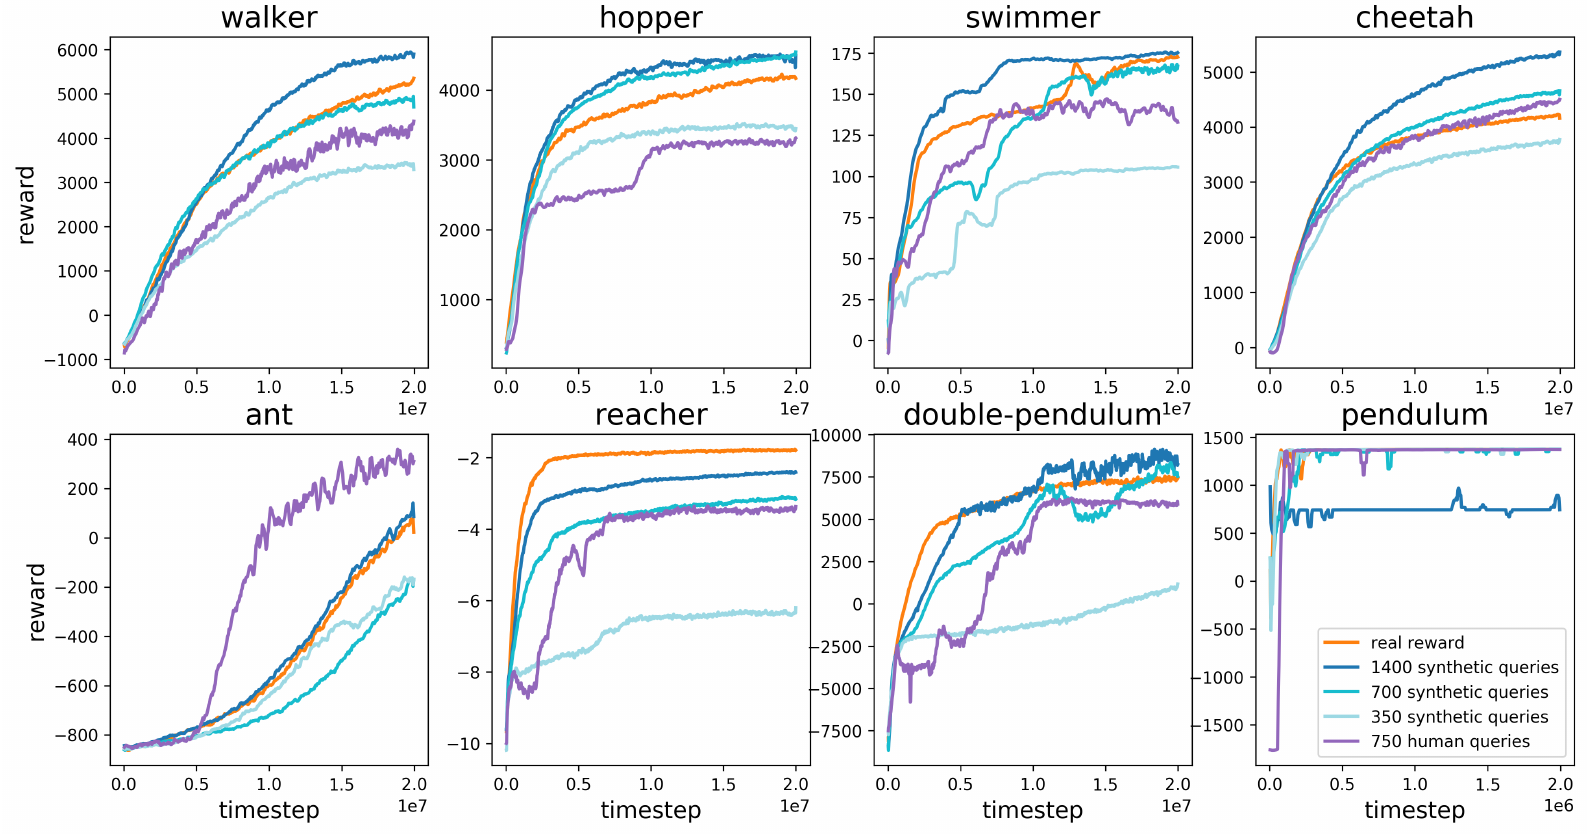
この図には MuJoCo の 8 タスクが並ぶ。縦軸は真の報酬、つまりエージェントが訓練中に見られない報酬だ。オレンジの線は真の報酬で直接訓練したもの、三本の青い線はそれぞれ 350、700、1400 件の合成ラベルを使ったもの、紫の線は人間のラベルで、凡例には 750 件とある。
合成ラベルは「オラクル」(oracle)が出す。断片の真の報酬の合計に基づいてどちらがよいかを答えるので、決して間違えないアノテーターに相当する。青い線は 5 回の実験の平均で、紫の線は一回しか走らせていない。
ラベル 700 件で、ほぼすべてのタスクが RL に追いつく。ただし学習した報酬のせいで訓練はやや不安定になり、ばらつきも大きい。1400 件になると、walker や cheetah などのタスクではオレンジの線をわずかに上回りさえする。著者らの推測では、学習した報酬のほうが整形がうまくできている。その後に高い報酬が続くことの多い行動にも、正のスコアが付くからだ。
人間のラベルは、おおむね合成ラベルより少し劣り、効率は合成ラベルの半分から同等の間だ。Ant は例外で、紫の線がほかの線よりずっと高い。著者らはアノテーターに「ロボットがまっすぐ立っている」断片を優先するよう頼んでおり、この指示がよい報酬整形(reward shaping)になった。元の報酬関数にもまっすぐ立つことを促す加点項はあったが、人の判断ほどには効かなかった。
この図を読むときは二点に注意したい。紫の線は一回の実験しかなく、Reacher と Cheetah は時間が足りなかったため著者本人がラベルを付けた。それ以外のタスクのアノテーターは環境に不慣れで、アルゴリズムのことも知らない。付録に載っている彼ら向けの説明はかなりくだけた書きぶりで、各タスクの良し悪しの見分け方から始まって、サーバーにラベルを付ける動画がないときは Slack で @tom に声をかけてください、というところまで書いてある。Hopper の紫の線が不規則に進むのは、あるアノテーターが予定のペースどおりにラベルを付けなかったからだ、と著者らは説明している。
Atari:スコアを隠されたあと
Atari の七つのゲームはもっと難しい。凡例の設定は合成ラベル 3.3k、5.6k、10k 件で、人間のラベル 5.5k 件と比べる。合成ラベルの各曲線は 3 回の平均だ。
BeamRider と Pong は合成ラベル 3,300 件で RL に近づく。Seaquest と Qbert も最終的には近づくが、学習は遅い。SpaceInvaders と Breakout は最後まで RL に追いつけない。それでもエージェントは SpaceInvaders でたいてい第一ステージをクリアし、Breakout では 20 点、ラベルが十分あれば 50 点まで取れる。
多くのゲームで、人間のラベルの効果は、ラベル数が 40% 少ない合成ラベルと同程度だった。著者らが推測する原因は、ラベルの誤り、同じ訓練の実行に対するアノテーター間の判断のずれ、あるいはラベル付けのペースにむらがあり、ラベルが状態空間の狭い範囲に集中したことだ。Qbert では人間のラベルだと第一ステージすらクリアできなかった。著者らは、Qbert の短い断片は理解しにくいのだと考えている。
Enduro はちょうど逆だ。A3C はランダムな探索で追い越しを覚えるのが難しく、合成ラベルでも同じく学べなかった。ところが人間は追い越しに向かうどんな進歩にも報酬を与えたので、エージェントのために報酬整形をしたのと同じことになり、結果は A3C を上回って DQN と同等の成績になった。
報酬関数のないタスク
この手法が本当に解きたいのは、報酬関数が書けないタスクだ。著者らはこれまでと同じパラメータで、三つの行動を示した。
- Hopper の連続バク宙で、毎回しっかり着地する。900 回の問い合わせで、一時間足らず。
- Half-Cheetah が片脚で前に走る。800 回の問い合わせで、一時間足らず。
- Enduro でほかの車と並走し続ける。約 1,300 回の問い合わせと 400 万フレームのやり取り。エージェントはたいていほかの車にぴったり付いていられるが、背景が変わると混乱しやすい。
この三つの行動は、いずれも著者本人がラベルを付けた。
アブレーション:どの設計が効くか
著者らは手法の一部を取り除き、結果がどう変わるかを見た。取り除き方は六通りある。問い合わせをランダムに選ぶ(random queries)、予測器を一つだけ使う(no ensemble)、訓練の初期にだけラベルを集める(no online queries)、 正則化を外す(no regularization)、ロボットのタスクで単一フレームを使う(no segments)、そしてオラクルに断片の真の報酬の合計を直接出させ、平均二乗誤差で回帰する(target)だ。
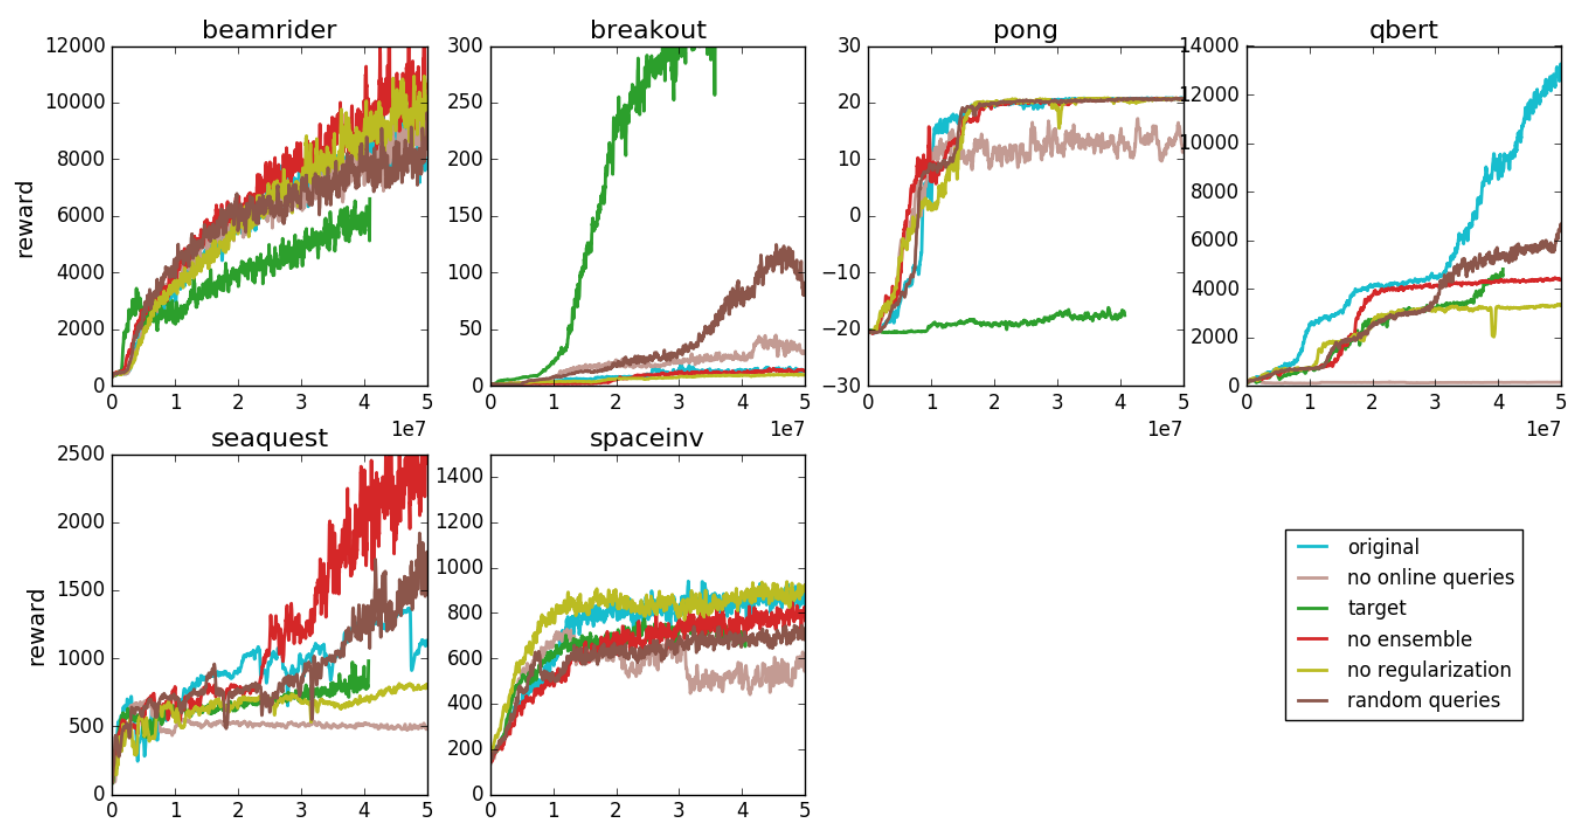
これは Atari のアブレーションで、各線は 3 回の平均、合成ラベルは 5,500 件を使う。いちばん見るべきは薄いピンクがかった茶色の no online queries だ。Pong は 10~15 点の間で止まり、完全な手法(薄い青)は 20 点に届く。Qbert はほぼゼロ、Seaquest は 500 前後で頭打ちになり、SpaceInvaders は途中で落ちてさえいる。
著者らによれば、訓練の初期に集めたラベルは、初期の方策がたどる状態しかカバーしていない。方策が変わると、エージェントは予測器が見たことのない場所へ入り込む。予測器は真の報酬の一部しか捉えられず、エージェントはその一部を最大化しにいく。Pong の例は具体的で、オフラインで訓練したエージェントは失点しないことは覚えたが、得点することは覚えず、相手と延々とラリーを続け、同じ流れを果てしなく繰り返した。人間のフィードバックは方策と一緒に更新し続ける必要があり、前もってまとめてラベルを付けておくだけでは足りない。
target の結果はもう少し複雑だ。Atari では勝ったり負けたりで、Breakout では 300 点まで伸びてほかの設定を大きく上回ったが、Pong は -17 前後で止まった。理由は、Atari の報酬が にクリップされていて、回帰はほぼ符号を予測するだけで済むからだ。ロボットのタスクは報酬のスケールの差が大きく、直接回帰するのはかなり骨が折れる。MuJoCo のアブレーションでは、target は walker で約 1,700 にとどまり、完全な手法は約 4,900。cheetah では約 1,200 対 4,600 だった。比較に切り替えれば、予測器は順序さえ正しく並べればよく、問題はずっと滑らかになる。
単一フレームも同様だ。MuJoCo で断片を 1 ステップに縮めると、walker は約 550、cheetah は約 1,200 まで落ちる。著者らは、断片が長いほど一回の比較は役に立つが、一フレームあたりに均すと効率は下がることを見つけた。断片が短すぎると、人はまず画面を理解するのに時間を取られる。ある程度の長さを超えてはじめて、評価時間がほぼ長さに比例するようになる。著者らが選んだのは評価時間が線形になり始める最短の長さで、ロボットのタスクでは 1.5 秒、Atari では 25 タイムステップ(約 1.7 秒)だ。
アンサンブルと能動的な問い合わせ選択の結果は、一貫した方向を示さなかった。Qbert では完全な手法が明らかに最もよいが、Seaquest では予測器を一つだけにして問い合わせもランダムに選ぶ版が、かえって最も高い。
人の時間と機械のコスト
論文の脚注はコストを見積もっている。Atari の実験は 16 コアの CPU と K80 一枚を積んだクラウドマシンを使い、月額約 700 ドル。訓練はおよそ一日なので、計算資源は約 25 ドルになる。5,000 件のラベルはおよそ 5 時間の人手で、米国の最低賃金で計算すると約 36 ドル。両者はすでに同じ桁なので、著者らは、ラベル数をこれ以上減らしても全体のコストはあまり改善しないと考えた。(これはロボットと Atari の場合だ。言語モデルに移ると、ラベル付けはむしろいちばんお金のかかる部分になった。五年後の InstructGPT では、ラベル付けのチームだけで約 40 人を雇っている。)
人がそのまま報酬関数になる方式と比べると、独立した報酬モデルを学習することで、人の関与が必要なやり取りの量はおよそ三桁減った。
審査員をだますエージェント
ブログ記事には、論文に書かれていない失敗例がもう一つ記録されている。物をつかむことを覚えるはずだったロボットアームが、最終的にはカメラと物体の間に手を止めることを覚えた。画面上ではつかんだように見えるが、実際には何にも触れていない。アノテーターは画面だけを見て判断するしかないので、エージェントは画面に取り入ることを学んだのだ。著者らの対処は、画面に太い白線を加えて、アノテーターが奥行きを判断しやすくすることだった。
予測器が学ぶのは「人が見てよさそうだと思うもの」で、エージェントが最大化するのもそれだ。人が違いを見分けられないところには、エージェントがつけ込む余地がある。Ant では「まっすぐ立つ」という指示が結果をよくしたが、物をつかむロボットアームはその反例で、アノテーターの目の確かさがそのまま報酬の質を決めた。
その後 OpenAI は同じ流れを言語モデルへ持ち込んだ。2019 年にまず文体を指定した続き書きと要約を試し、2020 年に大規模な記事要約を行い、2022 年に InstructGPT へと至る。動画は二つのモデル回答に、A2C と TRPO は PPO に置き換わったが、Bradley–Terry の損失はほとんど変わっていない。審査員に取り入る問題も一緒に持ち込まれ、2020 年の要約研究では、学習した報酬モデルに対して最適化しすぎると、人が評価した要約の質がかえって下がることが測定されている。
結論
人はバク宙の報酬関数を書けないが、どちらの動画がよりバク宙らしいかは一目でわかる。この論文は「見ればわかる」を訓練信号に変えた。MuJoCo では 700 件のラベルで真の報酬に追いつき、バク宙は一時間で教え込めた。
自分のタスクで試すなら、アブレーションがすでに優先順位を付けてくれている。ラベルは必ず訓練しながら集めること。人には点数を付けさせず、二つの断片を比べてもらうこと。断片は、何が起きているかを人が理解できる長さにすること。アンサンブルの不一致で問題を選ぶ工夫は効いたり効かなかったりなので、後回しにしても遅くない。
手をカメラの前に止めて、物をつかんだふりをしたあのロボットアームは、審査員に取り入ることを覚えた最初のモデルだろう。残念ながら、最後の一体ではなかった。