原始論文
A Systematic Study of In-the-Wild Model Merging for Large Language Models
- arXiv 首次提交
- arXiv:2511.21437
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmerginginthewildmerging2025,
  title = {{A Systematic Study of In-the-Wild Model Merging for Large Language Models}},
  author = {Oğuz Kağan Hitit and Leander Girrbach and Zeynep Akata},
  year = {2025},
  eprint = {2511.21437},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2511.21437}
}
模型合併的論文,實驗通常設計得很乾淨。每個專家在一個清楚分開的任務上微調,例如八個影像分類資料集、七個 NLP 任務,合併之後再逐一測這些任務。
真實世界不是這樣。打開 Hugging Face,同一個 Llama 或 Qwen 底下有成百上千個社群微調的版本,有的做數學,有的做角色扮演,有的只是換了一份指令資料;它們的目標可能重疊,也可能互相衝突。一家公司內部累積下來的微調模型,大概也是這種樣子。
Koç 大學與慕尼黑工業大學、Helmholtz Munich、MCML 的 Oğuz Kağan Hitit、Leander Girrbach 與 Zeynep Akata 想問一個很實際的問題。把這些「野生」的微調版本合併起來,能不能得到一個比基底模型、甚至比其中任何一個版本都更好的模型?
定義問題
論文把目標說得很具體。合併的對象是異質、可能互相衝突的微調版本,評估的是一般語言模型能力;來源各自的訓練任務只涵蓋其中一部分。
作者想回答三件事:
- 單純合併多個微調版本,能不能做出比基底模型更好的模型?
- 哪些以權重插值為主的合併方法做得到?
- 近年在影像模型上表現很好的「子空間」合併方法,用在大型語言模型的野外合併上,是不是也有效?
如果合併後同時贏過基底模型和單一微調版本,就有機會觀察到論文所說的建設性干擾(constructive interference)。實際評測分成兩關,一關和基底比,一關和整個模型池裡平均分數最高的微調版本比;這個最強版本是固定的參考模型,未必包含在某次抽到的子集裡。
解決問題
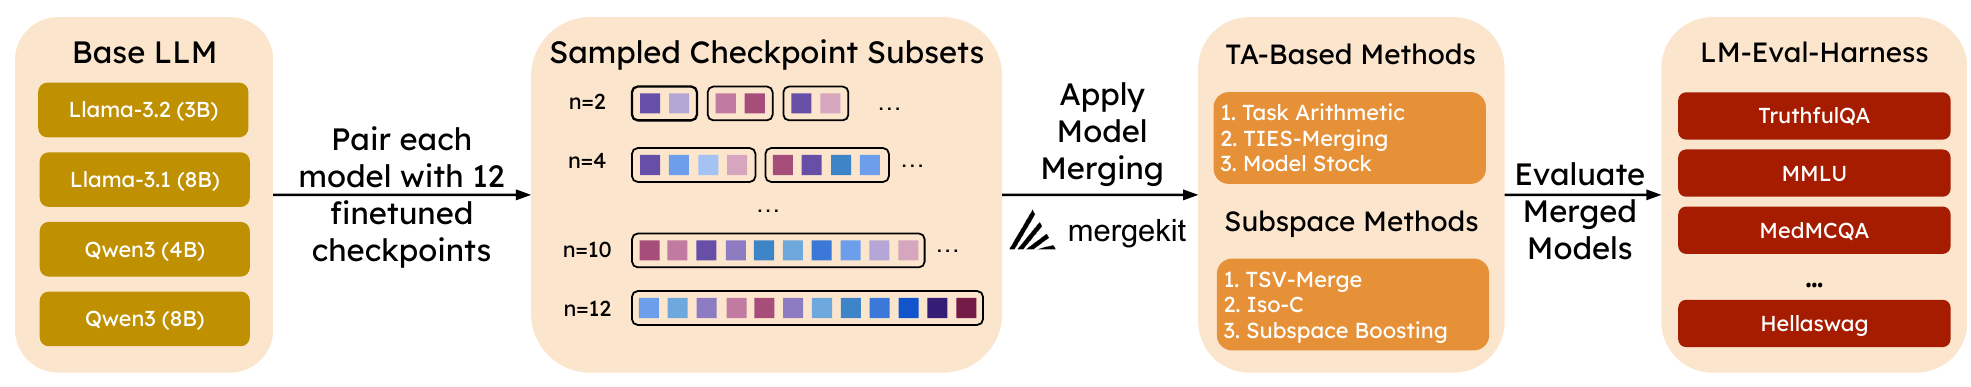
這篇也沒有提出新方法,重點是一套能重複的評估流程。
基底模型與微調版本:Llama-3.2-3B-Instruct、Llama-3.1-8B-Instruct、Qwen3 4B、Qwen3 8B 四個開放權重模型,每個從 Hugging Face 上找 12 個公開的微調版本,涵蓋不同的目標和領域。Llama 用的是 Instruct 起點,各家族內部共用自己的基底,不把四個家族交叉混合。
合併方法:分兩類,共六種。任務算術類有任務算術()、TIES-Merging(,每層保留絕對值最大的 10%)、Model Stock;子空間類有 TSV-Merge、Iso-C、Subspace Boosting。全部用 mergekit 實作,超參數事先在附錄裡選定後固定。
抽樣:合併的版本數 取 2、4、6、8、10、12。組合太多,每個 均勻抽 15 組子集( 只有一組),各方法用同一批子集,差異只來自合併演算法本身。
評測:用 lm-evaluation-harness 跑 16 個 Open LLM Leaderboard 上的標準評測,包括 ARC、HellaSwag、Winogrande、MMLU、GPQA、BBH、MMLU-Pro、TruthfulQA 等,不套對話模板,報準確率。
大多數任務是 0-shot,BBH 用 3-shot、MMLU-Pro 用 5-shot;模型評測採 float16,batch size 由 harness 自動選。這套設計方便固定選擇題與知識測試的提示格式,但沒有量完整對話、工具使用或特定角色扮演需求。某個微調版本在平均分數上變弱,也可能仍然更適合它原本的用途。
任務算術的尺度要先對上
這篇實驗還有一個很容易漏掉的設定,mergekit 的 normalization 開著。令第 個差值為 、配方權重為 ,實際合併改動是
當 、 時,這裡取的是任務差值的平均。十二個版本的差值直接相加,更新量會是這個配方的十二倍。重現這篇結果時,光抄「TA,」還不夠,必須連 normalization 一起設定。
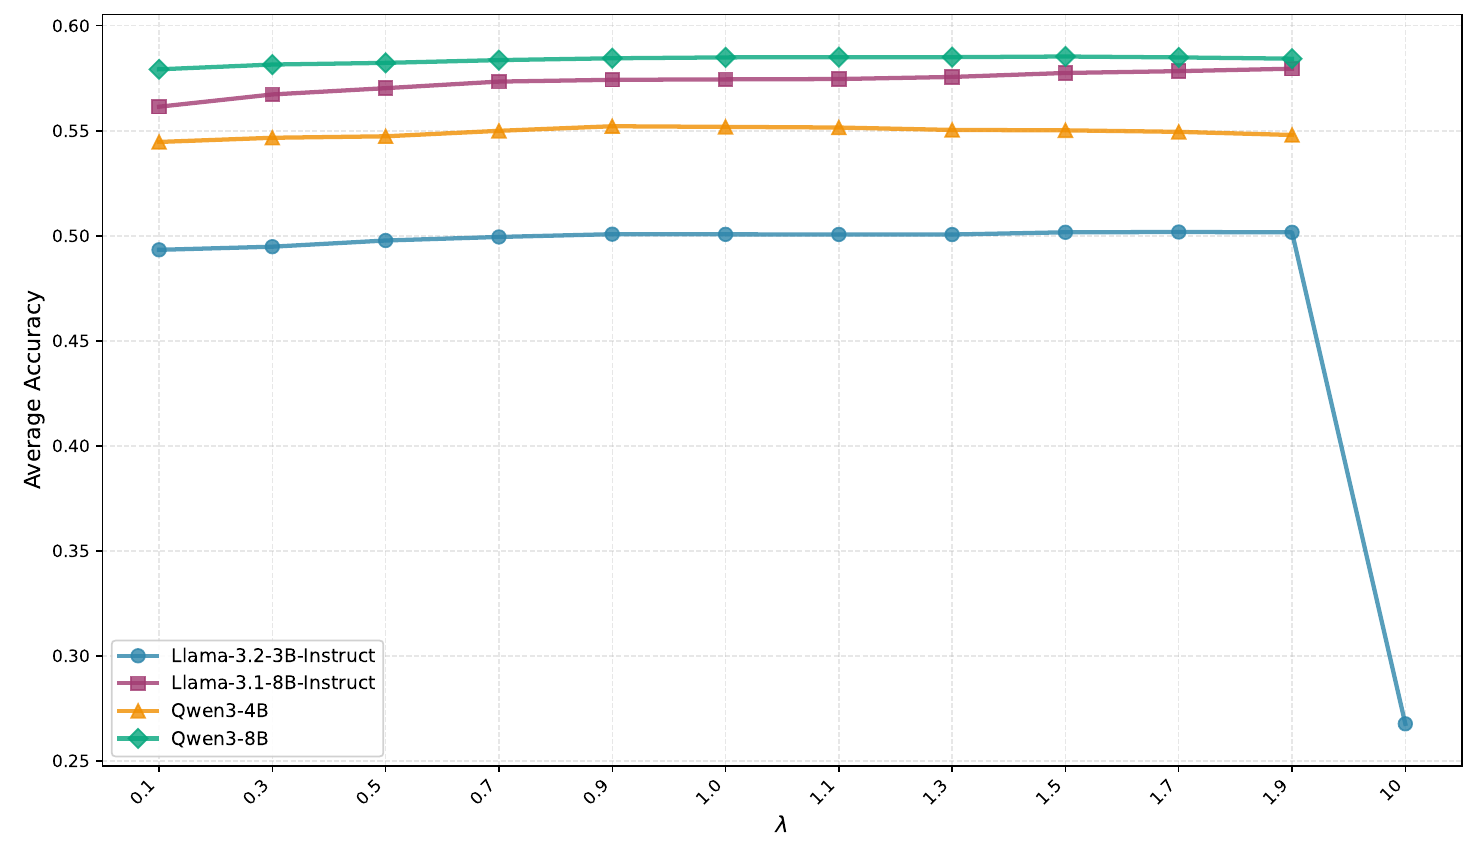
附錄也量了這件事。開 normalization, 從 0.1 到 1.9 的成績相當平,拉到 10 才明顯退步;關掉後,普通搜尋範圍內就會隨 增加而快速惡化。這組結果讓「簡單任務算術最穩」有了更準確的操作範圍,它是在平均與縮放的配方下得到的。
兩張原圖都以 為橫軸、平均準確率為縱軸,各色是四種基底。上圖開啟 normalization,最右還加入 ;下圖關閉。橫軸是列出的係數位置,最右兩點的實際間距尤其不同。
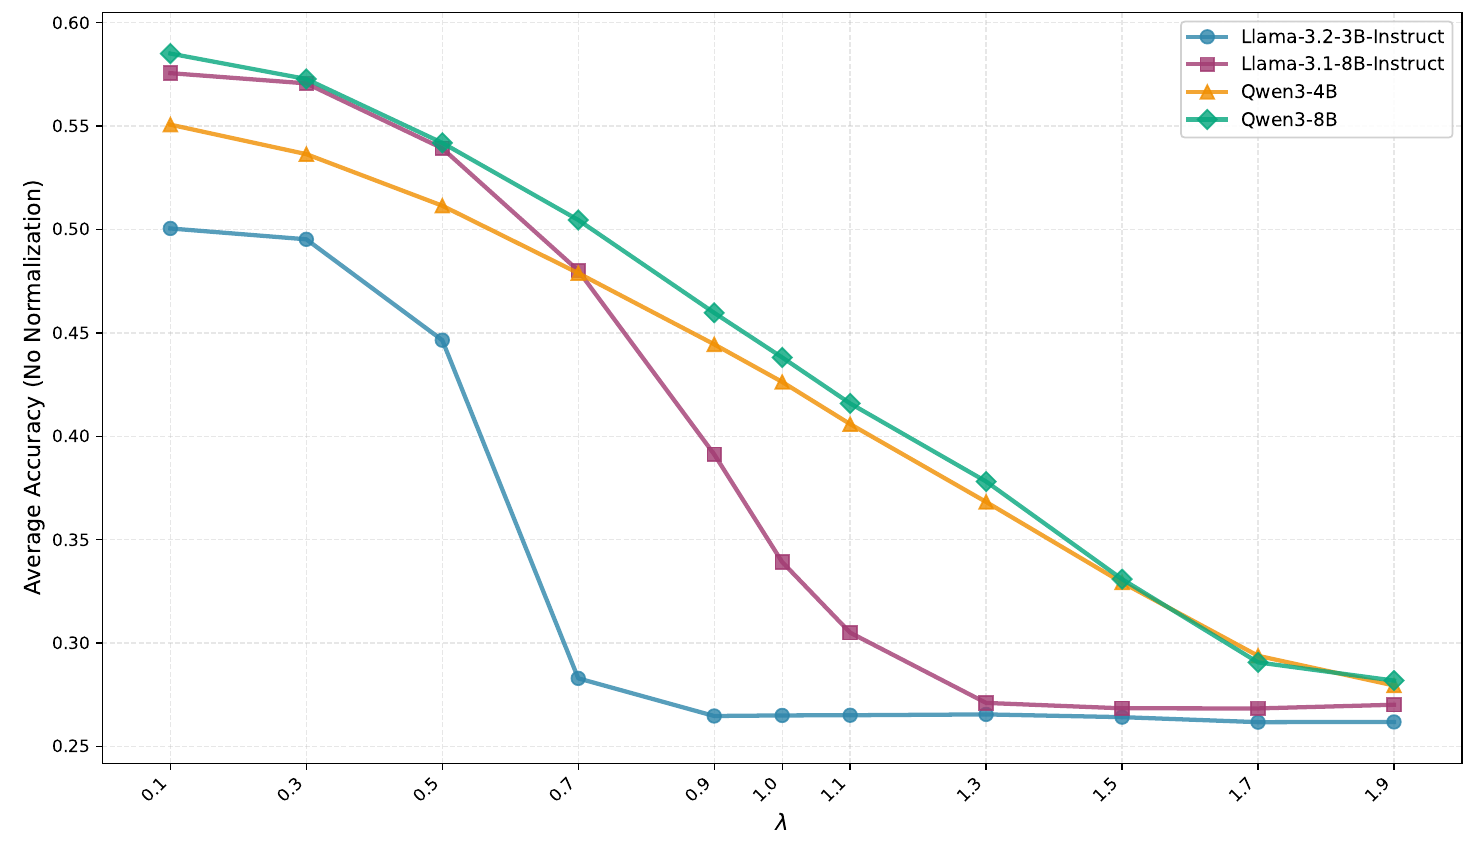
下面的下降是把多份改動加總後再放大的結果,和上面的平均配方有很大差別。重現時若漏抄一個布林設定,得到的曲線就可能完全相反。
討論
只有任務算術穩定變好
| 方法 | |||||||
|---|---|---|---|---|---|---|---|
| 任務算術 | 25 / −1.11 | 49 / −0.02 | 88 / +0.50 | 100 / +0.74 | 100 / +0.87 | 100 / +0.93 | 100 / +1.02 |
| Model Stock | 25 / −1.11 | 53 / +0.02 | 77 / +0.06 | 82 / +0.09 | 82 / +0.10 | 80 / +0.11 | 100 / +0.13 |
| TIES-Merging | 25 / −1.11 | 78 / +0.11 | 85 / +0.14 | 87 / +0.18 | 85 / +0.17 | 80 / +0.17 | 75 / +0.13 |
四個基底模型的平均,整理自原論文 Table 1。每格前一個數字是「勝過基底模型的組合比例(%)」,後一個沿用論文報告的「平均相對改善(%)」。 是單一的微調版本本身。
先看 那一欄。單獨拿一個微調版本出來,只有約四分之一勝過自己的基底模型,平均還退步了 1.11%。這也說明後面的進步,並不是因為剛好抽到了一個特別好的版本。
任務算術的趨勢最清楚。合併兩個版本時,大約一半的組合勝過基底;到 以後,四個模型的所有組合都勝過基底,平均進步隨 一路上升,到 約 1%。
100% 指這次抽到的組合全部過關。每個家族在 只測 15 種子集, 更只有一種組合,沒有量完 Hugging Face 上所有可能的微調版本。表中的兩個量也要一起看,超過基底的比例很高,仍可能只多一點點平均分數;它們回答的是穩定性和改善幅度兩個問題。
幅度是小的。作者自己的總結是,合併帶來的進步,平均到所有任務上,大多不到 1%。
TIES-Merging 勝過基底的比例也不低,但進步很快就停在 0.1 到 0.2% 左右;在 Qwen3 8B 上,合併越多反而越差, 時是 +0.16,到 變成 −0.08。作者認為,TIES 在異質的版本之間,對任務向量的大小很敏感。Model Stock 則幾乎一直貼著基底模型,權重本來就沒走遠。
有沒有贏過最好的那一個
勝過基底還不夠,作者也看合併模型能不能勝過整個模型池裡最好的微調版本。任務算術在四個模型裡有三個做到了;在 的組合裡,Qwen 兩組與 Llama 3.2 3B 的結果整體更有利。
例外是 Llama 3.1 8B。它的模型池裡有一個特別強的微調版本,合併雖然超過基底,仍未超過這個固定參考。實作上最好把「直接挑一個現成模型」保留成基準,否則花了合併與評測時間,可能只是追近原本就有的選項。
子空間方法:越合越差
近一兩年,TSV-Merge、Iso-C 這類子空間方法在影像模型的合併基準上表現很好。它們不在完整的權重空間裡相加,而是對每一層的任務向量做奇異值分解,在低秩的子空間裡處理干擾。TSV-Merge 保留每個任務最重要的奇異方向,再把不同任務的方向正交化;Iso-C 把奇異值的分布拉平。
搬到大型語言模型的野外合併上,結果不理想。TSV-Merge 和 Iso-C 的平均準確率,隨合併的版本數增加持續下滑。作者的解釋是,截斷和正交化在合併多個版本時,一步步丟掉了有用的資訊。
作者也量了合併後的權重離基底有多遠。任務算術、TIES、Model Stock 的任務向量長度()大多在 50 以內;Iso-C 和 TSV-Merge 常常到 100 到 300,在兩個 8B 模型上超過 300。距離越大,表現掉得越多。作者認為,這些方法把權重推得太遠,離開了基底模型的盆地,造成災難性遺忘。
拿一層 的任務更新 看,SVD 會把它拆成 。TSV-Merge 對每個來源保留約 的奇異方向,再把各來源的方向合起來正交化; 增加時,每個來源能留下的方向就更少。Iso-C 則在加總更新上做分解,將全部奇異值換成平均值,讓弱方向相對變強。兩者都改了方向的組合或強弱分布,和單純把原來的差值平均有明顯差別。
Subspace Boosting 沒有一起壞掉
第三個子空間方法值得單獨看。Subspace Boosting 先得到一個合併更新,再依奇異值的累積比例選截止點,把後面較弱的奇異值提升到截止點的值。它可以接在 TA 或 TIES 後面,所以實際結果分成 TA+SB 與 TIES+SB,並非另一份獨立的模型選擇法。
論文將門檻固定為 0.2。TA+SB 在少量版本時變異很大, 平均只有 23% 組合超過基底;到 是 100%,報告的平均改善為 +1.07。TIES+SB 較平穩,十二版本的平均改善為 +0.36;TSV-Merge 與 Iso-C 同設定分別是 −2.36 和 −5.36。這樣看,子空間方法有不同結果,不能全部歸成「越合越差」。TA+SB 的趨勢也和 TA 本身接近,新增的奇異值譜操作沒有帶來明顯、穩定的額外優勢。
模型池換乾淨一些
附錄另外各選三個數學、三個醫療專家,對 Qwen3 4B 與 8B 比較「同領域三個一起合」和「兩領域六個一起合」。評測改成對應的數學與醫療考題。8B 上兩領域混合與各自合併的表現接近;4B 的 TA、TIES 也能保留,但部分子空間版本有較大的差距。
這個對照讓主結果更有意思。隨機模型池可能混入彼此重疊、方向各異的訓練改動;先確認來源各自擅長什麼,再做有目的的組合,結果會不同。這篇主實驗刻意省略對齊、分群與候選篩選,因此不能用它判定所有精心挑過的合併配方都沒有價值。
距離分析也要放在這個範圍內使用。相同家族裡,改動範數增加與成績下降相關,是很好的異常線索;跨參數量或不同正規化的網路, 的絕對值無法共用一個 50 或 300 的門檻。作者用它支持離開好區域的假說,並未直接量出所有候選沿途的損失障礙。
結論
這篇研究的結論分兩層。
好消息是,就算是一堆目標不一、彼此可能衝突的社群微調版本,合併起來也能做出比基底模型更好的模型;用的是最早、最簡單的任務算術,版本越多越穩。
改善幅度仍然有限。TIES 與 Model Stock 接近基底,部分子空間配方退步,TA+SB 又大致沿著 TA 的趨勢走。選模型池、設定 normalization、固定評測提示,對解讀這張成績單都很重要。
如果你手上有一批同一個基底、來歷各異的微調版本,可以先用任務算術把它們合起來看看;換成更花俏的方法之前,先量一下合併後的權重離基底有多遠。