原始論文
Evolutionary Optimization of Model Merging Recipes
- arXiv 首次提交
- arXiv:2403.13187
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmergingevolutionarymodelmerge2024,
  title = {{Evolutionary Optimization of Model Merging Recipes}},
  author = {Takuya Akiba and Makoto Shing and Yujin Tang and Qi Sun and David Ha},
  year = {2024},
  eprint = {2403.13187},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.13187}
}
2024 年初,模型合併在開源社群紅透半邊天。Hugging Face 的 Open LLM Leaderboard 前排,大多是把幾個微調模型合併出來的版本;mergekit 這類工具讓人在 CPU 上就能做出一個新模型。
更早一點,Stable Diffusion 社群也走過同樣的路。這篇論文提到,愛好者把好幾個風格模型混出來的合併模型,曾一度成為社群最受歡迎的選擇。
東京的 Sakana AI,Takuya Akiba、Makoto Shing、Yujin Tang、Qi Sun 與 David Ha,看著這股熱潮,指出一個問題。合併被很多人看成一種「黑魔法或煉金術」,挑哪些模型、每層混多少、用什麼方法,全靠作者的直覺;而且大家調的,大多是排行榜上那幾個固定的評測。
他們想讓演化演算法來調配方。
定義問題
作者把合併拆成兩個互相獨立的空間。
參數空間(PS):每一層的權重怎麼混。這是一般說的模型合併,所有來源模型的架構必須相同。
資料流空間(DFS):每一層的權重保持原樣,改的是資料經過哪些層。例如 token 走完模型 A 的第 層之後,接著送進模型 B 的第 層。這和社群的「frankenmerge」疊層有點像,但要搜尋的是整條推論路徑。
兩個空間各自都很大。作者想知道演化搜尋在這兩個空間裡,能不能找到比人工配方更好的組合;特別是跨領域的合併,例如日文模型加上英文數學模型,人類不太知道該怎麼調。
解決問題
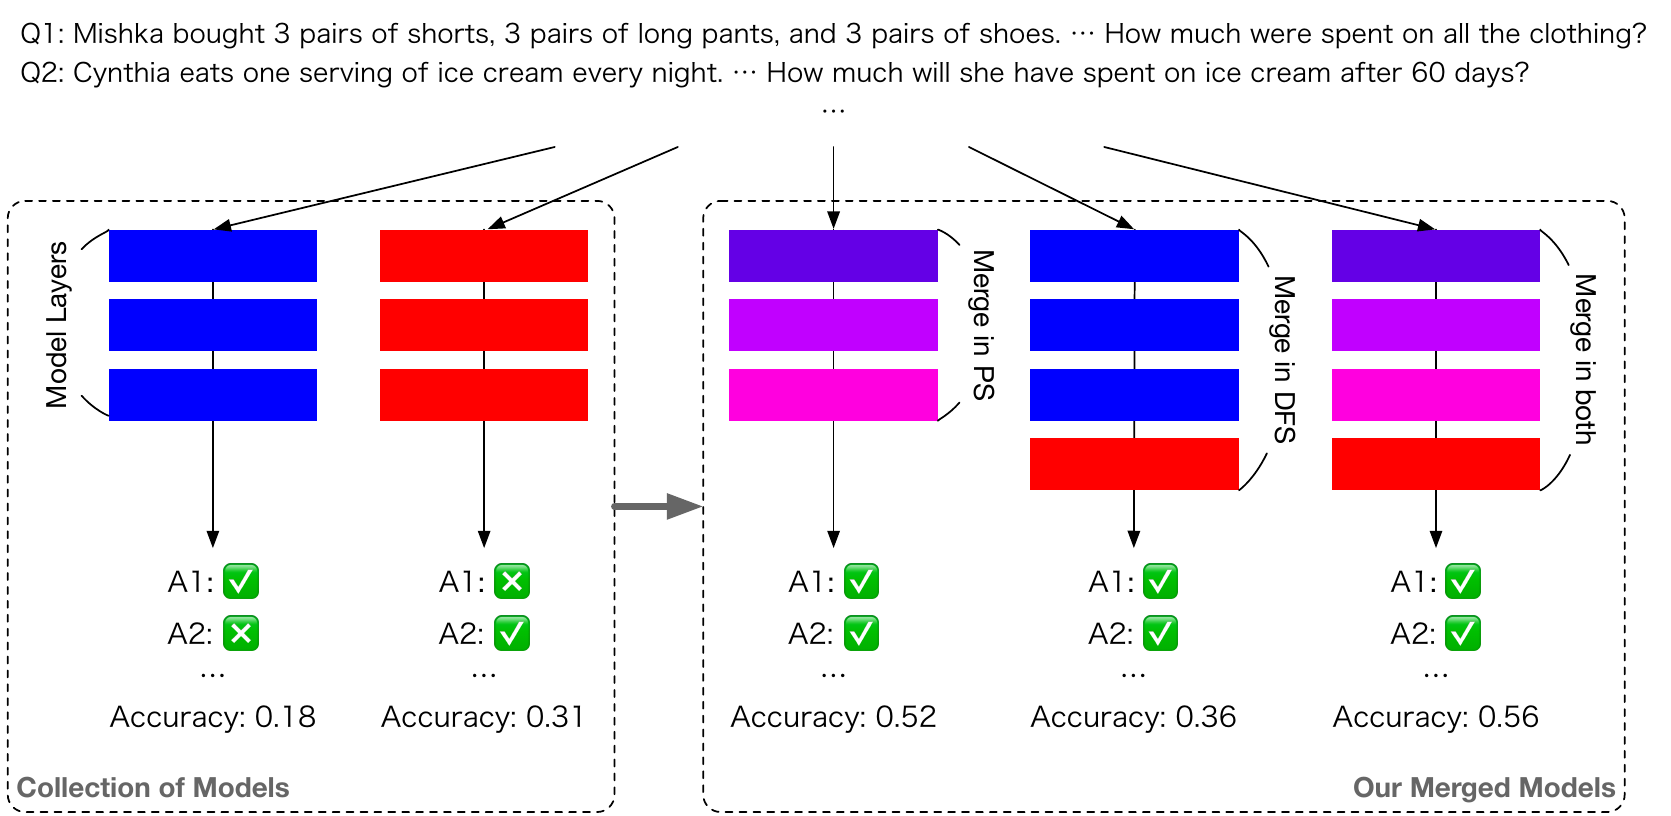
圖上的顏色是一個好用的比喻。參數空間的合併像混顏料,藍加紅變成紫;資料流空間的合併像排積木,每塊積木維持原色,只是重新排順序。
參數空間:讓演化挑係數
在參數空間,作者用的是 TIES-Merging 加上 DARE,但每一層(輸入與輸出的嵌入層,以及每個 Transformer 區塊)都有自己的稀疏化比例與混合權重。這些超參數交給 CMA-ES 演化策略去調,適應度就是目標任務的分數,例如數學題的準確率。
這是框架容許的細粒度設定。主結果最後選用的配方其實更簡單,每個來源模型只用一組 density 與 weight,三個模型共 6 個搜尋變數。作者試過把層分得更細,受限於搜尋資料量,沒有得到明顯改善,因此沒有把最複雜的設定當成主結果。
density 控制 DARE 後留下多少任務差值,weight 控制它在合併中的貢獻,兩者作用不同。演化找到的三組 weight 相近,總和卻接近 2,顯示有效的解包含把任務改動放大;它沒有要求所有係數相加等於 1,所以超出了普通的凸組合。
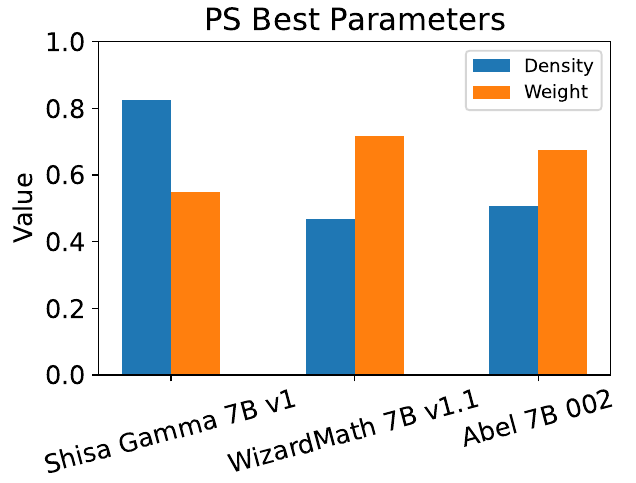
橫軸是三個來源,藍柱看保留比例、橘柱看合併權重。日文模型的藍柱較高,表示它需要保留更多差值;橘柱則沒有把其中任何一個來源壓到接近零。原本的兩種專長都有被使用。
CMA-ES 維持一個搜尋分布,每輪抽一批配方,依任務分數排序,再調整分布的中心、尺度和方向。單一候選先做權重合併,再在指定資料上生成答案、計算分數;沒有對合併後模型做梯度更新。這樣即使適應度是「答案數字正確且使用日文」這種離散指標,也能直接搜尋。
資料流空間:讓演化挑路徑
資料流空間的搜尋要麻煩得多。假設兩個模型各 32 層,總共 層,推論路徑長度 ,每一步可以選任何一層或跳過,搜尋空間是 ,大得無法搜尋。
作者用初步實驗縮小範圍。他們發現,重複或亂序地使用前面的層,往往會讓表現變差。所以改成把所有層依原本的順序排好、重複 次,得到長度 的序列,再用一個指示陣列 決定每個位置的層要不要用。搜尋空間變成 ,仍然很大,但演化搜尋可以處理。
另一個問題是,一層收到的輸入,可能來自另一個模型的層,分布和它訓練時看到的不一樣。作者的初步研究發現,連把相鄰兩層對調都會讓表現下降。他們的補救是在每次從第 層跳到第 層時,把輸入乘上一個縮放係數 ,這個矩陣也一起演化。
假設先把 A 的 32 層、B 的 32 層接起來,再重複 3 次,就有 192 個候選位置。指示值大於 0 的位置留下,其他跳過;同一個原始層可以在不同重複段落再被用一次。最後選中的路徑是固定的,所有 token 都走同一條線,沒有依輸入內容選專家的 router。
搜尋還固定使用模型 A 的 tokenizer、輸入和輸出嵌入,路徑也從 A 的第一個 Transformer 層開始、在 A 的最後一層結束,維持和嵌入空間的銜接。同一模型內原本相鄰的兩層,縮放固定為 1;真正跨模型或跳層的地方,才讓搜尋調整尺度。來源模型的 hidden size 等介面仍必須接得起來,DFS 放寬了層數與路徑,沒有讓任意模型都能直接串接。
下圖把搜尋初期、中期、結束的路徑並排。橫軸是執行的步數,縱軸是取用的來源層,藍、紅分別來自兩個模型,顏色深淺對應縮放大小。
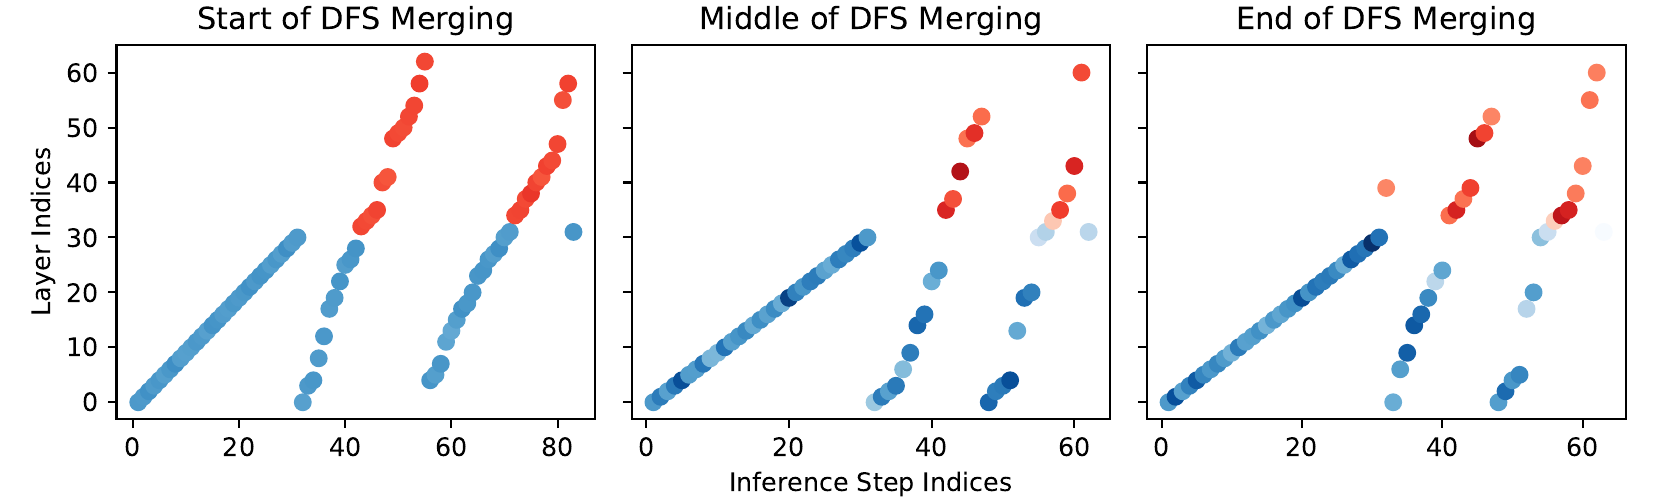
右圖前段幾乎連續沿用藍色來源,之後才加入紅色層與跳接。這份路徑使用 PS 合併模型與日文模型作來源,最後得到的是較長的 10B 網路,已經改變了部署架構。
兩者都用
兩種合併可以接起來。先在參數空間合併出一個模型,把它放回候選模型的集合,再做資料流空間的合併。
討論
日文數學模型
主要實驗是做一個能用日文解數學題的模型。來源模型有三個,都從 Mistral-7B-v0.1 微調而來,分別是日文模型 Shisa Gamma 7B v1,以及英文數學模型 WizardMath 7B v1.1 和 Abel 7B 002。
評測用 MGSM 的日文測試集,250 題,是 GSM8K 測試集前 250 題的翻譯。答對的條件有兩個,最後的數字要正確,推理過程要用日文寫。演化搜尋時用的是另外翻譯的 GSM8K 測試集 ID 為 250 到 1318 的 1,069 題(ID 從 0 起算),和最終評測完全不重疊。作者沒有翻譯 GSM8K 的訓練集,因為開源的數學模型都用它訓練過,拿來評估會不準。
| 模型 | 大小 | MGSM-JA | JP-LMEH |
|---|---|---|---|
| Shisa Gamma 7B v1(日文) | 7B | 9.6 | 66.1 |
| WizardMath 7B v1.1(英文數學) | 7B | 18.4 | 60.1 |
| Abel 7B 002(英文數學) | 7B | 30.0 | 56.5 |
| 合併:參數空間 | 7B | 52.0 | 70.5 |
| 合併:資料流空間 | 10B | 36.4 | 53.2 |
| 合併:兩者都用 | 10B | 55.2 | 66.2 |
| Llama 2 70B | 70B | 18.0 | 64.5 |
| Japanese StableLM 70B | 70B | 17.2 | 68.3 |
| Swallow 70B | 70B | 13.6 | 71.5 |
| GPT-3.5 | – | 50.4 | – |
| GPT-4 | – | 78.8 | – |
整理自原論文 Table 1。MGSM-JA 是日文數學題的準確率;JP-LMEH 是日文語言能力評測的平均分數。
三個來源模型都不行。日文模型不會算數學,數學模型的日文不夠好,MGSM-JA 都在 30 以下。
參數空間的合併一下子到了 52.0,還維持 7B 的大小。資料流空間的合併也有進步,但只到 36.4,模型還變成 10B。兩者都用最好,55.2,略高於 GPT-3.5 的 50.4,離 GPT-4 的 78.8 還很遠。
日文的綜合能力(JP-LMEH)上,參數空間的合併是 70.5,高於 Japanese StableLM 70B 的 68.3 和 Llama 2 70B 的 64.5,但仍低於 Swallow 70B 的 71.5。論文說的「勝過一些先前的 70B 日文模型」,指的是這一欄。
作者還逐題畫出各模型答對的題目。合併模型保留了來源模型會做的題,也答對了一些三個來源模型都答錯的題。附錄裡還有幾個例子,題目同時需要日本文化的知識和數學能力;作者認為,這類題目就算翻成英文交給英文數學模型,也可能因為不懂背景而答錯。
和手調配方、微調相比
演化到底幫了多少?作者用 mergekit 做了三個沒有經過最佳化的基準,超參數照一份廣為流傳的 mergekit 教學(Maxime Labonne 在 Hugging Face 部落格上的文章)設定,來源模型和演化合併相同:
| 方法 | MGSM-JA | JP-LMEH |
|---|---|---|
| TIES-Merging(教學預設值) | 4.4 | 63.7 |
| DARE-TIES(教學預設值) | 35.2 | 66.3 |
| Frankenmerge 疊層(教學預設值) | 0.0 | 16.1 |
| 演化合併:參數空間 | 52.0 | 70.5 |
| 演化合併:兩者都用 | 55.2 | 66.2 |
| 用同樣 1,069 題做 LoRA 或全參數微調,最好的一組 | 43.2 | 55.9 |
整理自原論文 Table 3。
照預設值合併,TIES 幾乎把數學能力合沒了,疊層的版本更是一題都答不出來;DARE-TIES 好一些,只比來源模型略高。同樣的模型、同樣的方法,配方調得好不好,差距可以有幾十分。
微調也比不上。作者用演化搜尋時用的同一批 1,069 題,對三個來源模型分別做 LoRA 和全參數微調,最好的只有 43.2;而且微調後,日文綜合能力常常明顯下降,作者認為這反映了微調需要更多資料,也容易遺忘。
作者也測了在候選模型裡混進無關的模型。混進 8 個無關模型時,參數空間合併的 MGSM-JA 從 50.0 降到 40.8,仍然高於所有來源模型。
這個無關模型實驗另外加了 weight normalization,因此起點是 50.0,和主結果的 52.0 分開比較。模型池增加到最多十一個,搜尋也多了選擇負擔;它顯示錯放一些來源仍能得到可用結果,同時也保留了人工選模的重要性。
LoRA 與全參數微調的對照則固定資料量,分別搜尋三個學習率、跑 3 個 epochs。它能回答「只有這 1,069 題時,哪種利用方式較有效」,尚未比較把所有來源模型的完整訓練資料集中後重練;後者的資料大多沒有公開。演化搜尋本身還做了許多次評測,整體計算量也要和單次微調分開算。
為什麼能合併
這組實驗能成立,有一個容易被忽略的前提,三個來源模型都從同一個 Mistral-7B-v0.1 出發。參數空間的合併仍然是任務向量相加那一套,演化則替它搜尋配方中的係數。
作者也提到一個困難。Shisa Gamma 7B v1 的基底經過了 1,000 億個日文 token 的持續預訓練,和原始 Mistral 的權重差距比一般微調大得多,比較不好稀疏化。這和 DARE 論文的觀察一致,delta 越大,越難靠丟棄來減少干擾。
日文視覺語言模型
同樣的方法也用在視覺語言模型上。VLM 把圖片送進視覺編碼器,再經投影網路轉成語言模型能接收的表示,最後由語言模型作答。作者固定前面兩個元件,只把 LLaVA-1.6-Mistral-7B 裡的語言模型和 Shisa Gamma 合併,做出 EvoVLM-JP。兩者仍共享 Mistral 基底,視覺編碼器本身沒有被平均。
搜尋用 Japanese Visual Genome 的另一份子集,測試則分成一般 VQA 的 500 題,以及作者整理的日本文化場景,後者有 42 張圖片、50 道問題,經人工作過濾。指標是日文 ROUGE-L;偵測到非日文回答時原則上給 0,參考答案本來就使用 UFO 這類常見外語縮寫時另有例外。
| 模型 | 大小 | JA-VG-VQA-500 | 日本文化場景 |
|---|---|---|---|
| LLaVA-1.6-Mistral-7B | 8B | 14.3 | 41.1 |
| Japanese Stable VLM | 8B | – | 40.5 |
| EvoVLM,PS | 8B | 19.7 | 51.2 |
| EvoVLM,DFS | 12B | 16.8 | 46.5 |
| EvoVLM,PS+DFS | 11B | 20.4 | 47.6 |
ROUGE-L,越高越好,整理自原論文 Table 5。Japanese Stable VLM 訓練使用過 Japanese Visual Genome,因此該欄未評測。
一般 VQA 是 PS+DFS 最好,文化場景卻是 PS 最好;路徑更深、組合更複雜,沒有在所有測試都占優勢。ROUGE-L 量的是和參考答案的文字重合,再加上語言限制,還不能涵蓋文化理解的所有面向。附錄的鯉魚旗、日文交通號誌顏色稱呼等案例,可以補充看它到底改好了哪些回答。
路徑與縮放,各有多少作用
作者把同一套方法放到 Llama-2-13B 的日文與數學專家上。來源模型 MGSM-JA 分別是 13.2% 和 8.0%,PS 合併到 31.2%,PS+DFS 到 34.0%,後者有 21B 參數。它比這兩個來源好,仍低於 Mistral 系列的 7B/10B 合併結果,顯示來源模型能力的重要性。
DFS 的起始順序也會影響搜尋。13B 那組把兩個來源的順序對調,測試成績從 23.2% 變成 12.8%;初始化偏向先保留模型 A 的原始路徑,能減少一開始就生成亂文的候選,代價是順序偏好。這是縮小搜尋空間換來的限制。
在 PS+DFS 中拿掉跨層縮放,MGSM-JA 是 26.4%,完整版本是 34.0%;兩者搜尋出的模型大小也不同,分別為 19B 與 21B。這組消融支持尺度對齊有幫助,不能把全部差距都當成固定架構下單一縮放參數的效果。作者也觀察到,來源微調得太久、表示差異太大時,單一縮放仍不足以銜接。
代價與限制
演化合併利用已訓練模型,省下重新學習這些能力的梯度訓練。作者拿來比較的 japanese-stablelm-base-gamma-7b,日文持續預訓練用了 1,000 億個 token,估計超過一萬個 GPU 小時;這個估計和演化搜尋的實測時間並未做成同硬體的成本對照。
PS 做 1,000 次配方試驗,每次用全部 1,069 題算適應度;DFS 用 128 個候選、100 個世代,訓練子集裡保留最後 200 題當驗證,搜尋時每批評 200 題。前者把權重混合好再評,後者還得保存來源層與執行變長路徑,GPU 記憶體需求更高。無關模型的 DFS 實驗就因這項需求而沒有做。真正昂貴的部分,是大量候選的生成與評分。
作者也坦白寫了限制。合併模型會繼承來源模型的缺點,有時答案缺乏邏輯一致性;這項研究也沒有做指令微調或對齊,輸出可能有事實錯誤。
結論
這篇論文把社群裡靠直覺調的合併配方,交給演化演算法去搜尋。參數空間的部分是 TIES 加 DARE,主結果只搜尋每個來源模型的 density 與 weight;資料流空間的部分則是重新安排推論路徑。日文數學這個例子裡,三個都不及格的 7B 模型,合併後超過了 GPT-3.5。
成本也要算清楚。合併本身不用訓練,但演化搜尋需要反覆評估候選模型,參數空間跑了 1,000 次試驗,每次都要在一千多題上評分;換一個任務,就得重新搜尋一次。
想照著做,可以先把來源模型控制在少數幾個,從全模型的 density 與 weight 搜尋開始,留一份完全不參與搜尋的測試資料。等這組比較有收益,再增加逐層自由度或 DFS 路徑,會比較容易知道多花的評測到底換到了什麼。