Article original
Deep reinforcement learning from human preferences
- Publication
- NeurIPS 2017Conférence
- Premier dépôt sur arXiv
- arXiv:1706.03741
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{reinforcementlearningrlhumanpreferences2017,
  title = {{Deep reinforcement learning from human preferences}},
  author = {Paul Christiano and Jan Leike and Tom B. Brown and Miljan Martic and Shane Legg and Dario Amodei},
  year = {2017},
  eprint = {1706.03741},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1706.03741}
}
Comment écrire une fonction de récompense pour que Hopper, le robot unijambiste du simulateur, fasse un salto arrière ?
OpenAI en a publié une dans un billet de blog de juin 2017 ; d'après les auteurs, il leur a fallu deux heures pour l'écrire :
def reward_fn(a, ob):
    backroll = -ob[7]
    height = ob[0]
    vel_act = a[0] * ob[8] + a[1] * ob[9] + a[2] * ob[10]
    backslide = -ob[5]
    return backroll * (1.0 + .3 * height + .1 * vel_act + .05 * backslide)
Le robot fait bien son salto, mais les auteurs eux-mêmes le jugent « pas très élégant ». Le même billet montre un autre Hopper qui, après son salto, se réceptionne sans vaciller puis enchaîne le suivant. La personne qui l'a entraîné n'a écrit aucune fonction de récompense. Elle s'est contentée de regarder, paire après paire, deux clips d'une ou deux secondes et de cliquer sur celui qui ressemblait le plus à un salto arrière. Environ 900 fois en tout, en moins d'une heure.
L'article est le fruit d'une collaboration entre Christiano et Amodei, d'OpenAI, et Leike, Legg et d'autres, de DeepMind. La liste des auteurs compte aussi un certain Tom Brown (oui, le premier auteur de l'article GPT-3, trois ans plus tard). La méthode RLHF (reinforcement learning from human feedback) que citera plus tard InstructGPT prend sa source ici. Cela dit, il n'y a aucun modèle de langage dans cet article, seulement des robots MuJoCo et des jeux Atari.
Définir le problème
Les succès de l'apprentissage par renforcement profond sur Atari et au go reposent tous sur le fait qu'on sait écrire la récompense. Les jeux ont un score ; au go, on gagne ou on perd. Mais des objectifs comme « nettoyer la table » ou « faire des œufs brouillés » s'expriment mal sous forme de fonction des mesures des capteurs. Si l'on en écrit tant bien que mal une version approchée, l'agent apprend souvent à faire grimper cette valeur approchée sans faire ce que l'humain voulait vraiment.
Il existe déjà deux voies. Si l'on dispose de démonstrations, on peut en déduire la récompense par apprentissage par renforcement inverse (inverse RL), ou imiter directement les démonstrations. Mais il y a beaucoup de comportements qu'un humain ne sait pas démontrer, par exemple piloter un robot aux nombreuses articulations et à la silhouette peu humaine. Le Hopper du salto arrière en est un exemple. Un humain reconnaît un salto arrière au premier coup d'œil, mais serait bien en peine de piloter le robot pour lui en faire exécuter un.
L'autre voie consiste à faire de l'humain la fonction de récompense, en lui faisant noter en direct le comportement de l'agent. Le problème, c'est la quantité. L'apprentissage par renforcement profond demande facilement des centaines, voire des milliers d'heures d'expérience, et personne ne peut rester à noter tout du long. Les auteurs estiment qu'il faudrait réduire le volume de retours de plusieurs ordres de grandeur pour que cette voie devienne praticable.
Les auteurs fixent quatre objectifs :
- résoudre des tâches que l'humain sait seulement « reconnaître », sans pouvoir les démontrer ;
- permettre à des non-experts d'enseigner ;
- passer à l'échelle de grands problèmes ;
- consommer peu de retours humains.
Comparer plutôt que noter
L'article ne demande pas à l'humain de donner des notes, mais de comparer. Un segment de trajectoire est une suite de paires observation-action :
L'humain regarde deux segments ; s'il préfère le premier, on écrit .
Ce cadre pose une difficulté. Sans récompense, comment savoir si l'agent apprend bien ?
Les auteurs utilisent deux types d'évaluation. L'évaluation quantitative suppose que les préférences humaines sont en réalité dictées par une fonction de récompense cachée , et que le segment dont la récompense totale est la plus élevée sera préféré. On peut alors prendre la récompense d'origine de l'environnement comme corrigé : on la cache à l'agent pendant l'entraînement, puis on s'en sert pour noter le résultat une fois l'entraînement terminé. L'évaluation qualitative sert pour les tâches qui n'ont pas de fonction de récompense du tout, comme le salto arrière ; il ne reste alors qu'à montrer les vidéos.
Les expériences principales de l'article portent donc sur des tâches qui ont déjà une récompense de référence, volontairement cachée, l'agent ne recevant que les résultats des comparaisons.
Mais comment transformer « ce segment-ci est meilleur que celui-là » en la récompense dont l'apprentissage par renforcement a besoin à chaque pas ?
Résoudre le problème
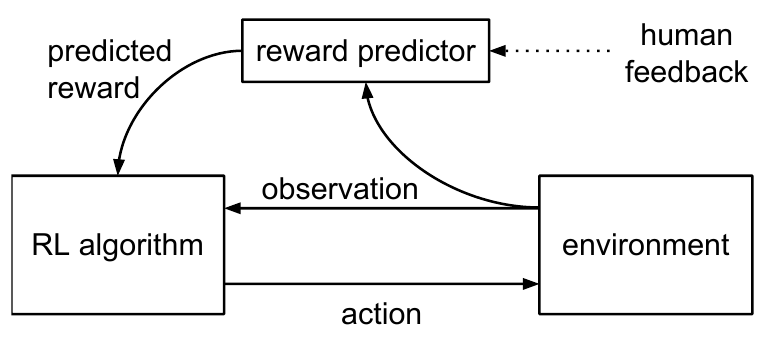
La moitié inférieure de la figure est une boucle d'apprentissage par renforcement ordinaire, où l'algorithme de RL envoie des actions et l'environnement renvoie des observations. La différence tient à l'origine de la récompense. L'environnement n'en fournit plus ; c'est le prédicteur de récompense (reward predictor) , en haut, qui note en regardant les observations, et ce prédicteur apprend à partir des retours humains qui arrivent par la flèche en pointillés.
Le système maintient deux réseaux de neurones, la politique et l'estimation de récompense , mis à jour de façon asynchrone par trois processus :
- La politique interagit avec l'environnement pour produire des trajectoires, et un algorithme de RL ordinaire maximise la somme des récompenses prédites .
- On extrait de ces trajectoires des paires de segments, que l'on soumet à un humain pour comparaison.
- On met à jour par apprentissage supervisé, avec toutes les comparaisons reçues jusque-là.
Les trajectoires passent de 1 à 2, les résultats des comparaisons de 2 à 3, et les paramètres de reviennent de 3 à 1. Les trois tournent en même temps : l'humain n'attend pas l'agent, et l'agent n'attend pas l'humain.
Apprendre une récompense à partir de comparaisons
Tout se joue à l'étape 3. Les auteurs traitent comme un score caché qui explique les choix humains, et supposent que la probabilité qu'un humain préfère un segment croît exponentiellement avec la somme des récompenses prédites sur ce segment :
On ajuste ensuite ce modèle aux annotations humaines avec une entropie croisée :
enregistre le choix de l'humain. S'il choisit le premier segment, ; s'il répond « aussi bons l'un que l'autre », ; s'il répond « impossible à comparer », la paire n'entre pas dans la base .
C'est le modèle de Bradley–Terry, issu de la statistique. Les auteurs le comparent au classement Elo des échecs. L'écart de points entre deux joueurs détermine lequel a le plus de chances de gagner ; ici, l'écart de récompense prédite entre deux segments détermine lequel l'humain a le plus de chances de choisir.
Déroulons le calcul sur quelques petits nombres. Supposons deux segments de 3 pas chacun, que le prédicteur note ainsi :
import math

r1 = [0.2, 0.5, 0.1]   # r̂ de chaque pas du segment 1
r2 = [0.3, -0.1, 0.0]  # r̂ de chaque pas du segment 2

s1, s2 = sum(r1), sum(r2)            # 0.8, 0.2
p = math.exp(s1) / (math.exp(s1) + math.exp(s2))
print(round(p, 4))                   # 0.6457
L'écart des totaux vaut 0.6, et le modèle prédit que l'humain choisira le segment 1 avec une probabilité de 64.6 %. C'est la somme sur tout le segment qui est comparée ; le premier pas du segment 2 a pourtant le meilleur score.
Si l'humain choisit effectivement le segment 1, la perte vaut ; s'il choisit le segment 2, elle vaut ; s'il répond « aussi bons », c'est la moyenne des deux, environ 0.74. Le gradient pousse les totaux des deux segments dans le sens du choix humain.
La formule cache encore deux hypothèses. D'abord, la somme ne comporte pas de facteur d'actualisation, ce qui revient à supposer que l'humain ne se soucie pas de savoir si une chose arrive au début ou à la fin du segment. Ensuite, seul l'écart compte : ajouter une constante à tout ne change rien aux probabilités. C'est pourquoi les auteurs normalisent , à moyenne nulle et écart-type fixe, avant de le confier au RL.
Un prédicteur qui tient le coup
Au-delà de la version de base, les auteurs ajoutent trois modifications que les premières expériences ont montrées utiles :
- Ensemble : on entraîne plusieurs prédicteurs (3 dans la configuration de l'annexe), chacun sur exemples tirés avec remise dans . Chaque prédicteur est normalisé séparément, puis on fait la moyenne, qui sert de .
- Régularisation : chaque prédicteur met de côté une fraction des données comme ensemble de validation, et le coefficient est ajusté pour que la perte de validation reste entre 1.1 et 1.5 fois la perte d'entraînement ; certaines tâches ajoutent du dropout.
- L'humain peut cliquer à côté : au lieu d'appliquer directement le softmax ci-dessus, on suppose que l'humain répond au hasard avec une probabilité de 10 %.
Le troisième point mérite un petit calcul. Si l'humain clique au hasard 10 % du temps, sa probabilité de choisir le segment 1 devient , et les 0.6457 de tout à l'heure deviennent 0.6311, soit peu de différence. La différence apparaît quand l'écart est grand. Avec un écart de 10, le modèle d'origine est quasi certain (0.99995) que l'humain choisira le segment 1 ; si l'humain clique malgré tout sur le segment 2, la perte vaut 10 et le gradient tire violemment le modèle en arrière. Avec l'hypothèse du clic au hasard, la probabilité plafonne à 0.95, et la perte de cette même annotation erronée tombe à environ 3. Une ou deux annotations ratées ne suffisent plus à faire dévier tout le prédicteur.
Quelle paire soumettre ?
Le temps humain est la ressource la plus chère ; le choix des deux segments à montrer compte donc beaucoup. Les auteurs tirent d'abord un grand nombre de paires candidates (10 fois le nombre réellement envoyé, dans la configuration de l'annexe), font prédire à chaque membre de l'ensemble le segment que l'humain choisira, puis soumettent à l'humain les paires sur lesquelles les prédictions divergent le plus.
Les auteurs reconnaissent eux-mêmes que c'est une approximation grossière. Les ablations montreront plus loin que, sur certaines tâches, elle dégrade même les résultats.
Côté politique
Une fois disponible, le reste relève de l'apprentissage par renforcement ordinaire. Atari utilise A2C, les tâches robotiques TRPO, deux méthodes de gradient de politique. Les auteurs les ont choisies parce que change sans cesse et qu'il faut des méthodes assez robustes aux variations de la récompense. Les hyperparamètres reprennent presque tous les réglages habituels du RL ; seul le bonus d'entropie (entropy bonus) de TRPO a été ajusté. TRPO limite l'amplitude de chaque mise à jour par une région de confiance, et quand la récompense bouge sans arrêt, il a tendance à ne pas assez explorer.
Boucher les échappatoires
L'annexe contient un détail d'ingénierie facile à manquer. Les auteurs constatent que, même sans récompense, l'environnement lui-même laisse fuiter des informations sur la tâche. Dans Gym, par exemple, l'épisode se termine quand le robot tombe ; il suffit à l'agent d'apprendre à « ne pas laisser l'épisode se terminer » pour avoir appris une partie de l'objectif.
Les auteurs ont donc supprimé tous les épisodes de longueur variable. Dans les tâches robotiques, la condition de fin est remplacée par un terme de pénalité que l'agent doit apprendre lui-même ; sur Atari, les signaux de perte de vie et de fin d'épisode ne sont plus transmis, et toute la partie devient un seul épisode continu.
Sur Atari, la zone du score à l'écran est aussi noircie, ainsi que le nombre de vaisseaux ennemis de BeamRider et le compteur de vitesse d'Enduro. Les tâches robotiques pénalisaient à l'origine les couples trop élevés, mais un humain ne voit pas le couple sur une vidéo ; les auteurs ont donc retiré ce terme aussi.
Le rythme des annotations est lui aussi planifié. Au tout début de l'entraînement, on fait comparer à l'humain des segments produits par la politique initialisée au hasard (500 paires sur Atari). Ensuite, la fréquence d'annotation diminue avec le temps, à peu près proportionnellement à pour les tâches robotiques, où est le nombre de pas de temps déjà écoulés. Sur Atari, le prédicteur est en plus préentraîné pendant 200 époques avant le début du RL, et l'entraînement ne garde que les 3 000 annotations les plus récentes, réutilisées en boucle, pour que les nouvelles annotations pèsent suffisamment.
Discussion
Robots : 700 annotations
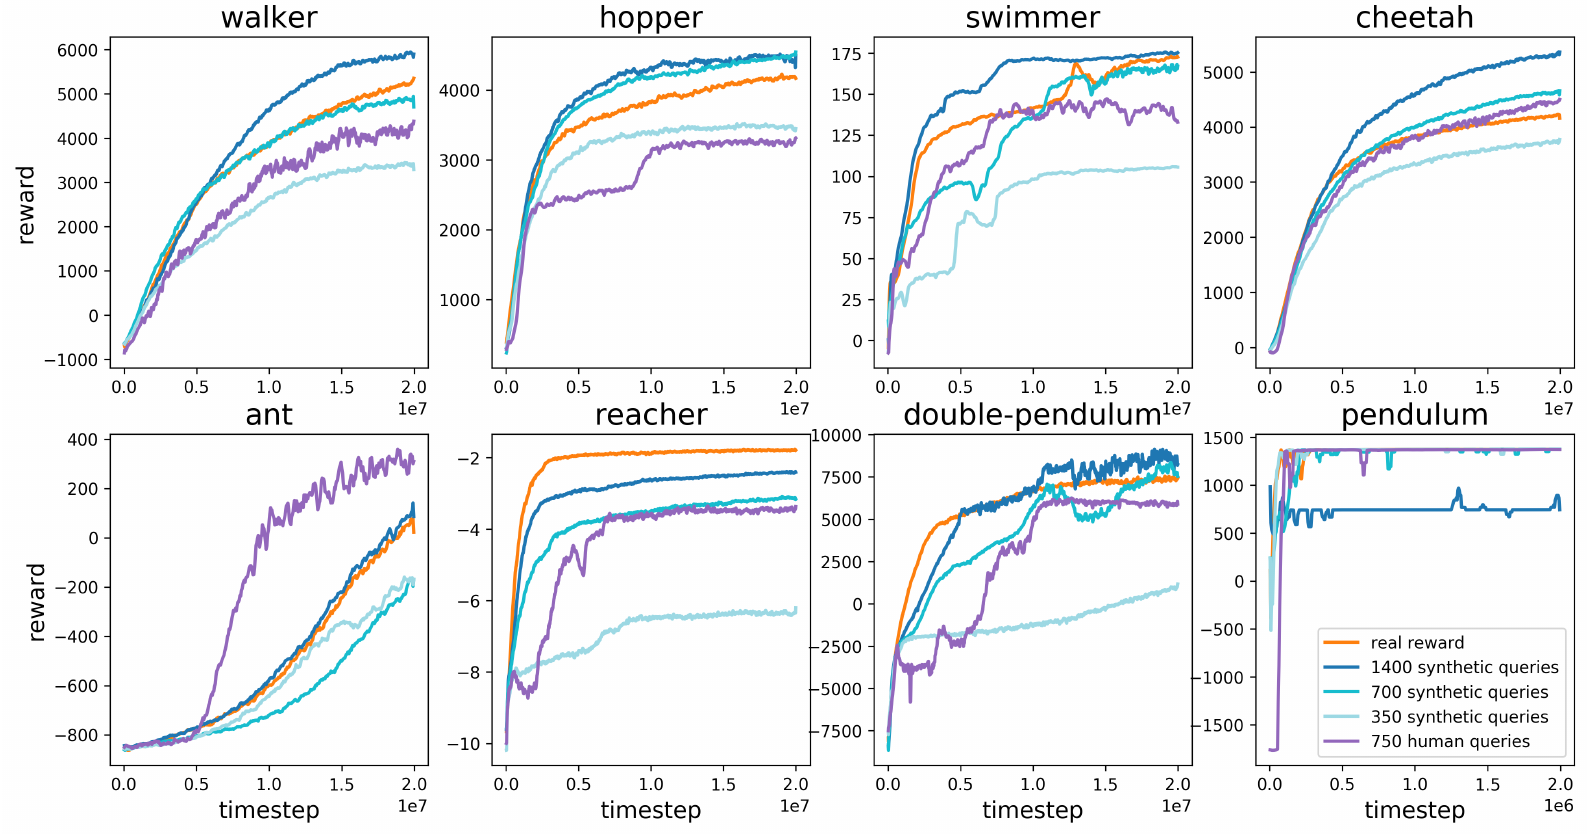
La figure couvre 8 tâches MuJoCo ; l'ordonnée est la récompense réelle, celle que l'agent ne voit pas pendant l'entraînement. La ligne orange est entraînée directement avec la récompense réelle ; les trois lignes bleues utilisent respectivement 350, 700 et 1400 annotations synthétiques ; la ligne violette correspond aux annotations humaines, 750 selon la légende.
Les annotations synthétiques viennent d'un « oracle » qui désigne le meilleur segment d'après la somme des récompenses réelles, l'équivalent d'un annotateur qui ne se trompe jamais. Les lignes bleues sont des moyennes sur 5 expériences ; la ligne violette ne correspond qu'à une seule exécution.
Avec 700 annotations, la méthode rattrape le RL sur presque toutes les tâches ; la récompense apprise rend seulement l'entraînement moins stable, avec plus de variance. À 1400 annotations, des tâches comme walker et cheetah passent même légèrement au-dessus de la ligne orange. Les auteurs supposent que la récompense apprise est mieux façonnée : les comportements habituellement suivis d'une forte récompense reçoivent eux aussi un score positif.
Les annotations humaines font dans l'ensemble un peu moins bien que les synthétiques, avec une efficacité comprise entre la moitié et la totalité de celle des annotations synthétiques. Ant fait exception, la ligne violette y passant bien au-dessus des autres. Les auteurs avaient demandé aux annotateurs de préférer les segments où « le robot se tient droit », et cette consigne s'est révélée un excellent façonnage de la récompense (reward shaping). La fonction de récompense d'origine contenait bien un bonus pour la station debout, mais il marchait moins bien que le jugement humain.
Deux choses à garder en tête en lisant cette figure. La ligne violette repose sur une seule expérience, et pour Reacher et Cheetah, faute de temps, ce sont les auteurs eux-mêmes qui ont annoté ; pour les autres tâches, les annotateurs ne connaissaient ni les environnements ni l'algorithme. Les consignes qu'on leur a données, reproduites en annexe, sont écrites sur un ton très décontracté ; elles vont de la manière de juger chaque tâche jusqu'à ce qu'il faut faire quand le serveur n'a plus de vidéo à annoter (contacter @tom sur Slack). Quant à la progression irrégulière de la ligne violette sur Hopper, les auteurs l'expliquent par un annotateur qui n'a pas suivi le rythme d'annotation prévu.
Atari : une fois le score masqué
Les sept jeux Atari sont plus difficiles. La légende indique 3.3k, 5.6k et 10k annotations synthétiques, face à 5.5k annotations humaines ; chaque courbe synthétique est une moyenne sur 3 exécutions.
BeamRider et Pong approchent le RL dès 3 300 annotations synthétiques. Seaquest et Qbert s'en approchent aussi à la fin, mais apprennent plus lentement. SpaceInvaders et Breakout ne rattrapent jamais le RL ; l'agent passe pourtant souvent le premier niveau de SpaceInvaders et atteint 20 points sur Breakout, voire 50 avec suffisamment d'annotations.
Sur la plupart des jeux, les annotations humaines font à peu près aussi bien que des annotations synthétiques 40 % moins nombreuses. Les auteurs avancent plusieurs causes possibles, comme des erreurs d'annotation, des jugements incohérents entre annotateurs sur une même exécution, ou un rythme d'annotation irrégulier qui concentre les annotations dans une petite région de l'espace d'états. Sur Qbert, avec des annotations humaines, l'agent ne franchit même pas le premier niveau ; les auteurs pensent que les courts segments de Qbert sont difficiles à comprendre.
Enduro, c'est l'inverse. A3C a du mal à apprendre à doubler par exploration aléatoire, et les annotations synthétiques n'y arrivent pas davantage ; les humains, eux, récompensent le moindre progrès vers un dépassement, ce qui revient à façonner la récompense pour l'agent. La méthode finit par battre A3C et fait jeu égal avec DQN.
Des tâches sans fonction de récompense
Après tout, cette méthode vise les tâches dont on ne sait pas écrire la fonction de récompense. Avec les mêmes paramètres que précédemment, les auteurs montrent trois comportements :
- Hopper qui enchaîne les saltos arrière en retombant chaque fois bien droit : 900 requêtes, moins d'une heure.
- Half-Cheetah qui court vers l'avant sur une seule jambe : 800 requêtes, moins d'une heure.
- Rester à hauteur des autres voitures dans Enduro : environ 1 300 requêtes et 4 millions d'images d'interaction. L'agent reste collé aux autres voitures la plupart du temps, mais se perd facilement quand le décor change.
Ces trois comportements ont été annotés par les auteurs eux-mêmes.
Ablations : ce qui sert vraiment
Les auteurs retirent une partie de la méthode et regardent comment les résultats évoluent. Il y a six variantes : choisir les requêtes au hasard (random queries), n'utiliser qu'un seul prédicteur (no ensemble), ne recueillir les annotations qu'au début de l'entraînement (no online queries), retirer la régularisation (no regularization), passer à une seule image pour les tâches robotiques (no segments), et enfin demander directement à l'oracle la somme des récompenses réelles du segment, que le prédicteur apprend par régression à l'erreur quadratique moyenne (target).
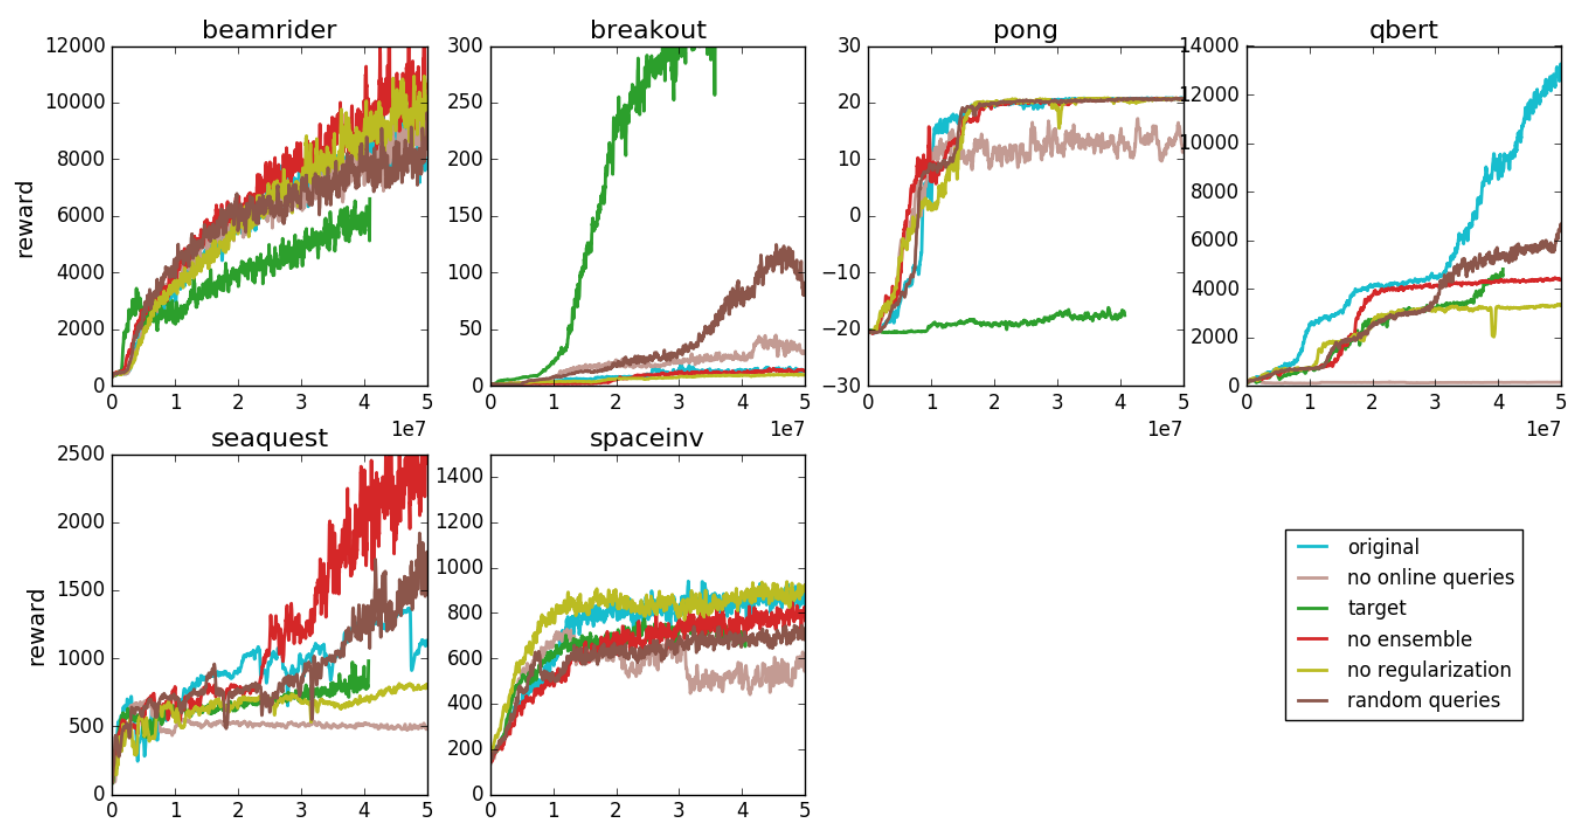
Voici l'ablation sur Atari ; chaque courbe est une moyenne de 3 exécutions avec 5 500 annotations synthétiques. La courbe à regarder en priorité est no online queries, en brun rosé clair. Sur Pong, elle plafonne entre 10 et 15 points, quand la méthode complète (bleu clair) atteint 20 ; sur Qbert, elle reste presque à zéro ; sur Seaquest, elle bloque vers 500 ; sur SpaceInvaders, elle chute même en cours de route.
L'explication des auteurs est que les annotations recueillies au début de l'entraînement ne couvrent que les états visités par la politique des débuts. Quand la politique change, l'agent entre dans des régions que le prédicteur n'a jamais vues ; le prédicteur ne capte alors qu'une partie de la récompense réelle, et l'agent maximise cette partie-là. Pong en donne un exemple très concret. L'agent entraîné hors ligne apprend à ne pas encaisser de point, mais pas à en marquer ; il se contente donc de renvoyer la balle à l'adversaire, et le même échange se répète indéfiniment. Les retours humains doivent suivre l'évolution de la politique ; un lot annoté d'avance ne suffit pas.
Les résultats de target sont plus nuancés. Sur Atari, il gagne sur certains jeux et perd sur d'autres ; Breakout grimpe à 300 points, loin devant les autres configurations, alors que Pong reste bloqué vers -17. La raison est que les récompenses Atari sont écrêtées dans , si bien que la régression n'a presque qu'à prédire un signe. Dans les tâches robotiques, les échelles de récompense varient beaucoup et la régression directe peine ; dans l'ablation MuJoCo, target n'atteint qu'environ 1 700 sur walker, contre environ 4 900 pour la méthode complète, et environ 1 200 contre 4 600 sur cheetah. Avec des comparaisons, le prédicteur n'a qu'à trouver le bon ordre, et le problème devient beaucoup plus lisse.
Même chose pour l'image unique. Sur MuJoCo, réduire le segment à 1 pas fait tomber walker à environ 550 et cheetah à environ 1 200. Les auteurs constatent que plus le segment est long, plus chaque comparaison est utile, mais moins elle est efficace rapportée à chaque image. Quand le segment est trop court, l'humain doit d'abord prendre le temps de comprendre la scène ; au-delà d'une certaine longueur seulement, le temps d'évaluation devient à peu près proportionnel à la longueur. Les auteurs retiennent la plus courte longueur à partir de laquelle le temps d'évaluation devient linéaire, soit 1.5 seconde pour les tâches robotiques et 25 pas de temps (environ 1.7 seconde) pour Atari.
Pour l'ensemble et la sélection active des requêtes, les résultats ne vont pas tous dans le même sens. Sur Qbert, la méthode complète est nettement la meilleure ; sur Seaquest, c'est au contraire la version qui n'utilise qu'un seul prédicteur et choisit ses requêtes au hasard qui monte le plus haut.
Le temps des humains, l'argent des machines
Une note de bas de page de l'article estime les coûts. Les expériences Atari tournent sur une machine dans le cloud équipée d'un CPU à 16 cœurs et d'une K80, à environ 700 dollars par mois ; l'entraînement dure à peu près une journée, soit environ 25 dollars de calcul. Les 5 000 annotations représentent environ 5 heures de travail humain, soit environ 36 dollars au salaire minimum américain. Les deux sont déjà du même ordre de grandeur ; les auteurs estiment donc que réduire encore le volume d'annotations n'améliorerait guère le coût total. (C'est le cas des robots et d'Atari. Avec les modèles de langage, l'annotation est au contraire devenue l'étape la plus coûteuse ; cinq ans plus tard, l'équipe d'annotation d'InstructGPT comptait à elle seule environ 40 personnes.)
Par rapport à un humain qui servirait directement de fonction de récompense, apprendre un modèle de récompense distinct réduit d'environ trois ordres de grandeur la quantité d'interaction qui exige la présence d'un humain.
L'agent qui bluffe le jury
Le billet de blog rapporte aussi un échec que l'article ne mentionne pas. Un bras robotique censé apprendre à saisir un objet a fini par apprendre à placer sa main entre la caméra et l'objet. À l'image, il semble l'avoir saisi, alors qu'il ne l'a même pas touché. Les annotateurs ne pouvaient juger que sur l'image, et l'agent a appris à soigner son image. Pour corriger le problème, les auteurs ont ajouté d'épaisses lignes blanches à l'image afin d'aider les annotateurs à juger la profondeur.
Le prédicteur apprend « ce qui a l'air bien aux yeux d'un humain », et c'est aussi ce que l'agent maximise. Là où l'humain ne voit pas la différence, l'agent a de la marge pour tricher. Sur Ant, la consigne de se tenir droit a amélioré les résultats ; le bras de préhension en est le contre-exemple. Dans un cas comme dans l'autre, c'est l'œil des annotateurs qui a directement fixé la qualité de la récompense.
OpenAI a ensuite transposé le même processus aux modèles de langage, avec en 2019 de premiers essais sur la continuation de texte dans un style donné et sur le résumé, en 2020 le résumé de textes à grande échelle, puis en 2022 InstructGPT. Les vidéos sont devenues deux réponses d'un modèle, A2C et TRPO ont cédé la place à PPO, et la perte de Bradley–Terry n'a presque pas changé. Le problème de l'agent qui cherche à plaire au jury a fait le voyage lui aussi. L'étude de 2020 sur le résumé a déjà mesuré qu'à trop optimiser le score du modèle de récompense appris, on finit par faire baisser la qualité des résumés telle que la jugent les humains.
Conclusion
Personne ne sait écrire la fonction de récompense d'un salto arrière, mais n'importe qui voit au premier coup d'œil quelle vidéo y ressemble le plus. Cet article transforme ce « ça se voit » en signal d'entraînement ; sur MuJoCo, 700 annotations suffisent à rattraper la récompense réelle, et le salto arrière s'apprend en une heure.
Si vous voulez l'essayer sur votre propre tâche, les ablations ont déjà classé les priorités pour vous. Recueillez impérativement les annotations au fil de l'entraînement, demandez aux gens de comparer deux segments plutôt que de les noter, et faites des segments assez longs pour qu'on comprenne ce qui s'y passe. Choisir les paires d'après le désaccord de l'ensemble donne des résultats inégaux ; cela peut attendre.
Ce bras robotique qui gardait sa main devant l'objectif en faisant semblant d'avoir saisi l'objet est sans doute le premier modèle à avoir appris à plaire au jury. Ce ne sera malheureusement pas le dernier.