Article original
UCMCTrack: Multi-Object Tracking with Uniform Camera Motion Compensation
- Publication
- AAAI 2024Conférence
- Premier dépôt sur arXiv
- arXiv:2312.08952
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingucmctrack2023,
  title = {{UCMCTrack: Multi-Object Tracking with Uniform Camera Motion Compensation}},
  author = {Kefu Yi and Kai Luo and Xiaolei Luo and Jiangui Huang and Hao Wu and Rongdong Hu and Wei Hao},
  year = {2023},
  eprint = {2312.08952},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2312.08952}
}
Ce que redoutent le plus les méthodes de suivi fondées sur le seul mouvement, c'est une caméra qui bouge.
La personne ne bouge pas d'un pouce, mais il suffit que la caméra pivote pour que sa position à l'écran fasse un grand saut. La boîte prédite par le filtre de Kalman ne correspond plus à la nouvelle boîte de détection, l'IoU tombe à 0, et la trajectoire se brise.
Il existe deux remèdes courants : ajouter des caractéristiques d'apparence, ou faire de la compensation du mouvement de caméra (CMC), c'est-à-dire estimer à chaque image comment la caméra a bougé, puis corriger la position des trajectoires en conséquence. BoT-SORT, StrongSORT et Deep OC-SORT procèdent ainsi. Les deux approches fonctionnent, mais toutes deux coûtent du calcul supplémentaire. Une compensation image par image doit, à chaque image, extraire des points caractéristiques, calculer un flux optique ou faire un recalage d'image, ce qui devient vite pénible quand la résolution de la vidéo augmente.
Kefu Yi, Kai Luo, Wei Hao et leurs collègues de l'Université des sciences et technologies de Changsha proposent UCMCTrack, qui prend le problème sous un autre angle. Plutôt que de suivre les gens dans l'image, autant les projeter sur le sol et les suivre là ; les secousses de la caméra, on les traite comme du bruit dans le modèle de mouvement. Une seule série de paramètres de compensation, fixe, sert pour toute la vidéo, sans aucun calcul image par image.
Définir le problème
Les auteurs veulent savoir s'il est possible de n'utiliser que des indices de mouvement, sans craindre les mouvements de caméra, et sans compensation image par image.
Selon eux, le problème vient de l'IoU et du plan image.
L'IoU est la distance d'association la plus utilisée, mais dès que deux boîtes ne se recouvrent pas, elle vaut 0. Une caméra qui tremble, une fréquence d'échantillonnage faible, une cible rapide, et la boîte prédite se retrouve complètement séparée de la boîte de détection. Des variantes comme GIoU, DIoU ou C-BIoU donnent un score même à des boîtes disjointes, mais elles se calculent toujours dans le plan image.
Or la position dans le plan image mélange le mouvement de la caméra et la déformation de la perspective. Pour un même pas en avant, une personne proche de la caméra se déplace beaucoup à l'écran, une personne éloignée très peu. Les gens marchent en réalité sur le sol ; c'est sur le sol qu'un mouvement vraiment régulier devient visible.
SparseTrack, avec sa pseudo-profondeur estimée, et Quo Vadis, qui projette les positions en vue de dessus pour y calculer des distances, ont déjà fait un pas dans cette direction. Mais ils restent associés à l'IoU, et ni l'un ni l'autre ne traite l'incertitude introduite par la projection.
Résoudre le problème
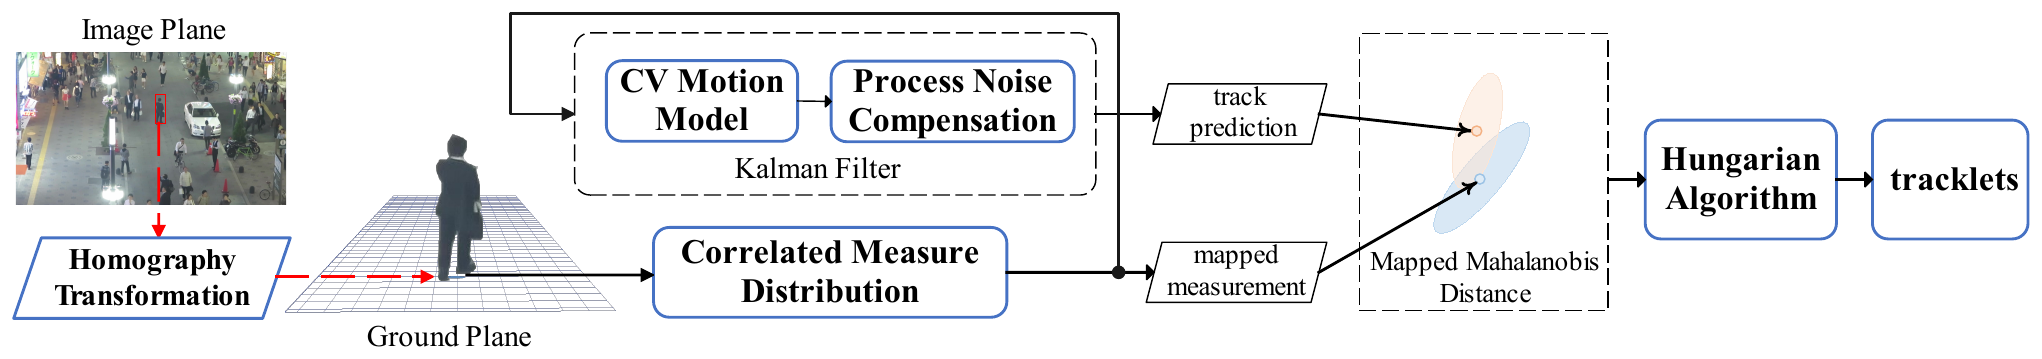
UCMCTrack reste une méthode qui détecte puis associe, avec des indices de mouvement uniquement. Il change l'endroit où vit le modèle de mouvement, la distance utilisée pour l'appariement et la façon de traiter les secousses de la caméra.
Un modèle de mouvement au sol
Pour la boîte de détection d'une personne, on prend le milieu du bord inférieur, qui correspond à peu près à l'endroit où ses pieds touchent le sol. Avec les paramètres intrinsèques et extrinsèques de la caméra, on projette ce point des coordonnées image vers les coordonnées au sol :
est la matrice de projection formée des paramètres intrinsèques et extrinsèques, un facteur d'échelle.
Le filtre de Kalman travaille directement au sol. L'état se réduit à la position et à la vitesse au sol, , avec le modèle le plus simple, à vitesse constante. Contrairement à la lignée SORT, qui suit le centre, la surface et le rapport largeur/hauteur de la boîte, la taille de la boîte n'intervient plus du tout.
Projeter le point, et projeter l'erreur avec
L'erreur du détecteur naît dans l'image. Les auteurs supposent que, dans l'image, elle est indépendante selon les deux directions et proportionnelle à la largeur et à la hauteur de la boîte :
est le coefficient de bruit de détection, et la largeur et la hauteur de la boîte de détection.
Une fois projetée au sol, cette erreur n'est plus indépendante selon les deux directions. Avec une approximation au premier ordre de la projection, la covariance de l'erreur au sol vaut
est formée d'éléments de l'inverse de la matrice de projection et de la position au sol. n'est pas diagonale, ce qui veut dire qu'au sol, l'erreur selon et selon est fortement corrélée. Les auteurs parlent de distribution de mesure corrélée (Correlated Measurement Distribution, CMD).
Intuitivement, c'est logique. Quand on filme en plongée oblique, quelques pixels d'écart vers le haut ou le bas à l'écran peuvent, une fois projetés au sol, représenter un long décalage d'avant en arrière le long de la ligne de visée. L'incertitude au sol est donc une ellipse inclinée, étirée le long de la ligne de visée, et non un cercle.
La distance de Mahalanobis à la place de l'IoU
Avec une prédiction au sol et une mesure assortie de son incertitude, la distance d'appariement devient une distance de Mahalanobis. Les auteurs l'appellent distance de Mahalanobis projetée (Mapped Mahalanobis Distance, MMD), et la calculent en trois étapes :
- Le résidu : , où est la mesure projetée au sol et l'état prédit par le filtre de Kalman.
- La covariance du résidu : , où est la covariance prédite.
- La distance de Mahalanobis normalisée :
Le premier terme est la distance de Mahalanobis habituelle ; un résidu orienté dans une direction très incertaine coûte peu, un résidu orienté dans une direction peu incertaine coûte cher. Le second terme, , fait entrer l'incertitude elle-même dans le calcul. Plus elle est grande, plus la distance de base est élevée ; une mesure très floue ne s'apparie donc pas facilement sous prétexte que « tout est possible ».
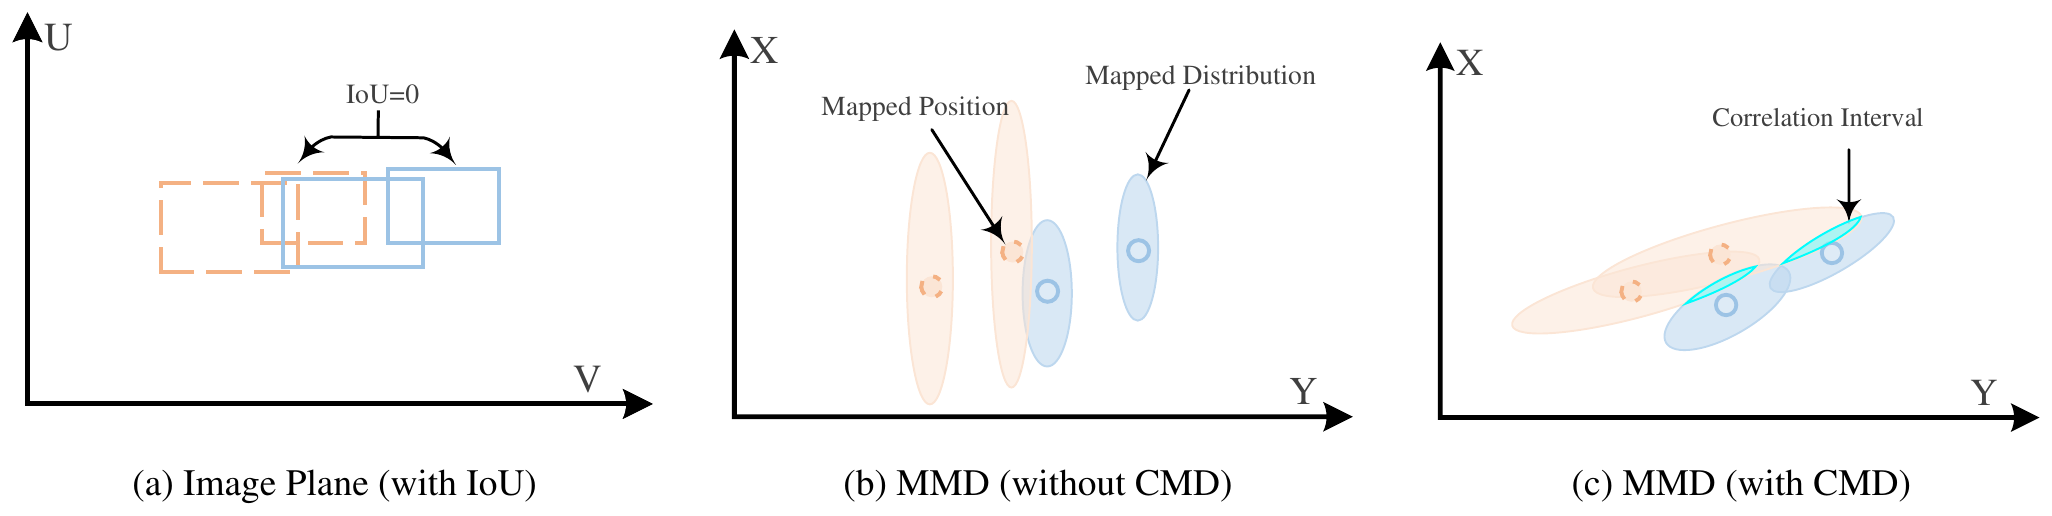
Cette figure met les trois cas côte à côte. En (a), les deux groupes de boîtes ne se recouvrent pas dans l'image, et l'IoU ne sert à rien. En (b), on calcule la distance au sol, mais si l'on traite l'erreur comme indépendante selon les deux directions, toutes les ellipses sont droites, et le candidat le plus proche se révèle être le mauvais. En (c), avec la distribution de mesure corrélée, les ellipses s'inclinent selon la vraie direction d'incertitude, et le bon appariement finit par apparaître.
Les secousses de la caméra, traitées comme du bruit
Reste le mouvement de la caméra. Au lieu d'estimer comment la caméra bouge à chaque image, les auteurs le voient comme une source de bruit qui produit une accélération. Sur un intervalle de temps , une accélération inconnue modifie respectivement la position et la vitesse de
Si l'on écrit cela sous forme d'une matrice , la covariance du bruit de processus du filtre de Kalman devient
et sont appelés facteurs de compensation du processus ; ils absorbent le bruit de mouvement causé respectivement par l'inclinaison et par la rotation de la caméra. Avec un bruit de processus plus grand, le filtre de Kalman fait davantage confiance aux nouvelles mesures et tolère des prédictions plus éloignées ; le déplacement provoqué par une secousse de la caméra ne suffit plus à briser la trajectoire.
Ces deux facteurs restent fixes pour toute une vidéo ; c'est ce que veut dire « uniforme » dans la compensation uniforme du mouvement de caméra (Uniform Camera Motion Compensation) du titre. Contrairement à une compensation image par image, elle ne demande aucun traitement d'image. D'après les auteurs, une fois les détections fournies, UCMCTrack traite plus de 1 000 images par seconde sur un seul CPU.
Le reste du processus est celui de SORT : l'algorithme hongrois fait l'appariement ; les trajectoires sans partenaire cumulent leur temps de disparition et sont supprimées au-delà d'un seuil ; les détections sans partenaire et de confiance suffisante ouvrent de nouvelles trajectoires. La méthode n'utilise nulle part l'IoU, ni aucune caractéristique d'apparence.
D'où viennent les paramètres de caméra
Pour projeter un point au sol, il faut les paramètres intrinsèques et extrinsèques de la caméra. KITTI les fournit, mais pas MOT17, MOT20 ni DanceTrack ; les auteurs les ont estimés à la main.
Le code officiel est livré avec un outil d'estimation, dans lequel l'utilisateur ajuste à la main trois angles de rotation, la focale et une translation, jusqu'à ce que la grille virtuelle du sol, tracée sur l'image, s'aligne avec le sol visible dans l'image. Le README précise que les paramètres ainsi obtenus ne sont pas forcément très précis, mais qu'ils suffisent à UCMCTrack.
Discussion
Pour la détection, toutes les expériences reprennent les poids YOLOX publiés par ByteTrack ; pour KITTI, ce sont les détections de PermaTrack. UCMCTrack+ est la variante qui ajoute un recalage d'image ECC, comme le fait StrongSORT.
Résultats principaux
| Méthode | MOT17 HOTA | MOT17 IDF1 | DanceTrack HOTA | DanceTrack AssA |
|---|---|---|---|---|
| ByteTrack | 63.1 | 77.3 | 47.3 | 31.4 |
| OC-SORT | 63.2 | 77.5 | 55.1 | 40.4 |
| C-BIoU | 64.1 | 79.7 | 60.6 | 45.4 |
| SparseTrack | 65.1 | 80.1 | 55.5 | 39.1 |
| BoT-SORT* | 65.0 | 80.2 | — | — |
| Deep OC-SORT* | 64.9 | 80.6 | 61.3 | 45.8 |
| UCMCTrack | 64.3 | 79.0 | 63.4 | 51.1 |
| UCMCTrack+ | 65.8 | 81.1 | 63.6 | 51.3 |
D'après les Tables 1 et 2 de l'article, ensembles de test ; les méthodes marquées * utilisent en plus des caractéristiques d'apparence.
- MOT17 : sans recalage d'image, UCMCTrack obtient 64.3, à peu près comme les autres méthodes fondées sur le seul mouvement ; avec, UCMCTrack+ atteint 65.8, au-dessus de BoT-SORT et Deep OC-SORT, qui utilisent pourtant l'apparence.
- DanceTrack : l'écart est plus net. UCMCTrack a un HOTA de 63.4, 2.8 de plus que C-BIoU, et l'AssA, qui mesure l'association, passe de 45.4 à 51.1. Un modèle de mouvement qui ne regarde que la position bat, sur des danseurs, Deep OC-SORT et ses caractéristiques d'apparence.
- MOT20 : UCMCTrack obtient 62.8, à égalité avec MotionTrack, un peu sous les 63.4 de SparseTrack, et sous Deep OC-SORT avec apparence (63.9). Ici, recalage d'image ou non, le résultat est le même, sans doute parce que les caméras de MOT20 sont de toute façon fixes.
- KITTI : un jeu de données de conduite à 10 FPS, où la caméra se déplace avec le véhicule. UCMCTrack obtient un HOTA de 77.1 sur la classe voiture, au-dessus des 76.5 d'OC-SORT ; mais UCMCTrack+, avec recalage d'image, retombe à 74.2. Les auteurs supposent que les paramètres du recalage étaient mal estimés.
L'apport de chaque pièce
Les ablations partent de ByteTrack et remplacent les éléments un par un, sur les ensembles de validation de MOT17 et de DanceTrack :
| Réglage | MOT17 HOTA | MOT17 IDF1 | DanceTrack HOTA | DanceTrack IDF1 |
|---|---|---|---|---|
| ByteTrack (IoU) | 68.4 | 77.1 | 47.9 | 47.3 |
| MMD à la place | 68.1 | 75.9 | 46.3 | 43.8 |
| + CMD | 70.4 | 79.7 | 55.1 | 53.9 |
| + comp. du bruit | 72.0 | 82.2 | 60.4 | 62.6 |
D'après la Table 4 de l'article, ensembles de validation.
- Remplacer seulement l'IoU par la distance de Mahalanobis dégrade les résultats. Selon les auteurs, l'IoU tient compte à la fois de la position et de la hauteur de la boîte, alors que la MMD ne regarde qu'un point au sol. Ils évoquent aussi la possibilité d'ajouter plus tard l'information de hauteur à la MMD.
- Avec la distribution de mesure corrélée, on dépasse l'IoU. Sur DanceTrack, on saute de 46.3 à 55.1, presque 9 points de plus. C'est quand la forme de l'erreur est correctement projetée que la distance au sol prend son sens.
- La compensation du bruit de processus ajoute encore un bon morceau. 1.6 point de plus sur MOT17, 5.3 sur DanceTrack, et même 8.7 en IDF1.
Sur le point 3, les auteurs reconnaissent eux-mêmes que la plupart des vidéos de DanceTrack n'ont pas de mouvement de point de vue notable ; la caméra y est presque fixe. Que compense alors la compensation du bruit de processus ? L'hypothèse de cette note, et non de l'article, est qu'en grossissant le bruit de processus, on rend le filtre de Kalman plus enclin à croire les nouvelles mesures et plus tolérant envers les erreurs de prédiction ; ce que cette compensation absorbe, ce sont alors sans doute surtout les écarts dus aux changements brusques de direction et de vitesse des danseurs eux-mêmes, plutôt que les secousses de la caméra. Vu sous cet angle, elle s'attaque au même problème qu'OC-SORT quand il corrige le filtre de Kalman, ou que C-BIoU quand il élargit les boîtes.
La compensation image par image, encore utile ?
| Réglage | MOT17 HOTA | DanceTrack HOTA |
|---|---|---|
| ByteTrack | 68.4 | 47.9 |
| ByteTrack + CMC par image | 71.0 | 47.6 |
| UCMCTrack | 72.0 | 60.4 |
| UCMCTrack + CMC par image | 73.0 | 59.2 |
D'après la Table 5 de l'article, ensembles de validation.
Sur MOT17, UCMCTrack seul fait mieux que « ByteTrack avec compensation image par image », et le cumul des deux ajoute encore 1 point. Mais sur DanceTrack, la compensation image par image fait reculer les deux méthodes. Selon les auteurs, la caméra de DanceTrack ne bouge presque pas, et le recalage d'image introduit de petits décalages entre des personnes qui se chevauchent, d'où des erreurs d'appariement.
Des facteurs de compensation à régler selon la scène
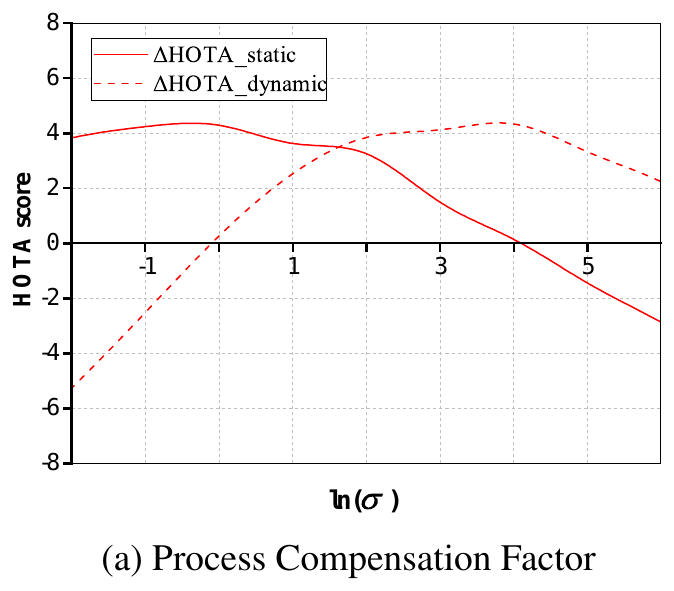
Les auteurs séparent l'ensemble de validation de MOT17 en vidéos à caméra fixe et vidéos à caméra mobile, et balaient différentes valeurs du facteur de compensation. Les deux courbes sont presque inversées. Pour les vidéos à caméra fixe, un petit facteur donne le meilleur résultat, et un facteur trop grand fait même pire que la référence ; pour les vidéos à caméra mobile, il faut monter jusqu'aux alentours de , et un facteur trop petit fait perdre 5 points par rapport à la référence.
« Uniforme » veut donc dire fixe au sein d'une même vidéo ; d'une vidéo à l'autre, il faut toujours régler les facteurs séparément. Quant au coefficient de bruit de détection , il donne le meilleur résultat à 0.05, et son influence reste faible entre 0.04 et 0.1.
Et si les paramètres de caméra sont faux ?
Les paramètres de caméra étant estimés à la main, des erreurs sont inévitables. Les auteurs injectent une erreur sur chacun des trois axes de rotation des paramètres extrinsèques. Une erreur de lacet, autour de l'axe vertical, a peu d'effet, car elle déforme peu le sol estimé ; sur les deux autres axes, une erreur importante déforme nettement le sol, et les performances baissent en conséquence. Il faut alors réajuster les paramètres pour que le sol estimé s'aligne sur le sol réel.
C'est aussi l'obstacle le plus concret à l'utilisation de la méthode. Dans les issues du dépôt officiel, plusieurs demandent comment estimer les paramètres de caméra, ou s'il est possible de les estimer de façon entièrement automatique.
Conclusion
UCMCTrack ramène le suivi multi-objets du plan image au sol. Le milieu du bord inférieur des boîtes de détection est projeté au sol, l'erreur est projetée avec lui sous forme d'ellipse inclinée, et la distance de Mahalanobis remplace l'IoU ; les secousses de la caméra deviennent du bruit de processus pour le filtre de Kalman, avec une seule série de paramètres par vidéo. Sans apparence et sans recalage image par image, il rattrape, voire dépasse, sur MOT17 et DanceTrack, les méthodes qui utilisent des caractéristiques d'apparence.
Le prix à payer, ce sont les paramètres de caméra, que la plupart des jeux de données publics ne fournissent pas et qu'il faut estimer à la main. Les auteurs reconnaissent aussi que la méthode suppose que tout le monde se tient sur un même plan ; dans des scènes avec des escaliers, des gradins ou des pentes, l'hypothèse ne tient plus.
Ce que voit un traqueur à l'écran, c'est un monde déjà projeté. Une fois ramenés au sol, bien des mouvements qui semblaient irréguliers se révèlent n'être que des illusions dues à la perspective et aux secousses de la caméra.