Article original
Performance Measures and a Data Set for Multi-Target, Multi-Camera Tracking
- Publication
- ECCV Workshops 2016Atelier (workshop)
- Premier dépôt sur arXiv
- arXiv:1609.01775
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingidf12016,
  title = {{Performance Measures and a Data Set for Multi-Target, Multi-Camera Tracking}},
  author = {Ergys Ristani and Francesco Solera and Roger S. Zou and Rita Cucchiara and Carlo Tomasi},
  year = {2016},
  eprint = {1609.01775},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1609.01775}
}
Dans le tableau principal d'un article de suivi, la colonne MOTA est presque toujours flanquée d'une colonne IDF1.
IDF1 vient d'un article sur le suivi multi-caméras. En 2016, Ergys Ristani et Carlo Tomasi, de l'Université Duke, avec Francesco Solera, Rita Cucchiara et d'autres, de l'Université de Modène, en Italie, y proposent trois choses d'un coup : un nouvel ensemble de métriques d'évaluation, DukeMTMC, le plus grand jeu de données multi-caméras de l'époque, et un système de suivi de référence.
La suite a été un peu inattendue. Le jeu de données a été retiré en 2019, et presque personne ne parle du système de référence ; ce sont au contraire les métriques de l'article qui sont devenues un standard du suivi mono-caméra.
Définir le problème
Le suivi multi-cibles et multi-caméras (Multi-Target, Multi-Camera tracking, MTMC) consiste à suivre chaque personne en continu à travers tout un réseau de caméras. Quand quelqu'un sort du champ d'une caméra, traverse un angle mort qu'aucune caméra ne couvre, puis réapparaît devant une autre caméra, le système doit reconnaître que c'est toujours la même personne.
Un suspect à l'aéroport
Les auteurs illustrent ce qu'ils veulent mesurer par une scène d'aéroport.
Dans le hall, la sécurité repère le suspect A ; elle a le choix entre deux systèmes de suivi. Tous deux étiquettent le suspect comme identité 1 et le suivent jusqu'au contrôle de sûreté.
- Le système X commet une erreur au contrôle de sûreté, puis étiquette le suspect comme identité 2 jusqu'au bout. Une seule erreur, mais la sécurité perd dès lors la trace du suspect.
- Le système Y, une fois le contrôle passé, alterne sans cesse entre les identités 1 et 2. Il change très souvent d'identifiant, mais entre le contrôle et la porte d'embarquement, il indique correctement la position du suspect pendant plusieurs intervalles, et le temps total où il a raison est aussi plus long.
La sécurité choisira le système Y, puisque c'est grâce à lui que le suspect est finalement arrêté à la porte d'embarquement. Mais selon le décompte de CLEAR MOT, le système X ne se trompe qu'une fois, et le système Y de nombreuses fois.
Selon les auteurs, le suivi multi-objets a traditionnellement été défini comme « suivre plusieurs cibles en continu » ; les métriques existantes rapportent donc « à quelle fréquence le traqueur commet quel type d'erreur ». Mais ce qui importe vraiment à certains utilisateurs, c'est de « savoir, à chaque instant, qui est où ».
Les auteurs ne prétendent pas qu'une métrique vaut mieux que l'autre. Une métrique fondée sur les événements, comme CLEAR MOT, indique d'où viennent les erreurs, ce qui convient à l'ingénieur qui conçoit un composant ; dans les applications où l'identité est cruciale, comme l'analyse sportive, la sécurité ou la surveillance, l'utilisateur a besoin d'une métrique fondée sur l'identité, quels que soient l'endroit et la cause de l'erreur.
Une personne, deux identités
Commençons par le problème au sein d'une seule caméra.
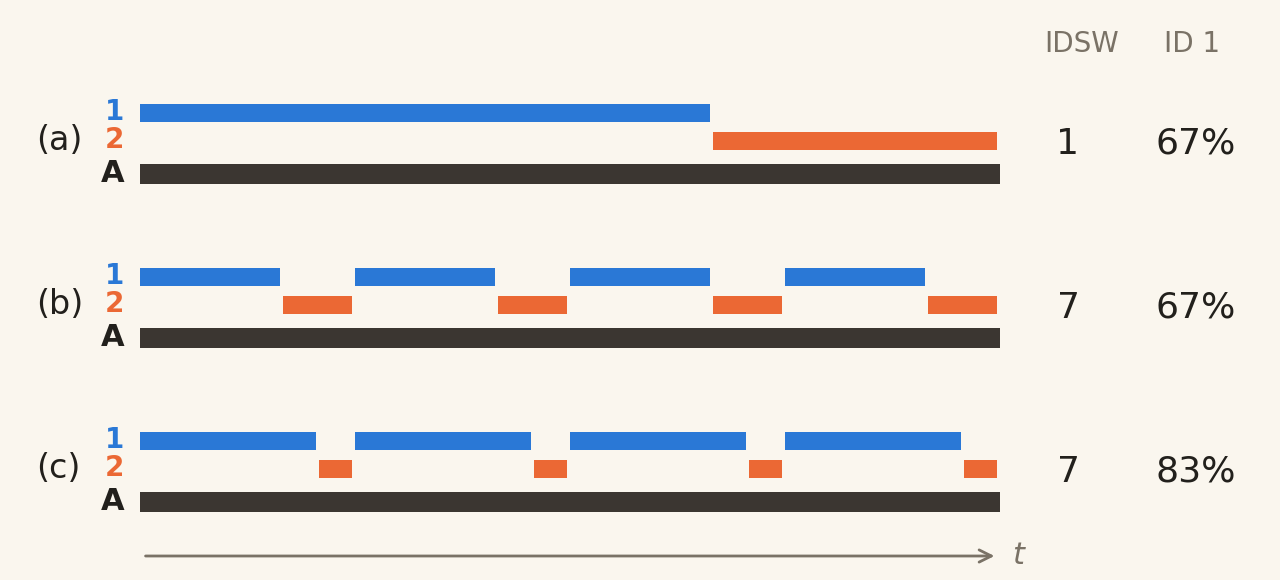
Dans les trois cas, le traqueur a scindé une seule personne réelle, A, en identité 1 et identité 2.
Pour une métrique qui compte les événements, (a) ne change d'identifiant qu'une fois, (b) et (c) chacun 7 fois. (a) est donc bien meilleur que les deux autres, et (b) et (c) sont aussi mauvais l'un que l'autre.
Pour les auteurs, le traqueur ne commet en réalité qu'un seul type d'erreur, celui de voir deux personnes là où il n'y en a qu'une. Pour mesurer la gravité de cette erreur, l'évaluation doit d'abord décider si A correspond à l'identité 1 ou à l'identité 2. Une fois ce choix fait, chaque image où A porte l'autre identité est une image où le traqueur se trompe.
Ce choix revient à l'évaluateur, pas au traqueur ; il doit donc être aussi favorable que possible au traqueur. Dans les trois cas, associer A à l'identité 1 est le plus favorable, puisque l'identité 1 explique la plus grande partie de A. Il suffit ensuite de compter la part des images de A qui ne portent pas l'identité 1 : 33 % pour (a) comme pour (b), 17 % pour (c).
Avec ce calcul, (a) et (b) se valent, et (c) est le meilleur ; le classement est exactement l'inverse de celui du décompte d'événements. Dans (c), le traqueur sait où est A 83 % du temps ; dans (a) et (b), seulement 67 %.
En inversant traits épais et traits fins sur la figure, le même raisonnement s'applique à l'autre type d'erreur, quand le traqueur fond deux personnes réelles en une seule identité. On choisit alors, pour cette identité calculée, la trajectoire réelle qu'elle couvre le plus.
Au moment de changer de caméra
Le multi-caméras pose en plus le problème du passage de relais (handover).
Les métriques existantes comptent à part les « erreurs de relais » ; quand une personne passe de la caméra I à la caméra II et que le système lui donne des identités différentes de part et d'autre, on en compte une. Pour savoir s'il s'agit d'une erreur de relais ou d'une erreur interne à la caméra, on regarde seulement l'identité reçue par la trajectoire à sa dernière image dans la caméra I et à sa première image dans la caméra II.
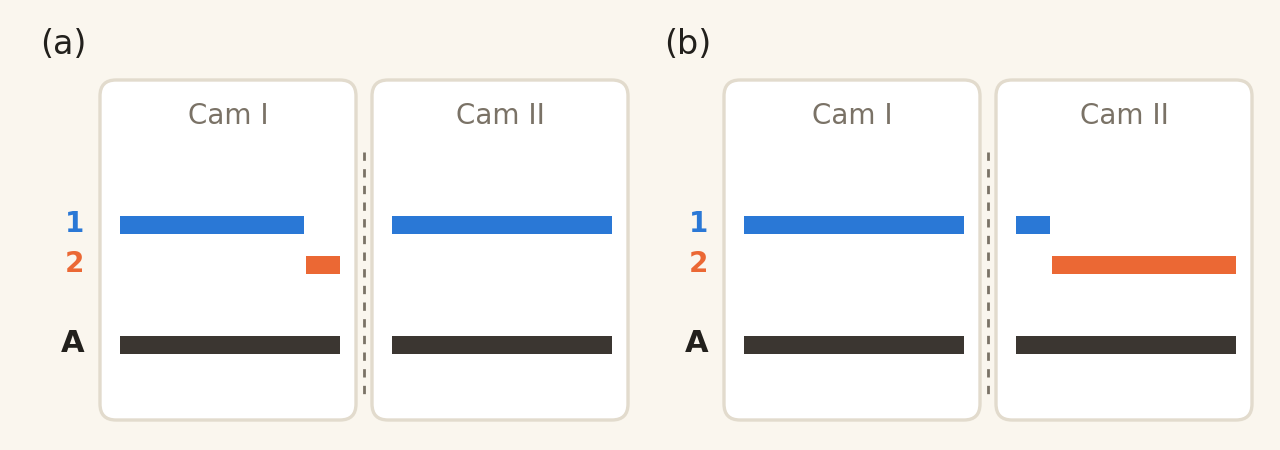
À ne regarder que les deux images qui encadrent le relais, la conclusion devient très fragile :
- (a) Le relais est en réalité correct ; A est reconnu comme identité 1 dans les deux caméras. Mais parce qu'un court segment à la fin de la caméra I est étiqueté à tort identité 2, les métriques existantes comptent à la fois une fragmentation interne à la caméra et une fragmentation au relais.
- (b) Le relais est en réalité raté ; une fois dans la caméra II, A est presque toujours étiqueté identité 2. Mais comme un court segment au début de la caméra II porte encore l'identité 1, les métriques existantes jugent le relais réussi et ne comptent qu'une fragmentation interne à la caméra.
Avec le nouveau calcul des auteurs, (a) n'est pénalisé que pour le court segment mal étiqueté, et (b) pour presque toute la trajectoire dans la caméra II.
MCTA, la métrique globale couramment utilisée à l'époque en suivi multi-caméras, multiplie trois termes : le score F1 de la détection, les erreurs internes aux caméras et les erreurs de relais. Le problème s'en trouve aggravé. Dès qu'une situation comme celles ci-dessus fait passer une erreur du terme interne au terme de relais, son effet sur le score change radicalement, puisqu'elle est multipliée par la valeur des deux autres termes. Les auteurs le disent sans détour, les raisons d'une combinaison multiplicative ne sont pas claires.
Par ailleurs, MOTA lui-même convient mal au multi-caméras. Pour une trajectoire qui traverse caméras sur images au total, les liens entre images consécutives qui passent d'une caméra à une autre ne sont qu'environ , contre liens internes aux caméras, et est bien plus petit que . Une confusion de personnes d'une caméra à l'autre est presque invisible dans MOTA.
Résoudre le problème
Les auteurs cessent de compter combien de fois une erreur se produit, et mesurent pendant combien de temps le traqueur reconnaît la bonne personne.
Trajectoires entières, appariement un à un
Première étape, apparier les identités réelles et les identités calculées.
L'unité d'appariement est ici la trajectoire entière, et l'appariement est un à un ; une trajectoire réelle ne peut être appariée qu'à une seule trajectoire calculée, et inversement. Le critère de choix est de minimiser le nombre total d'images mal attribuées sur l'ensemble des données.
Les auteurs le formulent comme un problème d'appariement dans un graphe biparti. À gauche, chaque trajectoire réelle ; à droite, chaque trajectoire calculée . En plus, chaque trajectoire calculée a, à gauche, une doublure « faux positif » , et chaque trajectoire réelle a, à droite, une doublure « détection manquée » . Ces doublures permettent à une trajectoire de n'être appariée à personne, au prix de voir toutes ses images comptées comme erreurs.
Quand deux trajectoires « ne concordent pas » à une image donnée, on note . Dans l'image, elles ne concordent pas si l'IoU de leurs deux boîtes est inférieur à ; en coordonnées au sol, si les deux positions sont distantes de plus de 1 mètre. Quand une trajectoire est appariée à une doublure, aucune de ses images ne concorde.
Le coût d'une paire est le nombre d'images en détection manquée qu'elle entraîne, plus le nombre d'images en faux positif :
et sont les images où apparaissent respectivement les deux trajectoires.
Une fois résolu l'appariement un à un de coût minimal, le résultat de chaque image se range dans l'une de trois catégories :
- IDTP : la trajectoire réelle et la trajectoire calculée appariées concordent bel et bien à cette image.
- IDFN : une image d'une trajectoire réelle où la trajectoire calculée qui lui est appariée ne concorde pas (y compris quand elle n'est appariée à aucune trajectoire).
- IDFP : une image d'une trajectoire calculée qui ne concorde pas avec la trajectoire réelle qui lui est appariée (y compris quand elle n'est appariée à rien).
Trois scores
Avec ces trois décomptes, on peut appliquer la précision et le rappel habituels :
IDP est la part des boîtes calculées dont l'identité est correcte ; IDR, la part des boîtes réelles dont l'identité est bien reconnue. IDF1 est leur moyenne harmonique, qu'on peut aussi lire comme « le nombre de boîtes à l'identité correcte, divisé par la moyenne du nombre de boîtes réelles et du nombre de boîtes calculées ».
Faisons le calcul
Déroulons un petit exemple. Deux personnes, et , apparaissent sur 10 images ; le traqueur produit deux trajectoires, et , avec une détection très précise à chaque image, si ce n'est que les deux trajectoires s'échangent une fois en cours de route.
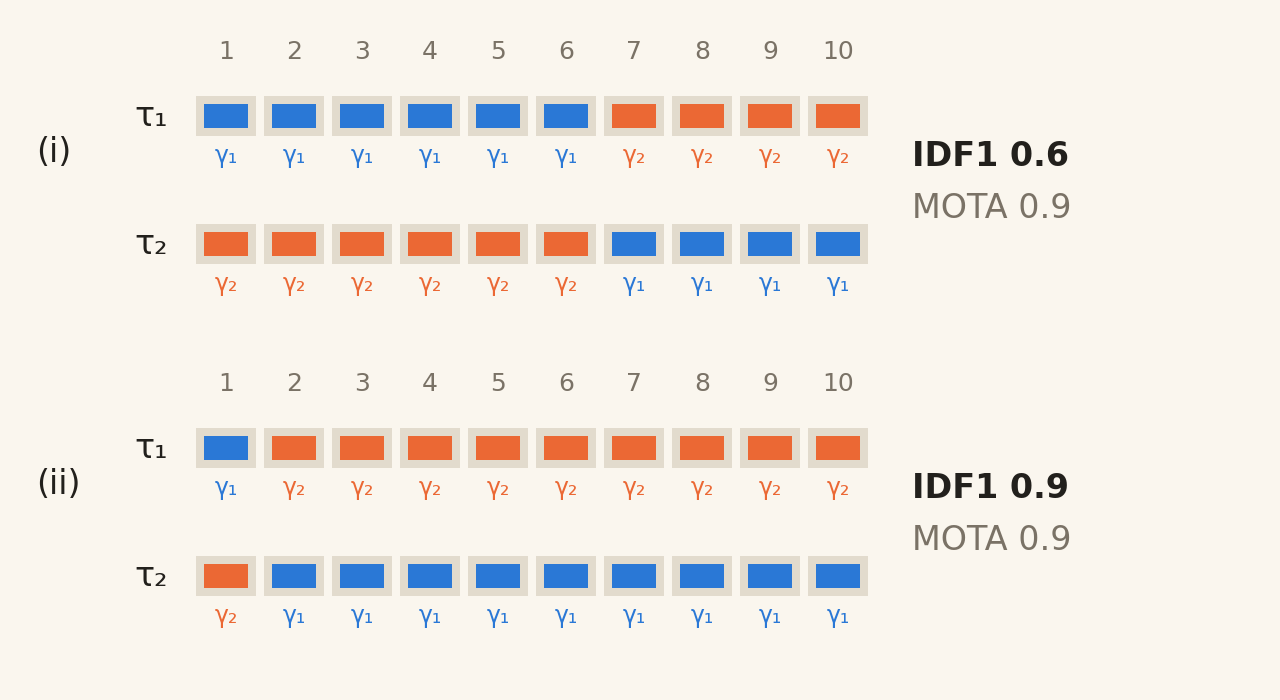
Prenons d'abord la moitié haute, la situation (i), avec un échange à l'image 7. Apparions à : des images 7 à 10, ne concorde pas avec , soit 4 images de détection manquée ; sur ces mêmes images, part suivre , soit 4 images de faux positif ; coût 8. Apparier plutôt donne 6 images d'erreur de chaque côté, coût 12. Apparier à une doublure coûte encore plus cher ; les 10 images de la trajectoire comptent toutes comme erreurs. Voici la table des coûts complète :
| 8 | 12 | 10 | — | |
| 12 | 8 | — | 10 | |
| 10 | — | 0 | 0 | |
| — | 10 | 0 | 0 |
Tableau établi pour cette note. « — » indique qu'il n'y a pas d'arête entre les deux nœuds ; apparier deux doublures entre elles coûte 0.
L'appariement de coût minimal est , , pour un coût total de 16. On a donc IDFN = 8 et IDFP = 8 ; les deux personnes totalisent 20 images, d'où IDTP = 20 − 8 = 12 :
Avec CLEAR MOT, le même exemple ne compte ni détection manquée ni faux positif ; à l'image 7, chacune des deux personnes change une fois d'hypothèse, soit 2 erreurs d'appariement, et MOTA .
Passons à la moitié basse, la situation (ii), où l'échange est avancé à l'image 2. MOTA vaut toujours 0.9, avec toujours deux erreurs d'appariement. Côté IDF1, le meilleur appariement devient , ; chaque personne concorde sur 9 images, IDTP = 18, et IDF1 = 0.9. Si l'échange tombe pile à l'image 6, avec 5 images avant et 5 après, IDF1 descend à son minimum, 0.5.
Les auteurs de CLEAR MOT ont délibérément conçu leur métrique pour que le moment, précoce ou tardif, d'un même échange n'influe pas sur la pénalité, et ont qualifié l'approche inverse de contre-intuitive. IDF1 fait exactement le contraire ; le moment de l'échange détermine pendant combien de temps le traqueur se trompe d'identité, et c'est précisément ce qu'il veut mesurer.
La divergence entre les deux métriques est délibérée dès le départ.
Les différences avec CLEAR MOT
Les auteurs comparent les deux côte à côte :
- La portée de l'appariement. CLEAR MOT apparie image par image, et reprend l'appariement de l'image précédente tant qu'il reste sous le seuil. Chaque image est appariée un à un, mais sur toute la vidéo, une personne réelle peut avoir été appariée successivement à plusieurs trajectoires ; c'est du plusieurs-à-plusieurs. IDF1 n'apparie qu'une fois, sur toute la vidéo, et reste un à un d'un bout à l'autre.
- Pas de notion de « fragmentation ». Puisqu'on n'apparie qu'une fois pour toute la séquence, il n'y a pas d'événement « changement d'identifiant » à compter ; on vérifie seulement si chaque image est expliquée par la bonne identité.
- L'unité d'erreur. IDF1 ne compte que des images, sans y mêler de distance. Selon les auteurs, mélanger décompte binaire et distance euclidienne empêcherait de distinguer un traqueur qui « reconnaît longtemps les identités » d'un traqueur qui « colle de près aux positions ».
Les auteurs résument les trois propriétés de cet appariement : un à un, le plus favorable au traqueur, et une seule monnaie pour toutes les erreurs. Les champs de caméra qui se recouvrent et ceux qui ne se recouvrent pas sont, eux aussi, traités exactement de la même façon.
Pour qui veut vraiment savoir à quel point le passage d'une caméra à l'autre est difficile, les auteurs proposent de faire l'appariement deux fois, une fois avec les données de toutes les caméras réunies, une fois caméra par caméra en additionnant ensuite les erreurs. Le premier calcul compte toujours au moins autant d'erreurs que le second, et l'écart entre les deux correspond aux erreurs supplémentaires de l'association entre caméras.
DukeMTMC
La deuxième contribution de l'article est le jeu de données.
Huit caméras fixes synchronisées, installées sur le campus de l'Université Duke, filment aux heures d'affluence entre deux cours ; 1 heure 25 minutes par caméra, en 1080p à 60 images par seconde, soit plus de 10 heures et 2 millions d'images au total. On y voit 2 834 personnes différentes et 6 791 trajectoires mono-caméra ; chaque personne a en moyenne 2.5 trajectoires mono-caméra, et jusqu'à 7.
Quelques chiffres pour mesurer sa difficulté :
- De 0 à 54 personnes par image dans une même caméra, selon la caméra.
- 4 159 passages de relais au total, avec jusqu'à 50 personnes en même temps dans les angles morts.
- Plus de 1 800 occultations (recouvrement d'au moins 50 %), d'une durée moyenne de 60 images.
- 891 personnes n'apparaissent que devant une seule caméra, un vrai test pour les traqueurs enclins à apparier à tort des personnes vues par des caméras différentes.
- La plupart des champs de caméra ne se recouvrent pas ; seules deux paires de caméras partagent une petite zone commune, où passent environ 100 personnes.
L'annotation est la trajectoire du point de contact entre les pieds de chaque personne et le sol. Cinq personnes ont passé un an à annoter près de 100 000 points clés dans une interface maison, ensuite interpolés à chaque image ; les boîtes dans l'image sont générées de façon semi-automatique. Les 5 premières minutes de chaque caméra servent à l'entraînement et à la validation, les 80 minutes restantes au test.
Dans leur tableau comparatif, les auteurs recensent une bonne dizaine de jeux de données multi-caméras connus à l'époque ; le plus riche n'avait que 255 identités. Les 2 834 identités de DukeMTMC dépassent le total de tous les jeux précédents réunis, avec la plus longue durée d'enregistrement et la fréquence d'images la plus élevée.
Tant de données, c'est aussi beaucoup de calcul. Les auteurs indiquent que calculer tous les masques de premier plan avec un algorithme standard prend 6 jours sur une seule machine, et qu'obtenir toutes les détections avec le détecteur DPM prend 7 jours sur une grappe de 192 cœurs.
Les auteurs en listent aussi les limites : une seule scène extérieure, des caméras fixes, la lumière douce d'un temps couvert qui facilite peut-être le suivi, et des champs pour la plupart sans recouvrement, ce qui désavantage les méthodes qui comptent sur des champs qui se recouvrent.
Le jeu de données a ensuite été très utilisé, et a donné naissance à DukeMTMC-reID, pour la ré-identification de piétons. En 2019, l'Université Duke a retiré le site du jeu de données. Selon un article du journal étudiant de Duke, l'université a déclaré que la publication du jeu de données s'écartait nettement du protocole de recherche approuvé, et qu'elle n'envisageait pas de le rouvrir.
Le système de référence
La troisième contribution est un traqueur multi-caméras de référence, dérivé du système mono-caméra antérieur de Ristani et Tomasi.
Il fusionne les observations par niveaux. Les détections sont d'abord regroupées en courts fragments de trajectoire, assez courts pour qu'un modèle de mouvement simple suffise ; les fragments forment ensuite des trajectoires mono-caméra ; enfin, les trajectoires des différentes caméras sont reliées en identités inter-caméras. Chaque niveau est un graphe dont les nœuds sont des observations ; le poids d'une arête, compris entre −1 et 1, exprime la force des indices selon lesquels deux observations désignent la même personne. Regrouper les nœuds de façon à maximiser la somme des poids au sein des groupes est un problème de partitionnement par corrélation (correlation clustering), résolu par programmation en nombres entiers binaires.
Ce problème est NP-difficile, et difficile aussi à approcher ; d'où le découpage en plusieurs niveaux, pour que chaque sous-problème reste assez petit. Dans le temps, une fenêtre glissante permet de traiter des vidéos sans fin.
Sur les quatre jeux de données NLPR MCT existants, où l'usage est de fournir les vraies trajectoires mono-caméra et de ne comparer que l'association entre caméras, avec MCTA comme score, ce système se classe en moyenne deuxième sur six méthodes.
Discussion
Deux métriques, deux choses différentes
Les auteurs font tourner le système de référence sur DukeMTMC, et vérifient si le rappel d'identité et la précision d'identité de chaque trajectoire réelle sont liés au nombre de fragmentations et de fusions comptées pour elle. Les quatre coefficients de corrélation valent −0.24, −0.05, −0.38 et −0.41 ; toutes ces corrélations sont faibles.
Autrement dit, le nombre de fragmentations ou de fusions comptées pour une trajectoire permet mal de deviner pendant combien de temps son identité est bien reconnue. Métriques à base d'événements et métriques à base d'identités mesurent bel et bien des choses différentes.
Les problèmes de relais ne sont pas que théoriques
Les deux contre-exemples de relais vus plus haut sont-ils fréquents dans des résultats réels ? Sur le jeu de données, le système de référence effectue 5 549 passages de relais au total ; pour environ 74 % d'entre eux (4 119), une courte trajectoire à proximité du relais fait nettement diverger le jugement des métriques traditionnelles et celui des nouvelles métriques :
| Situation | Nombre | Part |
|---|---|---|
| Relais correct, compté en fragmentation | 1 692 + 738 | 30.5 % + 13.3 % |
| Relais correct, compté en fusion | 1 065 + 496 | 19.2 % + 8.9 % |
| Relais raté, non compté en fragmentation | 70 | 1.3 % |
| Relais raté, non compté en fusion | 58 | 1.0 % |
D'après la Figure 5 de l'article ; les parts sont des pourcentages de l'ensemble des 5 549 relais, et chacune des deux premières lignes regroupe deux cas illustrés.
L'essentiel de l'écart vient de relais pourtant réussis, que les métriques traditionnelles pénalisent quand même.
Un même système, deux classements
Enfin, les auteurs donnent comme point de comparaison les scores du système de référence sur l'ensemble de test de DukeMTMC :
| Caméra | MOTA | IDP | IDR | IDF1 |
|---|---|---|---|---|
| 1 | 37.36 | 79.17 | 44.97 | 57.36 |
| 2 | 49.17 | 69.11 | 63.78 | 66.34 |
| 3 | 53.50 | 81.46 | 55.11 | 65.74 |
| 4 | 55.92 | 79.23 | 61.16 | 69.03 |
| 5 | 73.09 | 84.86 | 67.97 | 75.48 |
| 6 | 12.94 | 48.35 | 43.71 | 45.91 |
| 7 | 62.03 | 85.23 | 67.08 | 75.07 |
| 8 | 36.98 | 90.54 | 35.86 | 51.37 |
D'après la moitié inférieure de la Table 3 de l'article, résultats par caméra ; d'autres colonnes, dont FP, FN, changements d'identité, MT et ML, ne sont pas reprises.
Les deux métriques ne jugent pas la difficulté des caméras de la même façon. Selon MOTA, la caméra 3 est plus facile que la caméra 2 ; selon IDF1, c'est au contraire la caméra 2 qui s'en sort un peu mieux. L'écart entre les caméras 6 et 7 est plus parlant encore : près de 50 points en MOTA (12.94 contre 62.03), seulement 29 en IDF1 (45.91 contre 75.07). Les auteurs disent qu'à regarder les résultats de suivi eux-mêmes, la caméra 6 n'est pas aussi mauvaise que le dit MOTA.
Notez aussi la caméra 8, où IDP atteint 90.54 et IDR seulement 35.86. Les identités attribuées sont pour la plupart justes, mais beaucoup de personnes ne sont tout simplement pas reconnues. Ce genre de compromis ne se voit pas avec le seul chiffre d'IDF1 ; c'est aussi pourquoi les auteurs fournissent en même temps la précision et le rappel.
Toutes caméras confondues, IDP, IDR et IDF1 valent respectivement 52.35, 36.46 et 42.98. Le tableau comporte aussi une ligne inter-caméras marquée comme borne supérieure, avec un IDF1 de 59.77.
Conclusion
Avec un exemple d'aéroport, cet article sépare deux questions, « à quelle fréquence on se trompe » et « pendant combien de temps on reconnaît la bonne personne ». IDF1 apparie un à un, sur toute la vidéo, identités réelles et identités calculées, de la façon la plus favorable possible au traqueur, puis compte les images où l'identité est bien reconnue. Toutes les erreurs se paient en images, qu'elles surviennent dans une caméra ou lors d'un relais.
Sa divergence avec CLEAR MOT est délibérée. Pour CLEAR MOT, un échange est une erreur, et le moment où il survient ne doit rien y changer ; pour IDF1, un échange précoce veut dire que le traqueur a désigné la mauvaise personne plus longtemps. Chacune des deux visions répond à une question légitime, et les auteurs n'ont aucune intention de remplacer qui que ce soit.
MOTChallenge a ensuite ajouté IDF1 à ses classements, à côté de MOTA. Quatre ans plus tard, HOTA a montré qu'IDF1 était tombé dans l'excès inverse ; il ne se soucie presque que de l'association, et la qualité de la détection se reflète peu dans le score.
Retour à l'aéroport. Ce que veut la sécurité, ce n'a jamais été « combien d'erreurs », mais un système capable, devant la porte d'embarquement, de pointer l'écran du doigt et de dire : « Le suspect est là. »