社群網站猜你可能認識誰,購物網站猜你可能喜歡什麼,背後常有同一個直覺。物以類聚,朋友喜歡的東西,你多半也喜歡。
圖卷積網路(Graph Convolutional Network,GCN)就是把這個直覺寫成數學。
這篇從零開始,不需要圖論背景,會加減乘除就夠了,矩陣乘法用到時再解釋。讀完之後,你會親手算完一層 GCN,也會看著一個小模型只靠兩個已知答案,猜出其他人的答案。文中有三個可以動手玩的互動圖,點一點、拉一拉,會比只讀公式快很多。
先看一個問題
有六個人。Alice、Bob、Carol 彼此是朋友,Dave、Eve、Frank 也是;Carol 和 Dave 也認識,是兩群人之間唯一的連結。
我們只知道兩件事。Alice 喜歡打球,Frank 不喜歡。
其他四個人呢?
你大概會這樣猜。Bob 的朋友是 Alice 和 Carol,Alice 喜歡打球,所以 Bob 可能也喜歡;Eve 的朋友是 Dave 和 Frank,Frank 不喜歡,Eve 大概也不太喜歡。
「看朋友來猜」,就是圖卷積的出發點。接下來一步一步,把這個猜法變成電腦算得出來的東西。
圖:點和線
先釐清一個名詞。這裡的「圖」是英文的 graph,不是圖片。它只有兩種東西:
- 節點(node):要描述的對象,這裡是六個人。
- 邊(edge):對象之間的關係,這裡是朋友關係。
每個節點還可以帶一些數字來描述自己,叫做特徵(feature)。這裡每個人只有一個特徵,就是「喜歡打球的程度」。Alice 是 1,Frank 是 0;其他四個人不知道,先都填 0.5,表示一半一半。
電腦看不到線,要把朋友關係寫成一張表,叫做鄰接矩陣(adjacency matrix)。
六個人就是 6×6 的表,寫成 。第 列、第 欄的 ,表示第 個人和第 個人是朋友;不是朋友就填 0。
看 Carol 那一列,Alice、Bob、Dave 三格是 1,她有三個朋友。一列裡有幾個 1,就是這個人的朋友數,叫做度數(degree)。
朋友是互相的,所以 ,整張表沿著對角線左右對稱。
最直覺的做法:問問朋友
最簡單的猜法,是把每個人的數字換成朋友們的平均。
Bob 的朋友是 Alice(1)和 Carol(0.5),平均是 0.75,他大概喜歡打球。Eve 的朋友是 Dave(0.5)和 Frank(0),平均是 0.25,她大概不喜歡。
用矩陣可以一次替所有人算。先把鄰接矩陣的每一列除以那個人的朋友數,每個朋友就各占一份;再乘上每個人喜歡打球的程度(Alice 是 1、Frank 是 0,其他人不知道,先填 0.5)。結果的第 個數字,是把第 列的每一份和對應的數字相乘再加起來,也就是第 個人所有朋友的平均,六個人依序是 0.5、0.75、0.67、0.33、0.25、0.5。
Bob 是 0.75,Eve 是 0.25,和我們的直覺一樣。可是看看 Alice 和 Frank。
他們兩個原本是唯一知道答案的人,算完卻都變成 0.5。只問朋友,就把自己知道的事丟掉了。
兩個修補
自己也算一票
修法很直接,算平均的時候把自己也算進去。在鄰接矩陣的對角線上補 1,等於讓每個人多一個「自己」當朋友,這叫自環(self-loop),寫成 。 是對角線為 1、其他為 0 的單位矩陣。
這樣 Alice 的新數字是 ,她自己的答案保住了大半。
朋友多的人,每一票輕一點
直接取平均時,每個朋友的份量都一樣。GCN 多做了一步,依兩個人各自的朋友數調整份量。第 個人從第 個人拿到的份量是:
是加上自環後的度數,也就是朋友數再加 1。
拿 Bob 來看。Bob 的 是 3。他從 Alice()拿 ,從 Carol()拿 。Carol 認識的人比較多,她的聲音分給更多人,傳到 Bob 這裡就輕一點。
這個份量也是對稱的,Bob 從 Carol 拿多少,Carol 就從 Bob 拿多少。寫成矩陣,就是 GCN 論文裡的 ,左右各除一次度數的平方根。加上自環之後,六個人的度數依序是 3、3、4、4、3、3;用 重新算一次,新的數字是 0.64、0.64、0.68、0.39、0.31、0.31。
左邊三個人都超過 0.5,右邊三個人都低於 0.5,Alice 也還是傾向喜歡打球。份量加起來不一定剛好是 1,Carol 那一列就是 1.08,但很接近。
為什麼不直接取平均就好?兩種做法都有人用。GCN 選這個對稱的版本,一個原因是它從頻域的推導一路簡化而來,另一個是疊很多層時數值比較穩,不會越乘越大。
下面這個互動圖可以點任何一個人,看他從誰那裡拿了多少。三種算法切換看看,特別注意 Alice 在「只問朋友」時發生了什麼事。
Bob 的新數字GCN 的權重
- Alice1.00 × 0.330.33
- 自己0.50 × 0.330.17
- Carol0.50 × 0.290.14
加起來0.64
這就是一層 GCN
把剛才做的事寫成一行,就是 GCN 論文裡的公式:
三個部分各做一件事:
- :每個人和朋友、自己,照剛才的份量取加權平均。 是所有人的特徵,一個人一列;第一層的 就是原始特徵,寫成 。
- 乘上 :每個人的特徵常常不只一個。 把這些特徵重新組合,換一組說法,每個新特徵都是舊特徵的加權和。 是模型要學的參數,所有人共用同一個 。
- :一個非線性函數,GCN 用的是 ReLU,負的變成 0,正的保持原樣。
讓每個人多一個特徵「喜歡看書的程度」,Alice 是 0、Frank 是 1,其他人還是 0.5。 先由我們指定,讓第一個新特徵是「打球減看書」,第二個是「看書減打球」。經過一層 GCN,Alice、Bob、Carol 的新特徵是 [0.33, 0]、[0.33, 0]、[0.29, 0],Dave、Eve、Frank 是 [0, 0.29]、[0, 0.33]、[0, 0.33]。
左邊三個人的第一個新特徵是正的,右邊三個人的第二個新特徵是正的。一層 GCN 之後,兩群人已經用不同的特徵分開了。
實際訓練時, 不是我們指定的,而是從資料學出來的。這一點等一下再看。
為什麼叫「卷積」
如果你學過處理影像的卷積神經網路(CNN),應該會覺得剛才的做法有點眼熟。
影像的卷積,是讓每個像素的新值等於自己和周圍 8 個像素的加權和,再讓同一組權重滑過整張影像。圖卷積也是讓每個節點的新值等於自己和鄰居的加權和,所有節點共用同一個 。兩者做的是同一類事,所以叫圖「卷積」。
差別在鄰居。像素的鄰居固定是 8 個,左上、正上、右上各有固定的位置,每個位置有自己的權重;圖上的鄰居數量不固定,也沒有上下左右,GCN 只好讓份量只由度數決定。這個差別埋下了不少後來的研究,〈圖卷積大觀園〉的第一站就從這裡開始。
疊兩層,看得更遠
一層 GCN 只讓每個人聽到朋友的聲音。把第一層的結果再送進第二層,朋友的朋友也聽得到了。
以 Alice 為例,她的資訊一層之後傳到 Bob 和 Carol,兩層之後越過橋傳到 Dave,三層之後才到 Eve 和 Frank。疊 層,就看得到 步以內的人。
拖動下面的滑桿試試看。
一開始,只有 Alice 和 Frank 有答案。
Alice 的資訊傳到的人數0 / 5
虛線圈起來的,就是已經傳到的人。
一開始最高和最低差了 1.00;疊一層,兩群人已經分開,差距是 0.37;疊到 8 層只剩 0.18。疊越多層,大家的數字越來越接近,最後兩群人會分不出來,這叫 over-smoothing。GCN 論文的主要實驗只用兩層;附錄試過更深的版本,最好的結果都落在兩到三層。
讓模型自己學
到目前為止,數字和 都是我們給的。真正的 GCN 要自己學。
我們把題目弄得更純粹一點。模型完全不知道誰喜不喜歡打球,每個人的特徵只有「我是誰」;唯一的線索是朋友關係,以及兩個答案,Alice 喜歡打球、Frank 不喜歡。
模型先用 在圖上平滑兩次,再接一個線性分類器,用 softmax 把兩個類別的分數換成加起來是 1 的機率,輸出每個人喜歡打球的機率。訓練時只拿 Alice 和 Frank 的答案來算誤差,用梯度下降一步一步調整分類器的權重。用圖的時候,Bob、Carol 被猜成喜歡打球(0.98、0.92),Dave、Eve 被猜成不喜歡(0.08、0.02),四個人都對。不用圖的時候,模型對這四個人一無所知,只能停在 0.5。
答案只有兩個,其他的都是從朋友關係推出來的。這就是 GCN 最常見的用法,半監督節點分類。GCN 論文在 Cora 論文引用網路上做的就是這件事,2,708 篇論文裡只給 140 篇的類別,兩層 GCN 猜對其他論文類別的準確率是 81.5%。
下面可以一步一步看訓練的過程,也可以切換「不用圖」比較。
沒給答案的 4 個人,猜對 0 個。
和 Transformer 差在哪
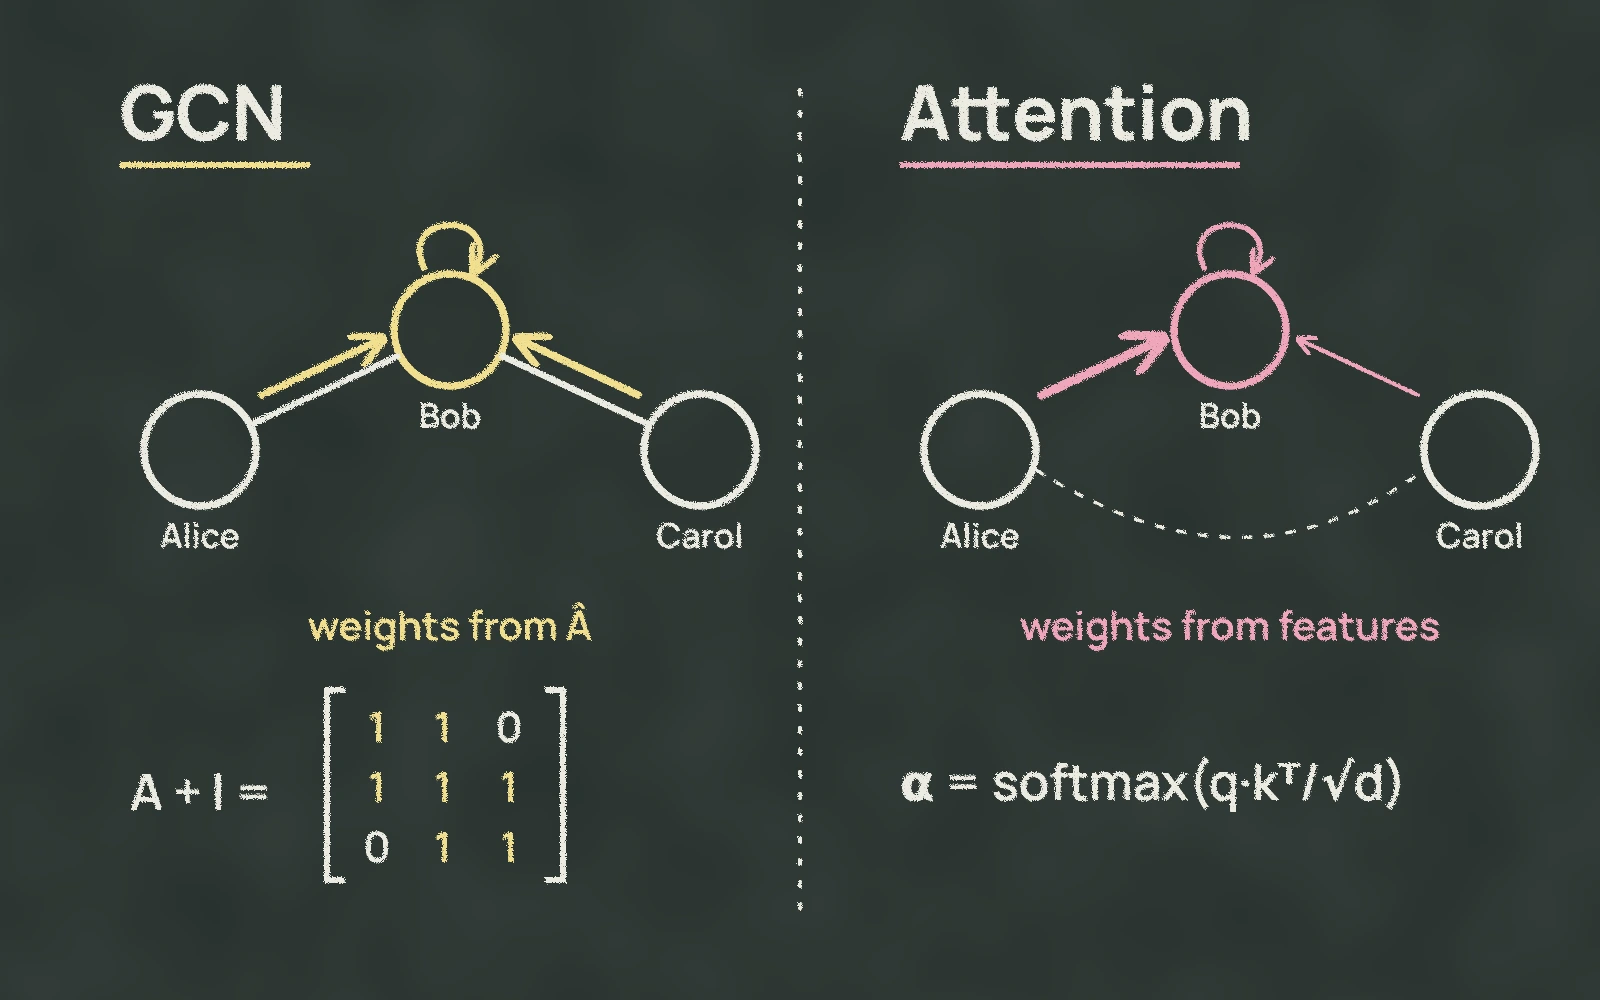
如果你熟悉 Transformer,可能覺得「每個人取別人的加權平均」很像注意力機制。確實很像,差別在兩件事。
第一,誰拿得到份量。GCN 只在朋友之間分配,圖上沒有連線的兩個人,份量是 0;Transformer 的注意力讓每個人都看每個人。
第二,份量怎麼來。GCN 的份量只由度數決定,事先就算好了;注意力的份量是看兩個人的特徵有多相近,每次輸入都重新算。
這兩條路後來慢慢匯在一起。有人讓 GCN 也依特徵分配份量,有人讓 Transformer 也看得到圖的結構。
最後整理一下
- 圖由節點和邊組成,鄰接矩陣記下誰和誰相連。
- 一層 GCN 讓每個人和朋友、自己取加權平均,份量由兩邊的度數決定,再乘上 、過 ReLU。
- 疊 層看得到 步以內的人;疊太多層,大家會變得一樣。
- 只要少數答案,靠著朋友關係,GCN 就能猜出其他人。
如果你想知道後來的人怎麼改進這一行公式,可以接著讀〈圖卷積大觀園〉。那篇從頭到尾用的,正是這六個人的朋友關係,只是名字縮成了 A 到 F。
之後在論文裡看到 ,記得它就是 Bob 從 Carol 那裡拿走 0.29 的那條算式。