2026 年 9 月 5 日,Ultralytics 發布 ultralytics 8.4.142。發布說明裡寫著,YOLO26 的預測與驗證,預設改回 one-to-many 的輸出頭,後面再接 NMS,理由是它「通常比不需要 NMS 的 one-to-one 頭準確」。想要原本那條路,得自己加上 nms=False。Ultralytics v8.4.142
八個月前,同一個模型正式上市,發布說明的第一個重點寫的正好相反。原生的端到端設計,完全不需要 NMS 後處理,延遲更低,匯出也更簡單。Ultralytics v8.4.0
再往前推六年,2020 年 Facebook AI 的 DETR 在摘要裡寫著,它的做法可以拿掉許多手工設計的元件,「像是非極大值抑制(NMS)或 anchor 的生成」。DETR 摘要
NMS 被拿掉,又被加了回來。這篇從一個物件為什麼會被框好幾次開始,看 DETR 怎麼讓每個物件只配一個預測、為此付出了什麼,再看 DETR 和 YOLO 這兩條路線,最後怎麼在中間碰頭。
一隻狗,三個框
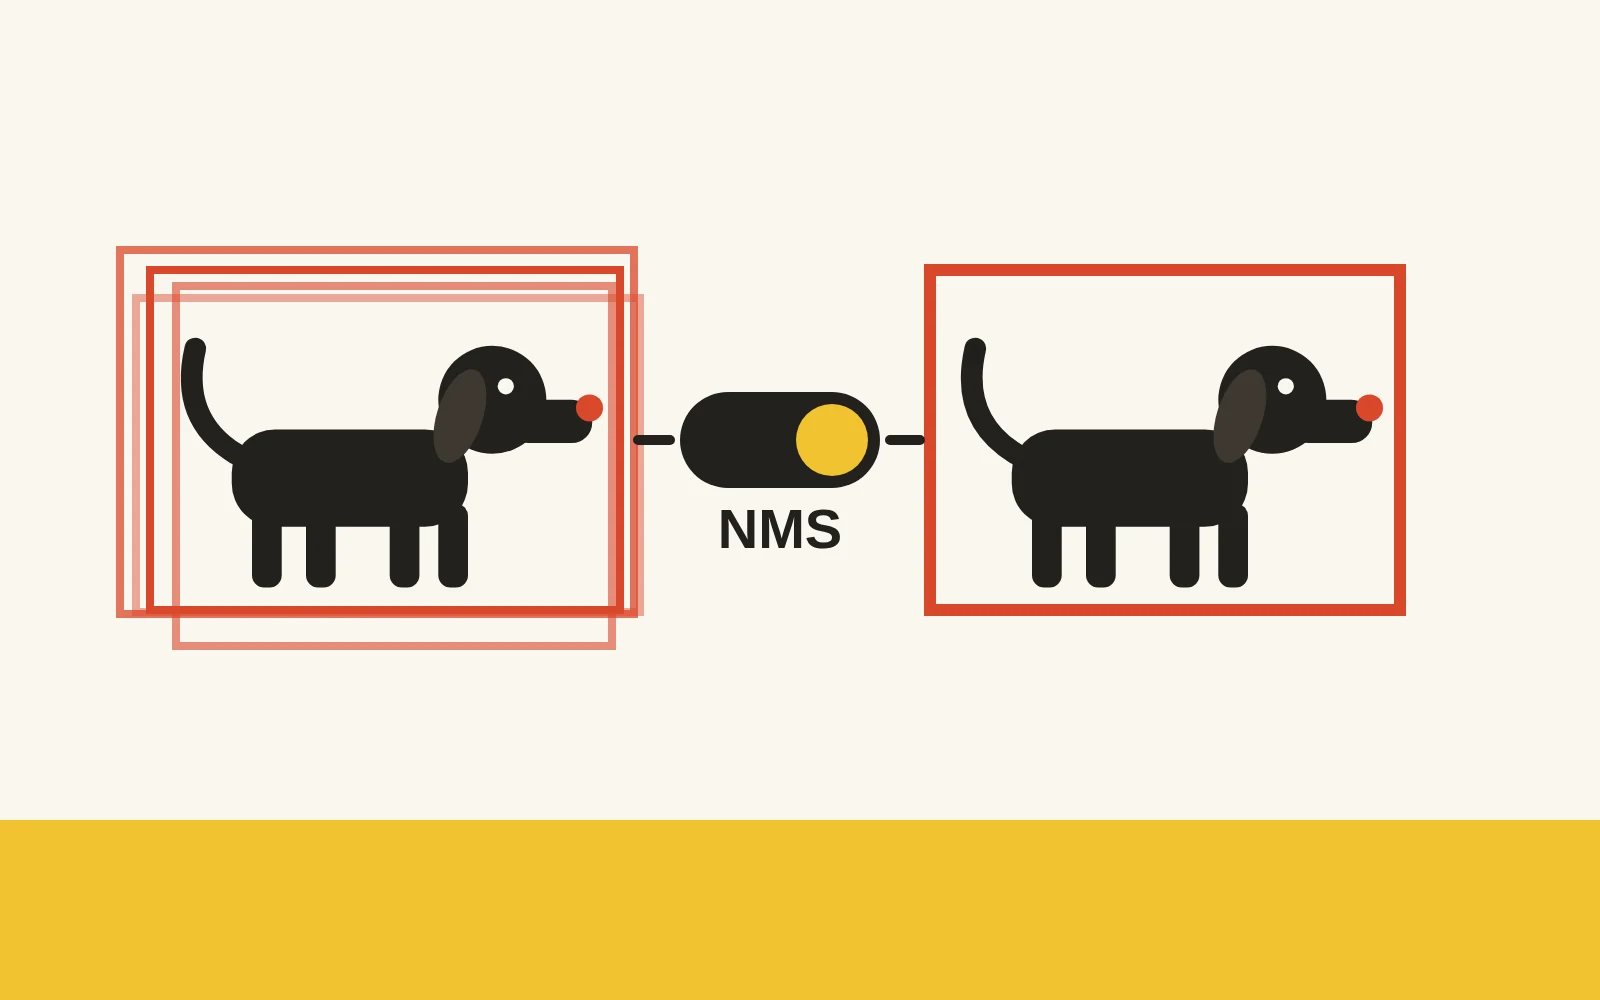
偵測器從來不只猜一個框。以 YOLO26 為例,640×640 的輸入在三種解析度的特徵圖上,一共有 8,400 個位置,每個位置都輸出一組類別分數和框。YOLO26 文件
訓練時,YOLO 系列用的是 one-to-many(一對多) 的標籤分配。一個標註物件附近,分數和框都夠好的幾個位置,全部當成正例;YOLO26 的一對多頭,每個物件最多取 10 個。YOLO26 論文 §3.2.1 模型被這樣教下來,看到一隻狗,附近好幾個位置都會說「這裡有狗」。
所以推論時,同一隻狗會冒出好幾個框。這時就輪到 NMS(non-maximum suppression,非極大值抑制) 收拾局面。它先依分數排序,留下最高的框,把和它重疊太多的同類框刪掉,再對剩下的框重複同一件事。重疊的程度用 IoU 衡量,也就是兩個框的交集面積除以聯集面積。
拿四個框試一次。A、B、C 都框在同一隻狗身上,D 框住旁邊的貓。A 的分數最高,B 和 A 的 IoU 是 0.904,C 和 A 是 0.656。門檻設 0.5,B、C 都被刪掉,狗和貓各留一個框;門檻放寬到 0.7,C 沒被刪掉,同一隻狗就多了一個框。
反過來看,門檻設得太嚴也有麻煩。如果 C 框住的其實是第二隻緊貼著 A 的狗,0.5 的門檻會把它當成重複框刪掉。人群照片最常遇到這件事。CrowdHuman 資料集平均每張圖有 22.6 個人,每張圖約有 2.4 對人的框 IoU 超過 0.5,COCO 的人物照片只有 0.02 對。作者也寫到,門檻調低,召回率會大跌;門檻調高,誤報變多。CrowdHuman §1
門檻還會連動準確率和時間。RT-DETR 的作者在 T4 GPU 上量過 YOLOv8,IoU 門檻固定 0.7,信心門檻從 0.001 調到 0.05,AP 從 52.9 掉到 51.2,NMS(TensorRT 的 EfficientNMS)本身的時間則從 2.36 ms 降到 1.06 ms。RT-DETR Table 1 NMS 也是一段要另外部署的後處理,模型匯出到不同推論平台時,得各自處理。
右半張表固定 IoU 門檻,只改信心門檻,可以直接看準確率與 NMS 時間怎麼一起變。
DETR 讓每個物件只配一個預測
DETR 準備了固定數量的預測插槽(query),標準模型是 100 個。每個插槽輸出一個類別和一個框,類別裡多了一個「沒有物件」。
訓練時,DETR 不讓好幾個插槽同時認領同一個物件。它把預測和標註做一對一(one-to-one)配對,在所有配法裡挑總成本最低的那一種;成本同時看類別分數對不對、框差多遠。這個最佳配對用匈牙利演算法求得。DETR §3.1
用三個插槽、兩個物件走一次。表裡是每個插槽配給每個物件的成本,越小越好:
| 插槽 | 狗 | 貓 |
|---|---|---|
| 1(框在狗身上) | 0.2 | 1.5 |
| 2(也框在狗身上) | 0.3 | 1.4 |
| 3(框在貓身上) | 1.6 | 0.4 |
總成本最低的配法,是插槽 1 配狗、插槽 3 配貓,總成本 0.6;插槽 2 沒配到,訓練目標是「沒有物件」。
插槽 2 的框其實不差,只比插槽 1 多一點成本。可是狗已經有人負責,它拿到的訓練目標是「沒有物件」。一直這樣訓練下去,同一個物件上的第二個框會被壓下來,推論時也就用不著 NMS。
DETR 的作者還在每一層 decoder 的輸出後面接上 NMS 檢查。第一層加 NMS 有幫助,因為單一層的預測容易重複;到了後面幾層,插槽之間的自注意力已經學會互相避讓,NMS 反而會刪掉正確的框,讓 AP 小幅下降。DETR §4.2、Figure 4
同色的實線與虛線,分別是直接輸出與加上 NMS 的結果。
只是和 Faster R-CNN 打到同樣的 42.0 AP,DETR 要訓練 500 個 epoch;Deformable DETR 的作者整理過,那是約 2,000 個 GPU 小時,Faster R-CNN 只要 380。Deformable DETR Table 1 小物件也比較吃力,AP_S 是 20.5,Faster R-CNN 是 26.6。DETR Table 1
三百個預測,只有不到三十個在學框
DETR 為什麼學得這麼慢,後來的論文給了不同的診斷。Deformable DETR 認為問題在注意力,初始化時注意力平均灑在整張特徵圖上,要很久才學會聚焦。Deformable DETR §1 DN-DETR 認為問題在配對不穩,同一張圖、同一個插槽,這一輪配到狗,下一輪可能配到貓。DN-DETR §1 第三種說法是正例太少。這篇順著它走,因為它和 NMS 直接有關。
H-DETR 的作者指出,Deformable DETR 每張圖有 300 個插槽,COCO 將近 99% 的照片標註框少於 30 個,所以每張圖只有不到 30 個插槽配得到物件,學得到框該畫在哪;其餘 270 多個插槽,只拿到「沒有物件」的分類訓練。H-DETR §1
DEIM 的作者把正例數直接畫出來比。一對一配對下,每張圖的正例數集中在 10 個以內;改用 YOLO 那種一對多分配,有些照片一張就超過 80 個正例,極端情況多了約 10 倍。DEIM §3.2、Figure 3
一對一的推論很乾淨,每個物件一個框,可是訓練時監督太稀;一對多的監督很密,推論時卻一定要 NMS 收拾。接下來六年,兩條路線都在想辦法兩邊都要。
DETR 這邊,訓練時把一對多補回來
2022 年的 H-DETR,在原本 300 個一對一的插槽之外,訓練時再加一組 1,500 個插槽,把每個標註物件複製 6 份,讓這一組用一對多的方式配對;兩組之間用遮罩隔開,互不干擾。推論時,只留下原本那 300 個一對一的插槽。H-DETR §3.2
先看最左邊的 Hybrid-Branch:藍色分支在訓練和推論都使用,綠色分支只在訓練使用。
H-DETR 的 Table 13 把幾種接法放在一起比。這是 COCO 上分別訓練 12、24、36 個 epoch 的 AP,FPS 在 V100 上量:
| 訓練方式 | 推論時用的輸出 | 是否接 NMS | AP(12/24/36 ep) | FPS |
|---|---|---|---|---|
| 只用一對多 | 一對多 | 接 | 49.4/50.2/48.8 | 5.3 |
| 混合訓練 | 一對多那一組 | 不接 | 13.5/13.1/12.9 | 6.5 |
| 混合訓練 | 一對多那一組 | 接 | 48.6/49.8/49.9 | 5.4 |
| 混合訓練 | 一對一那一組 | 不接 | 48.7/49.9/50.0 | 6.7 |
第二列是一對多輸出不接 NMS 的樣子,AP 只剩 13 左右,重複框把成績整個拖垮。同一個模型,接上 NMS 就回到 49 上下;而一對一那一組什麼都不接,成績差不多,速度最快。只用一對多訓練、再接 NMS,在 12 個 epoch 時還高一點,到 36 個 epoch 就被追過了。
其他幾條路,做法不同,形狀卻一樣:
- 加練習題。DN-DETR 把加了雜訊的標註框當成額外的插槽餵給 decoder,要模型還原成原本的框;這份練習推論時整個拿掉。DN-DETR §4.3 2022 年的 DINO 再加上負樣本等幾項改進,ResNet-50 的 5-scale 模型 12 個 epoch 就做到 49.4 AP;換上 SwinL 骨幹、先在 Objects365 預訓練之後,它也成了第一個登上 COCO 排行榜第一名的端到端 Transformer 偵測器。DINO 摘要、§1
- 多開幾組插槽。Group DETR 訓練時同時跑好幾組共享權重的插槽,各自做一對一配對,推論時只留一組。LW-DETR 用了 13 組,後來的 RF-DETR 也沿用。LW-DETR §3.3
- 一張圖裡放更多物件。2024 年底的 DEIM 不改配對方式,改資料。它用 Mosaic 把四張照片縮小拼成一張,或用 Mixup 把兩張疊成一張,平均每張訓練圖的物件從約 10 個變成約 25 個,一對一配對的正例也跟著變多。這份增強只開到訓練的一半左右,RT-DETRv2 用 36 個 epoch 做到 53.6 AP,原本要 72 個 epoch 才有 53.4。DEIM §3.2、Table 6、Table 12
這些額外的監督,全部只活在訓練階段。推論時,DETR 還是每個物件一個框,不接 NMS。
RT-DETR 連 NMS 一起計時
訓練變快之後,DETR 剩下的問題是推論太慢。2023 年 4 月,百度的 RT-DETR 直接把結論寫在標題上,叫《DETRs Beat YOLOs on Real-time Object Detection》。它後來發表在 CVPR 2024。
這篇論文先檢查了 YOLO 的速度是怎麼量的。作者指出,YOLO 系列回報速度時,通常只算模型本身,不含 NMS 的時間。RT-DETR §3.1 他們於是建立一套端到端的測法,把 TensorRT 的 NMS 外掛接在 YOLO 後面,用驗證時的門檻一起計時。在 T4 GPU、TensorRT FP16 下,RT-DETR-R50 做到 53.1 AP、108 FPS;同樣的測法下,YOLOv8-L 是 52.9 AP、71 FPS。RT-DETR Table 2
RT-DETR 也沒有逃出上一節的規律,它的 decoder 訓練時同樣帶著 200 個去雜訊的插槽。RT-DETR 附錄 Table A
YOLO 那邊,多接一個一對一的頭
一年後,YOLO 這邊換了一個方向。2024 年 5 月,清華大學的 YOLOv10 保留原本一對多的輸出頭,再多接一個一對一的頭。訓練時兩個頭一起學;推論時把一對多的頭丟掉,只用一對一的頭輸出,不需要 NMS。YOLOv10 §3.1
左圖把共用的骨幹與兩個輸出頭畫在一起,右圖則比較兩個頭選到相同候選的頻率。
兩個頭要學得起來,挑正例的標準得一致。YOLOv10 讓兩個頭用同一套打分方式選正例,一對多的頭取前幾名,一對一的頭只取第一名,這樣一對多頭眼中最好的那個框,也是一對一頭的正例。
它的消融實驗把三種做法放在一起比(YOLOv8-S 為基礎,延遲含 NMS,T4、TensorRT FP16):
| 訓練時的頭 | AP | 延遲 |
|---|---|---|
| 只有一對多(推論接 NMS) | 44.9 | 7.07 ms |
| 只有一對一 | 43.4 | 2.44 ms |
| 兩個一起訓練,推論用一對一 | 44.3 | 2.44 ms |
只訓練一對一的頭,延遲很漂亮,AP 掉了 1.5。多接一個一對多的頭陪練,就補回大半。會不會只是多算了幾輪?作者也想到了,讓只有一對一頭的 YOLOv10-M 多訓練到 550 個 epoch,花的時間和原本差不多,AP 仍然是 48.9 對 51.1。YOLOv10 Table 15 多練幾輪補不回來,得靠一對多的監督。
差距也沒有完全消失。作者自己寫明,小模型上一對一的頭還是輸給一對多加 NMS,YOLOv10-N 差 1.0 AP,YOLOv10-S 差 0.5;到 YOLOv10-X 才看不出差距。YOLOv10 §4.3、附錄 A.9
YOLO26 接著這條路往下走。它在 2025 年 9 月 25 日的 YOLO Vision 2025 上預告,2026 年 1 月 14 日正式發布,論文則在 6 月上傳。作者認為 YOLOv10 讓兩個頭從頭到尾分到一樣的權重,推論時唯一用到的一對一頭反而練得不夠。YOLO26 改成漸進式的權重,一對多和一對一的損失從 0.8 比 0.2 開始,隨著訓練線性移到 0.1 比 0.9。YOLO26 論文 §3.3.2、§4.1
連權重的起點都試過了。一開始就把一對一頭的權重設成 0,最後成績和固定各占一半差不多;表現最好的是預設的排法,從 0.8 比 0.2 起步,再慢慢把重心移到一對一頭。YOLO26 論文 Table 5 DEIM 也在訓練到一半時關掉多出來的正例,兩邊都是先密後疏。
量速度的時候,NMS 算不算?
拿掉 NMS 最直接的好處是快,但「快多少」很難量得一致。同一個 YOLOv8-N,在 YOLOv10 的測法下總延遲是 6.16 ms,其中模型本身只占 1.77 ms,剩下的大多是 NMS;YOLOv10 用驗證時的門檻,信心門檻低,留下的候選多。YOLOv10 Table 1 到了 RF-DETR 的測法,信心門檻調到 0.01,同一個模型的總延遲是 2.1 ms。RF-DETR Table 2
Roboflow 在 2025 年 3 月發表 RF-DETR 時,在發布文章裡寫道,大多數 YOLO 的評測用 NMS 來算準確率,回報速度時卻沒有把 NMS 算進去。Roboflow,2025-03-20 後來的 RF-DETR 論文又多列了兩項,GPU 連續推論時會降頻,還有人用 FP16 的模型量延遲、FP32 的模型量準確率;作者主張同一個模型檔同時量兩者。RF-DETR §4 RF-DETR 以 DINOv2 為骨幹,2XL 版本在 T4 上 17.2 ms、60.1 AP,作者說這是第一個在 COCO 上超過 60 AP 的即時偵測器。論文後來發表在 ICLR 2026。
讀這些比較時,也要記得各家的立場。Roboflow 和 Ultralytics 是直接的競爭對手。YOLO26 論文在 Hacker News 上討論時,自稱 Roboflow 共同創辦人的使用者就質疑,論文在主圖上宣稱準確率與延遲的取捨最好,比較對象卻沒有新的 DETR。Hacker News,2026-06-23 主圖 Figure 1 比的是 YOLO 各代、PP-YOLOE+、DAMO-YOLO 和 RTMDet;DETR 系列只放在附錄的 Table S8,裡面也沒有 RF-DETR。反過來看,Roboflow 在 2026 年 1 月比較 RF-DETR 和 YOLO26 的文章,引用的 YOLO26 數字是官方表格上的 53.1 AP、4.7 ms;依 Ultralytics 文件的註腳,這組準確率來自一對多加 NMS,延遲卻是不接 NMS 的一對一頭量的。YOLO26 文件、Roboflow,2026-01-15
Ultralytics 自己的端到端指南也建議,比較準確率和延遲時,要用同一個輸出頭、同樣的影像尺寸、精度和硬體。Ultralytics 端到端偵測指南
NMS 為什麼又回來了
回到開頭那次預設值的改動。YOLO26 的一對一頭,在五種模型大小上都比一對多加 NMS 少 0.6 到 0.8 AP。YOLO26 論文 §4.4 論文當時就寫了,如果目標平台跑得動 NMS、又最在意準確率,一對多的頭仍然可以優先考慮。到了 8.4.142,Ultralytics 乾脆把它設成預設。
部署也是原因之一。依 Ultralytics 的指南,NCNN、RKNN、Edge TPU、Qualcomm QNN 等平台,如果運算子撐不起端到端的輸出,就會退回一對多的頭;部分 INT8 的 TensorRT 設定也一樣。Ultralytics 端到端偵測指南
重複框也沒有完全消失。DINO 的作者就承認,靠配對損失和自注意力壓掉重複框,這份能力有限。DINO §3.3 使用者回報的問題也一路都有。2024 年 6 月,有人用自己的資料微調 YOLOv10-M,訓練了一兩千個 epoch 仍有幾乎重疊的重複框,最後加回 NMS 解決。THU-MIG/yolov10 #236 2026 年 7 月,Ultralytics 的協作者回覆 YOLO26 類似的回報時說,YOLO26n 偶爾會輸出重複框,需要的話可以接 NMS,「框不多,應該很快」。ultralytics #25304 RF-DETR 的第一作者也給過同樣的建議,同時補了一句,資料夠多時模型應該要自己學會。rf-detr #187
擁擠的場景裡,一對一的偵測器能輸出幾個框,取決於插槽有幾個。在 CrowdHuman 上,只有 100 個插槽的 DETR 是 75.9 AP,比用 NMS 的 FPN 偵測器(85.8)低很多;換成 1,000 個插槽的 Deformable DETR,就做到 91.5。Iter-E2EDET Table 2 物件一多,先看插槽夠不夠。
NMS 還在,只是位置變了。它從推論時一定要做的步驟,變成一個可以開、可以關的選項。
回到你自己的偵測器
最後整理一下這六年:
- 一個物件只配一個預測,訓練時很貴。一對一配對讓推論不需要 NMS,代價是正例太少、收斂太慢。
- 兩條路線都在訓練時多給正例。DETR 這邊加一對多的分支、去雜訊的練習或多組插槽;YOLO 這邊保留一對多的頭陪練,推論改用一對一的頭。
- NMS 變成選項。一對一的頭省掉後處理;一對多加 NMS 仍然多出零點幾 AP,也更容易部署到各種平台。
如果你正在挑偵測器,可以先把三件事弄清楚。比較速度時,先確認 NMS 有沒有算進去、用的是哪個門檻;照片裡的物件很多或很擠時,先看插槽上限,必要時保留 NMS;要部署到手機或邊緣裝置,先確認那個平台跑不跑得動一對一的輸出。
DETR 當年押下的賭注,到現在還在繼續。
那,如果是站在第一線的工程師的角度來看,NMS 能刪嗎?
反正我們是不敢。