原始论文
Visual Instruction Tuning
- 发表版本
- NeurIPS 2023会议
- arXiv 首次提交
- arXiv:2304.08485
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multimodalityllava2023,
  title = {{Visual Instruction Tuning}},
  author = {Haotian Liu and Chunyuan Li and Qingyang Wu and Yong Jae Lee},
  year = {2023},
  eprint = {2304.08485},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2304.08485}
}
OpenAI 在 2023 年 3 月发布的 GPT-4 技术报告里,有几个看图回答的例子。其中一张照片是一名男子站在出租车后面熨衣服,GPT-4 被问「这张图哪里不寻常」,回答得很到位。但那时看图的功能没有开放,大家只能看报告里的截图。
开源这边,LLaMA 刚发布不久,Alpaca、Vicuna 用机器生成的指令数据微调 LLaMA,做出了还不错的聊天模型。这些全都只有文字。
一个月后,威斯康星大学、微软研究院与哥伦比亚大学的 Liu、Li 等人发表了 LLaVA(Large Language and Vision Assistant),把指令微调搬到了图文多模态上。这篇最有意思的地方在数据,他们请 GPT-4 帮忙生成「看图对话」的训练数据,但当时的 GPT-4 看不到图,用的是只吃文字的版本。
定义问题
在这之前,视觉模型大多是一个任务一个模型。分类、检测、分割、看图说话各自训练,语言只用来描述图片内容,用户能下的指令很有限。
另一边,Flamingo、BLIP-2 这类图文模型已经能把图像接上大语言模型,在看图说话、视觉问答上表现不错。但它们用的是大量图文对训练,没有专门练过「按用户的指令回答」,问它「这张图哪里不寻常」,它多半只会描述图片。
要让模型学会按指令看图,就需要「图片 + 指令 + 回答」这种数据。网上的图文对很多,从 CC 到 LAION 都是,但图文指令数据几乎没有,请人写又很花时间,要写成什么样子也没有定论。
解决问题
让看不见图的 GPT-4 出题
最简单的做法,是把图文对直接改写成指令格式。图片 配说明文字 ,再随机挑一个「请简短描述这张图」之类的问题 :
Human : X_q X_v <STOP>
Assistant : X_c <STOP>
这很便宜,但问题和答案都很单调,没有任何推理。
作者改请只接受文字的 GPT-4(或 ChatGPT)当老师。既然它看不到图,就把图翻译成文字给它看,用两种符号表示:
- 说明文字:COCO 的每张图都有好几句人写的描述,从不同角度说明画面。
- 边界框:每个物体的类别和位置,坐标归一化到 0 到 1。
论文的例子是一张地下停车场的照片:
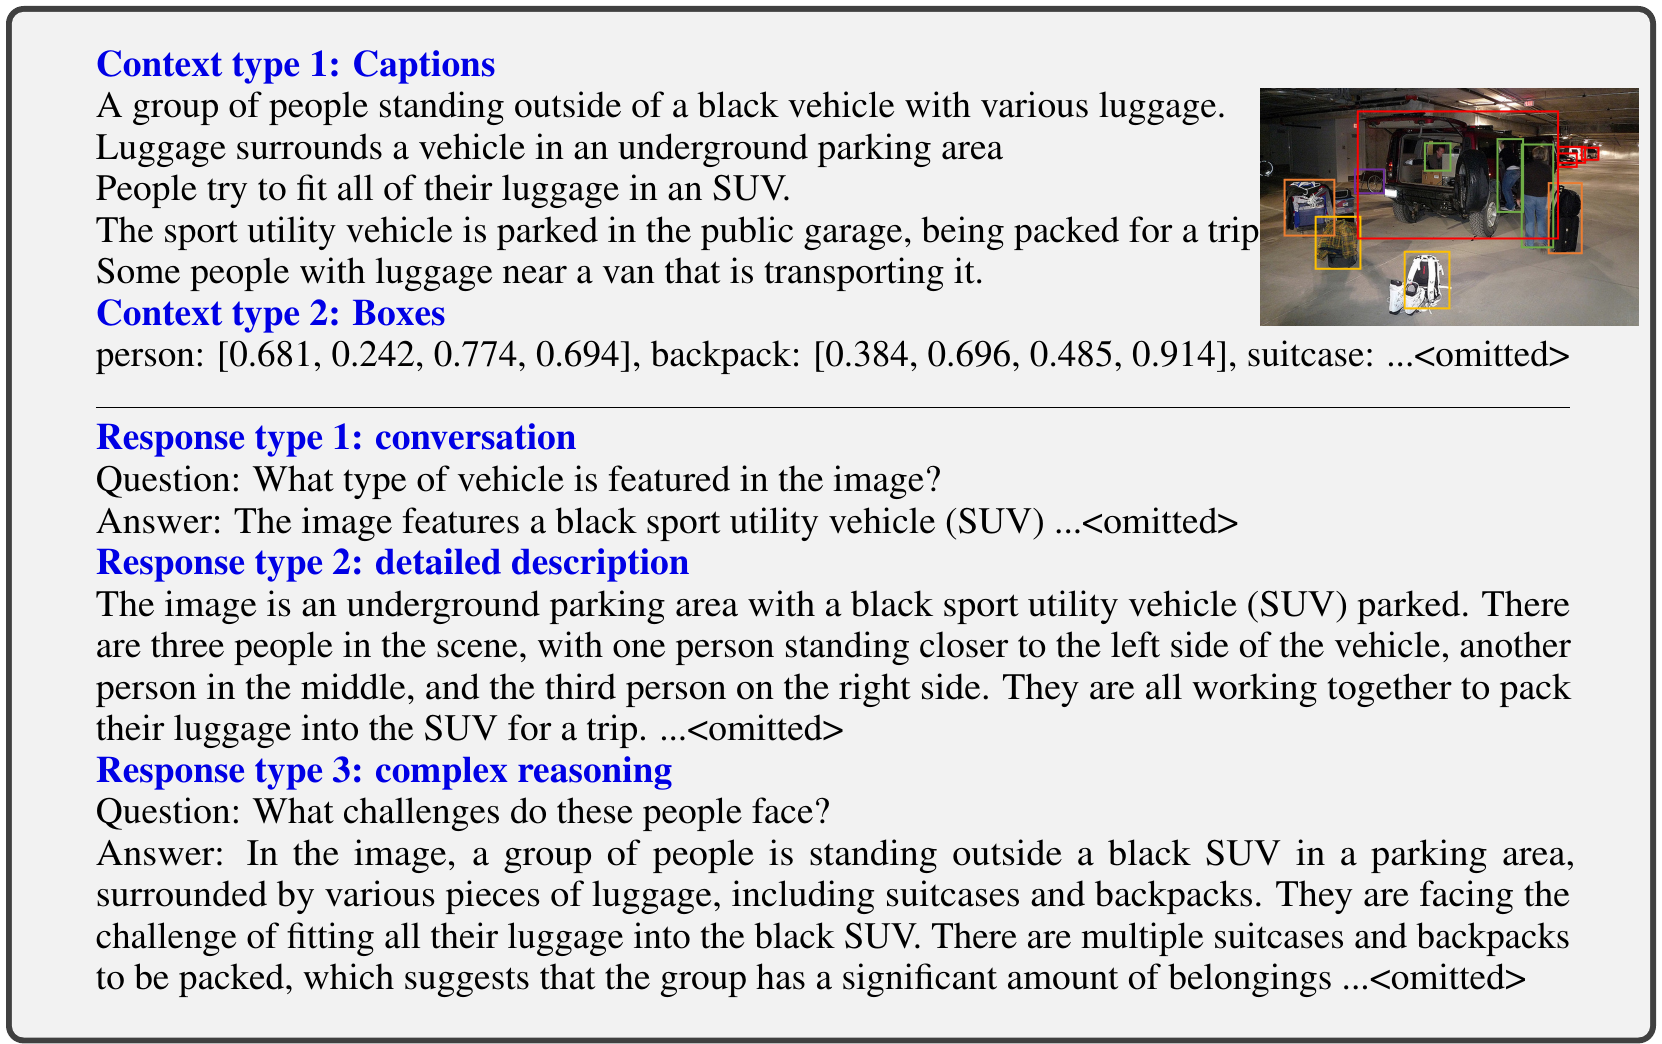
上半部分就是 GPT-4 收到的全部内容,五句说明文字加上一串边界框。右上角那张照片是论文放给读者看的,GPT-4 本身看不到。下半部分是它照着这些文字写出来的三种回答。
然后请它生成三种数据:
- 对话:模拟用户问、助手答,语气要像助手真的看着这张图。问题涵盖物体种类、数量、动作、位置、相对位置,只问有明确答案的事。例如「图中是什么车?」「一辆黑色的运动型多用途车(SUV)……」。
- 详细描述:从事先整理好的一串问题里随机抽一个,例如「详细描述这张图」,请它写出完整描述,例如「这是一个地下停车场,有一辆黑色 SUV 停着。画面里有三个人……他们正一起把行李装进 SUV,准备出门。」
- 复杂推理:需要一步步推理的问题,例如「这些人遇到了什么困难?」答案是「他们周围有好几个行李箱和背包,要全部塞进这辆 SUV 不容易……」。
每一种都先由作者手写几个示例,当作 GPT-4 的少样本提示,这是整个数据收集过程中唯一的人工标注。最后得到 158K 条:对话 58K、详细描述 23K、复杂推理 77K。作者在早期实验中比较过 ChatGPT 和 GPT-4,GPT-4 生成的数据一直更好,空间推理尤其明显。
老师看不到图,只读过图的文字描述,学生却要真的看图作答。这一点后面还会再回来。
架构:一层线性投影
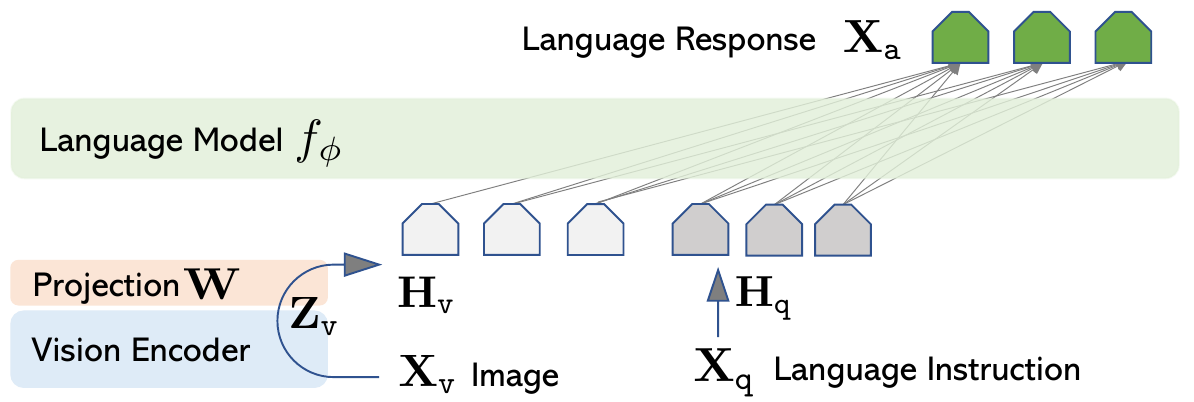
架构非常简单,三个零件:
- 视觉编码器:预训练好的 CLIP ViT-L/14,把图片切成小块,每块输出一个特征向量 。作者用的是最后一层 Transformer 之前那一层的特征。
- 投影矩阵 :一个线性层,把每个图像特征转成和语言模型词嵌入一样的维度,。
- 语言模型:Vicuna,也就是用 ShareGPT 上用户分享的 ChatGPT 对话微调 LLaMA 得到的聊天模型。作者选它,是因为它是当时开放权重模型里最会按指令回答的。
转完之后,图像特征就和文字的词嵌入长得一样,可以直接拼在一起送进语言模型。以 224×224 的图为例,CLIP ViT-L/14 每 14×14 像素切一块,得到 256 个 1024 维的特征;投影矩阵把它们变成 256 个 5120 维的视觉 token,连同偏置约 525 万个参数。这 256 个 token 接在指令文字的 token 前面,对语言模型来说,它们只是一串意思比较特别的「字」。
连接两边的只有这个 525 万参数的线性层。作者也提到可以用更复杂的接法,例如 Flamingo 的门控交叉注意力或 BLIP-2 的 Q-Former,但简单的投影让他们能快速做数据方面的实验,就先用了这个。
训练:两阶段
每张图的多轮对话组成一条序列。第一轮随机决定图放在问题前面还是后面,之后各轮只放问题;损失只算助手的回答,包括该在哪里停下来的 <STOP>(实现上是 ###)。
第一阶段,对齐特征。 从 CC3M 筛出 59.5 万组图文对,用前面那个简单的改写方式变成单轮对话。视觉编码器和语言模型都冻结,只训练投影矩阵 。作者的说法是,这一步相当于为冻结的语言模型训练一个兼容的「视觉分词器」。在 8 张 A100 上跑 1 个 epoch,4 小时内完成。
第二阶段,端到端微调。 视觉编码器仍然冻结,投影层和语言模型一起训练。聊天版用前面的 158K 指令数据训练 3 个 epoch,约 10 小时;另外也训练了一个 ScienceQA 版本,把问题和上下文当指令,推理过程和答案当回答。
讨论
熨衣服的男人
作者先拿 GPT-4 报告里那张图来试,问「这张图哪里不寻常?」。
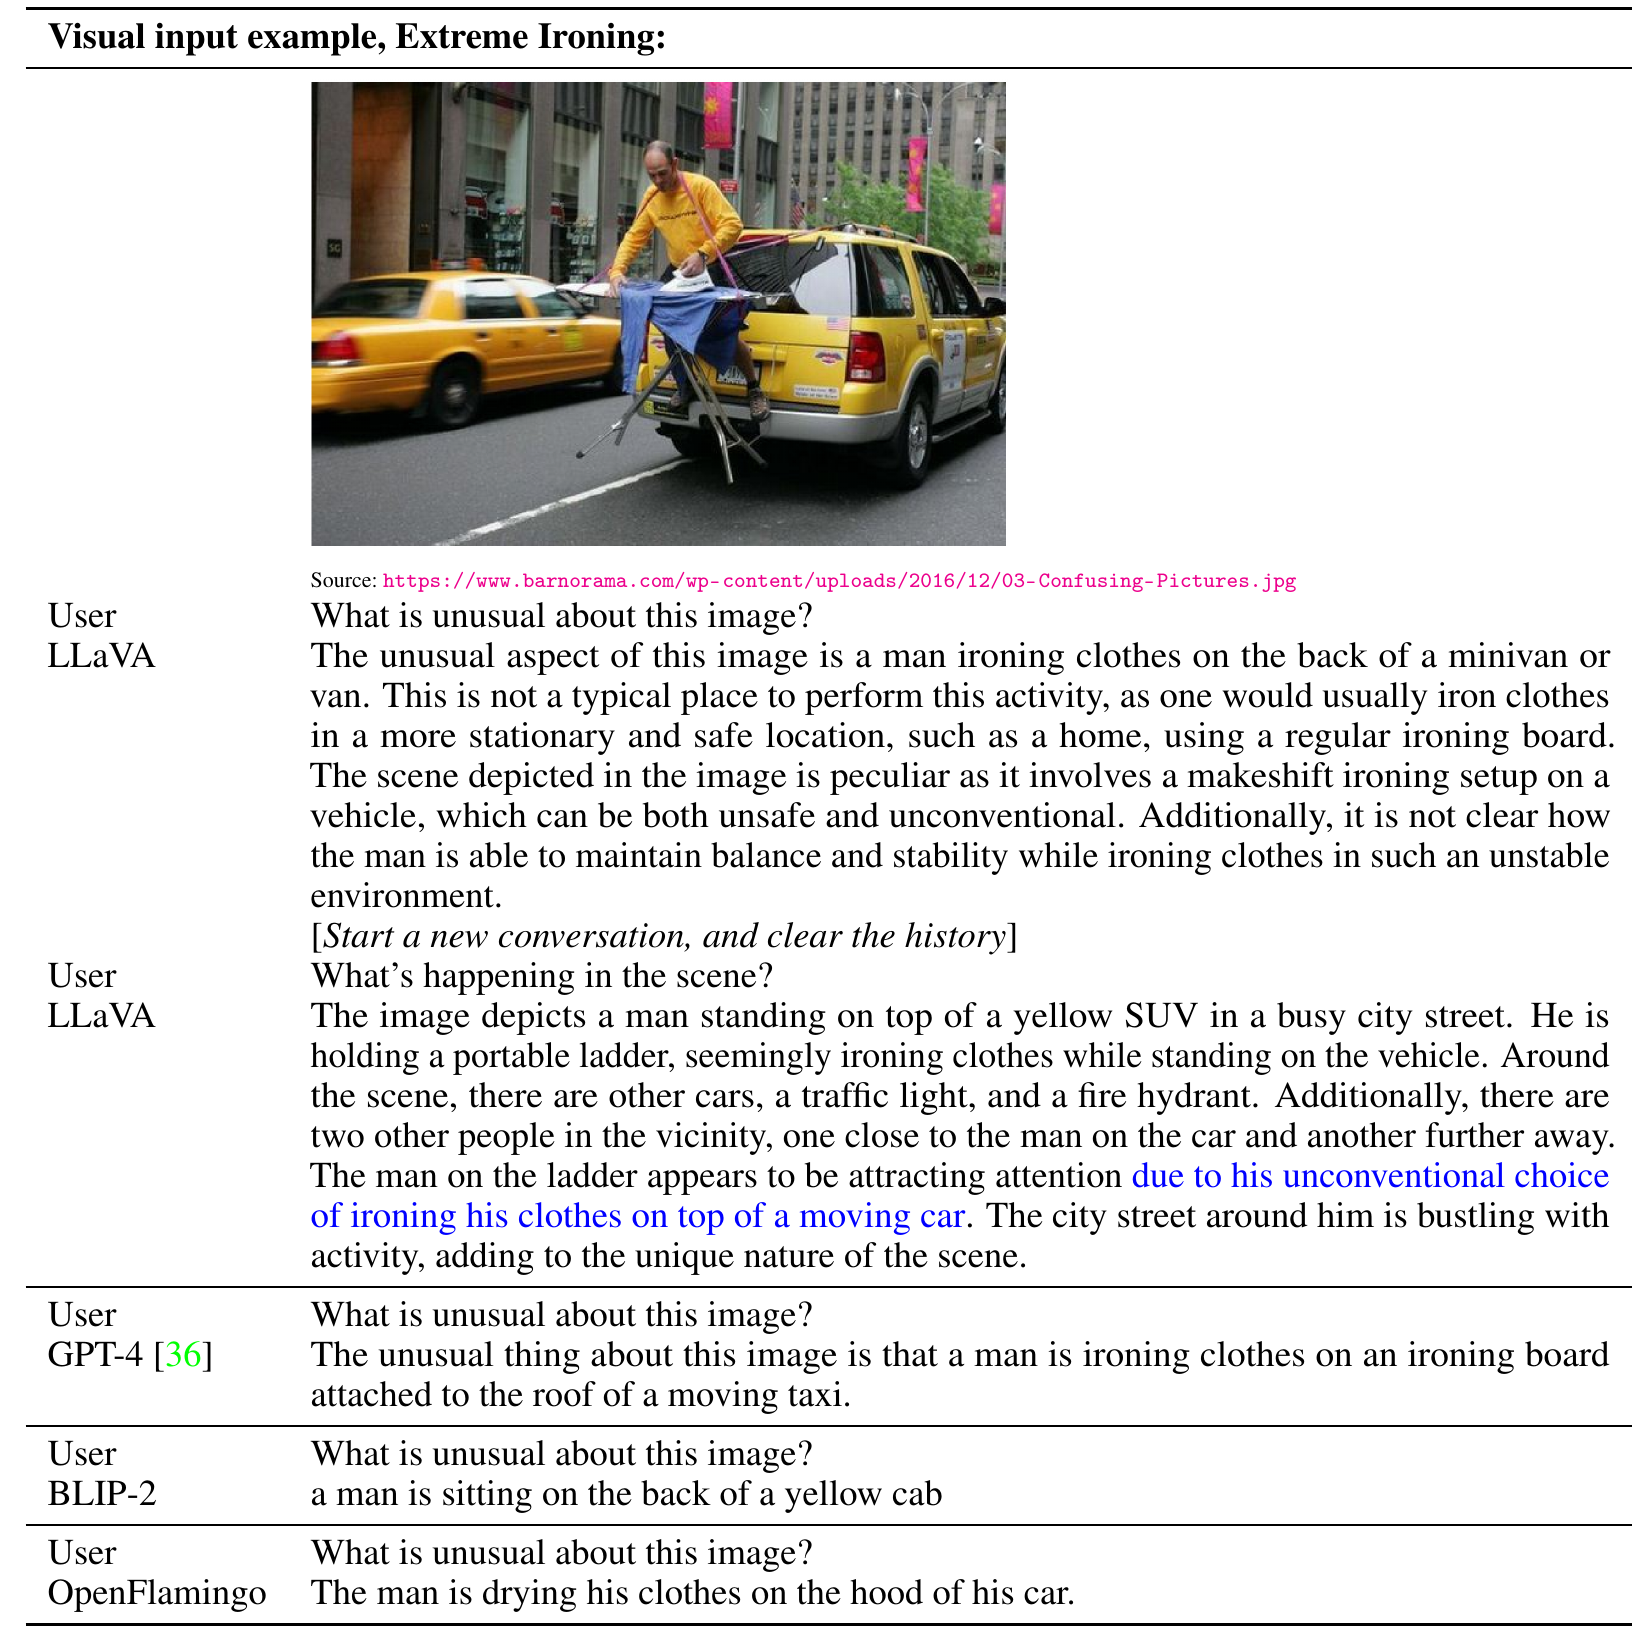
各模型的回答节选如下:
- LLaVA:不寻常的是一名男子在小型面包车的后面熨衣服,一般人会在家里用熨衣板熨……也不清楚他在这么不稳的地方要怎么保持平衡。
- GPT-4:这张图不寻常的地方是,一名男子在一辆行驶中的出租车车顶上,用绑着的熨衣板熨衣服。
- BLIP-2:一名男子坐在黄色出租车的后面。
- OpenFlamingo:这名男子在自己车子的引擎盖上晾衣服。
BLIP-2 和 OpenFlamingo 都只是在描述画面,而且描述得不太对。LLaVA 回答了问题,和 GPT-4 抓到的重点一样。
作者另外开一段新对话,只问「画面里发生了什么事」,LLaVA 在描述完街景后,也主动提到这名男子因为在行驶中的车顶上熨衣服而引人注目。训练数据只有约 8 万张不重复的图,这张图也不在其中。
用 GPT-4 当评委
光看几个例子不够,作者也设计了量化评估。做法是让 LLaVA 看图作答,同时让只吃文字的 GPT-4 读标准的文字描述作答,当作近似的上限;再把问题、文字描述和两个答案交给 GPT-4 评分,从有用、相关、正确和细节四个方面给 1 到 10 分。报告的「相对分数」,是 LLaVA 的分数除以 GPT-4 的分数。
第一个评测集取 COCO 验证集的 30 张图,每张图用同样的方式出三种题,共 90 题。用不同的训练数据比较:
| 训练数据 | 对话 | 详细描述 | 复杂推理 | 全部 |
|---|---|---|---|---|
| 全部数据 | 83.1 | 75.3 | 96.5 | 85.1 |
| 详细描述 + 复杂推理 | 81.5 | 73.3 | 90.8 | 81.9 |
| 对话 + 5% 详细描述 + 10% 复杂推理 | 81.0 | 68.4 | 91.5 | 80.5 |
| 只用对话 | 76.5 | 59.8 | 84.9 | 73.8 |
| 不做指令微调 | 22.0 | 24.0 | 18.5 | 21.5 |
整理自原论文 Table 4。
没有指令微调的模型只有 21.5,微调之后超过 70,差了 50 分以上。只用对话数据是 73.8,加入一小部分详细描述和复杂推理就升到 80.5,而且连对话题的分数也跟着上升。三种数据全用最好,85.1。
第二个评测集更难,24 张图、60 题,包括室内外场景、梗图、画作、素描,每张图都附上了非常详细的人工描述:
| 模型 | 对话 | 详细描述 | 复杂推理 | 全部 |
|---|---|---|---|---|
| OpenFlamingo | 19.3 | 19.0 | 19.1 | 19.1 |
| BLIP-2 | 54.6 | 29.1 | 32.9 | 38.1 |
| LLaVA | 57.3 | 52.5 | 81.7 | 67.3 |
整理自原论文 Table 5(三次推理运行的平均)。
LLaVA 整体 67.3,比 BLIP-2 高 29 分,比 OpenFlamingo 高 48 分。
这两个评测的评委和参考答案都是 GPT-4,分数只适合拿来比较模型之间的相对高低。
看不清楚的地方
作者也挑了两个 LLaVA 答不好的例子:
- 一兰拉面:问「这是哪家餐厅?」,要答对得认得出这家店,还要看得懂日文;问配菜,可能还得上网查。
- 打开的冰箱:问「蓝莓口味的酸奶是什么牌子?」要看清楚 Fage 的商标,需要高分辨率的图像和足够的知识。
最有意思的是第三题。冰箱里有酸奶,也有一盒草莓,但没有草莓口味的酸奶;问「冰箱里有草莓口味的酸奶吗?」,LLaVA 回答有。作者形容,它有时把图片当成「一袋小图块」,看到了酸奶、看到了草莓,却没弄懂两者之间的关系。
这和老师看不见图的训练方式脱不了干系。GPT-4 写的答案再好,也只根据文字描述和边界框;图里有、但描述没写到的细节,学生没机会学。
ScienceQA
ScienceQA 是 21,000 道科学选择题,涵盖自然、社会和语言科学,有的题目附图,有的只有文字。LLaVA 先写推理过程再写答案,训练 12 个 epoch,准确率 90.92%,接近当时最佳的 91.68%。
只吃文字的 GPT-4 用两个示例的少样本提示,可以拿到 82.69%,失败的题目很多是因为它回答「缺少图片或图表」。作者试了两种组合:
- GPT-4 补位:GPT-4 答不出来时改用 LLaVA 的答案,90.97%,和 LLaVA 单独作答差不多。
- GPT-4 当裁判:两者答案不同时,把题目和两个答案再交给 GPT-4,请它给出最后的答案,92.53%,刷新了当时的最佳成绩。
看不到图的 GPT-4,连附图的题目都能帮上忙。作者的解释是,有些附图的题目其实不看图也答得出来,GPT-4 能认出这类题目,修正 LLaVA 的一些错误。
ScienceQA 上的几个消融实验:
- 用最后一层的 CLIP 特征是 89.96%,比倒数第二层低 0.96。作者推测最后一层偏向整体、抽象的图像性质,倒数第二层保留了较多局部细节。
- 推理和答案谁先写,这组比较用的是最后一层的特征。先写答案、训练 12 个 epoch 是 89.77%;先写推理只要 6 个 epoch 就到了 89.77%,之后几乎不再进步。作者的结论是,先推理能加快收敛,对最终成绩的帮助不大。
- 跳过第一阶段的特征对齐、直接训练,掉到 85.81%。
- 模型从 13B 换成 7B,掉到 89.84%。
后来的事
半年后,同一组作者发表了 LLaVA-1.5。改动不多:图像分辨率提高到 336 像素,线性投影换成 MLP,再加入学术界的视觉问答数据,配上简单的回答格式提示。13B 的版本只用了 120 万条公开数据,在一台 8 卡 A100 的机器上约一天就能训练完,在 11 个评测上拿到了当时最好的成绩。
「视觉编码器 + 投影层 + 语言模型」这个骨架很好上手,后来不少开源多模态模型都沿用了;用 GPT-4 当评委打分的做法,也在之后的模型评测里越来越常见。
结论
指令数据不一定要人写,连多模态的也不用。LLaVA 把图片翻译成文字交给 GPT-4 出题,得到 158K 条数据,再用一层线性投影把 CLIP 接上 Vicuna,两阶段训练加起来,在 8 张 A100 上半天多就完成了,看图聊天的能力却已经能和 GPT-4 报告里的例子相比。
这篇的训练顺序很值得照抄。先冻结两端只训练投影层,让图像特征对上语言模型的词嵌入;再放开语言模型做指令微调。跳过第一步,ScienceQA 就少了 5 个百分点。
冰箱里到底有没有草莓口味的酸奶?LLaVA 很肯定地说有。大概是老师只告诉过它,「冰箱里有酸奶,也有草莓」。