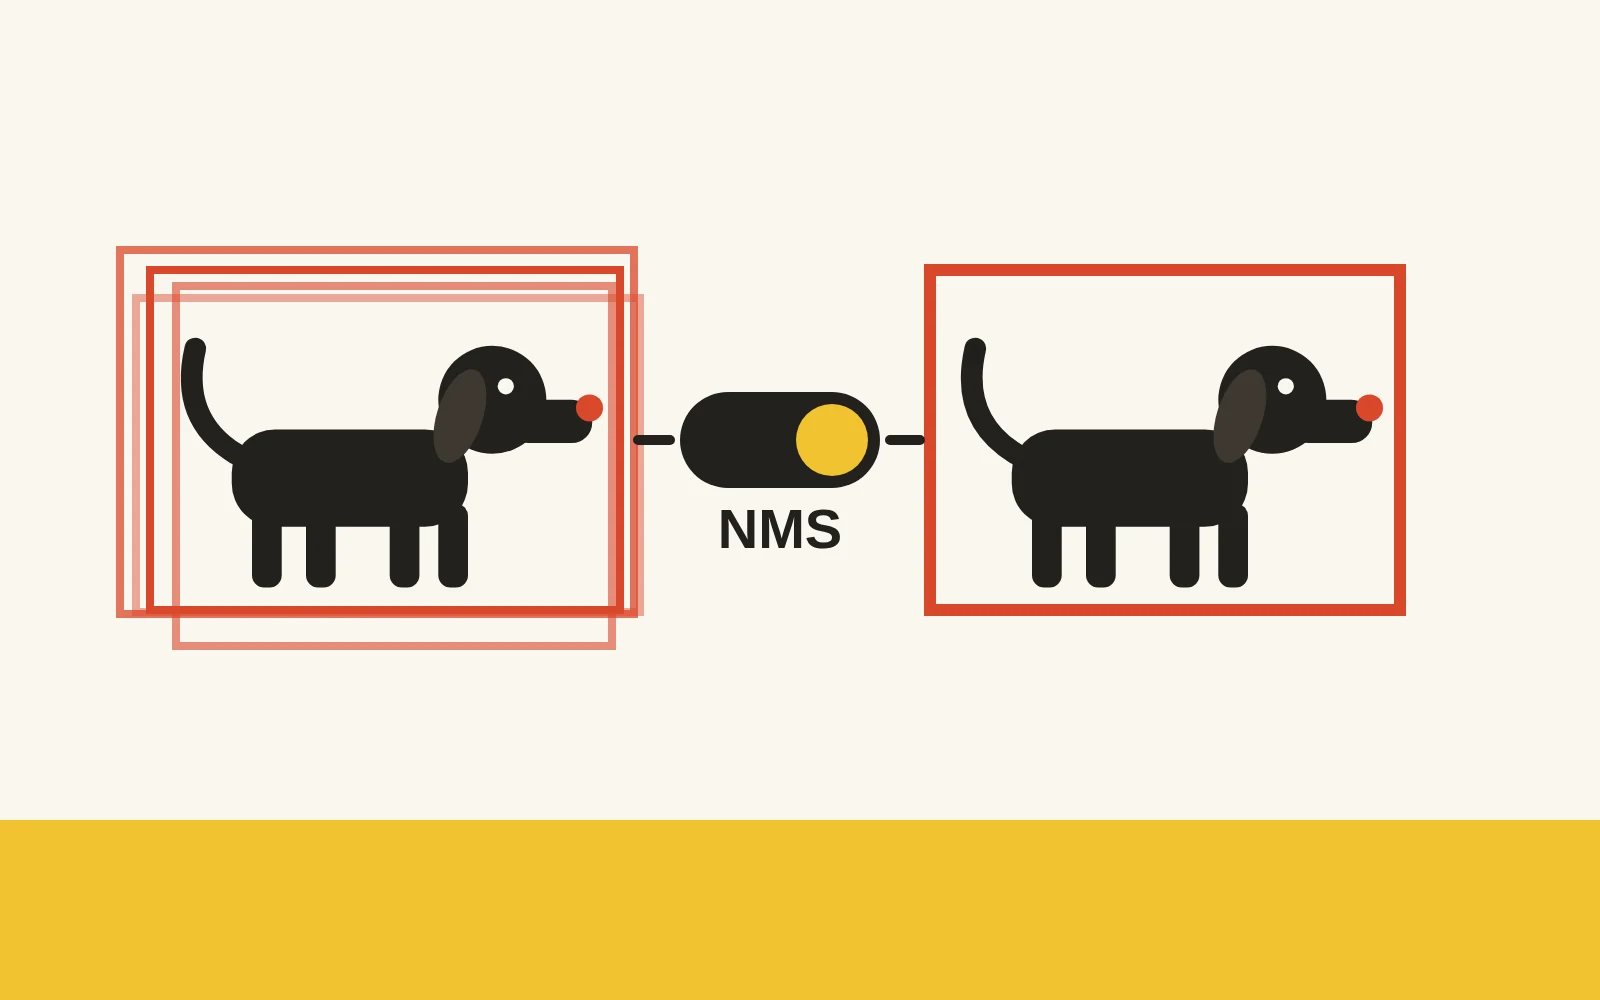
2026 年 9 月 5 日,Ultralytics 发布了 ultralytics 8.4.142。发布说明里写着,YOLO26 的预测与验证默认改回 one-to-many 的输出头,后面再接 NMS,理由是它「通常比不需要 NMS 的 one-to-one 头更准确」。想走原来那条路,得自己加上 nms=False。Ultralytics v8.4.142
八个月前,同一个模型正式上线,发布说明的第一个重点写的正好相反。原生的端到端设计,完全不需要 NMS 后处理,延迟更低,导出也更简单。Ultralytics v8.4.0
再往前推六年,2020 年 Facebook AI 的 DETR 在摘要里写道,它的方法可以去掉许多手工设计的组件,「比如非极大值抑制(NMS)或 anchor 的生成」。DETR 摘要
NMS 被拿掉,又被加了回来。这篇文章从一个物体为什么会被框好几次说起,看 DETR 怎样让每个物体只对应一个预测、为此付出了什么,再看 DETR 和 YOLO 这两条路线,最后怎么在中间碰头。
一只狗,三个框
检测器从来不只猜一个框。以 YOLO26 为例,640×640 的输入在三种分辨率的特征图上,一共有 8,400 个位置,每个位置都输出一组类别分数和框。YOLO26 文档
训练时,YOLO 系列用的是 one-to-many(一对多) 的标签分配。一个标注物体附近,分数和框都足够好的几个位置,全部当作正样本;YOLO26 的一对多头,每个物体最多取 10 个。YOLO26 论文 §3.2.1 模型被这样教出来,看到一只狗,附近好几个位置都会说「这里有狗」。
所以推理时,同一只狗会冒出好几个框。这时就轮到 NMS(non-maximum suppression,非极大值抑制) 来收拾局面。它先按分数排序,留下最高的框,把和它重叠太多的同类框删掉,再对剩下的框重复同样的步骤。重叠的程度用 IoU 衡量,也就是两个框的交集面积除以并集面积。
我们拿四个框试一次。A、B、C 都框在同一只狗身上,D 框住旁边的猫。A 的分数最高,B 和 A 的 IoU 是 0.904,C 和 A 是 0.656。阈值设为 0.5,B、C 都被删掉,狗和猫各留一个框;阈值放宽到 0.7,C 没被删掉,同一只狗就多了一个框。
反过来看,阈值设得太严也有麻烦。如果 C 框住的其实是紧挨着 A 的第二只狗,0.5 的阈值会把它当成重复框删掉。人群照片最常遇到这种情况。CrowdHuman 数据集平均每张图有 22.6 个人,每张图约有 2.4 对人的框 IoU 超过 0.5,COCO 的人物照片只有 0.02 对。作者也写到,阈值调低,召回率会大跌;阈值调高,误检会变多。CrowdHuman §1
阈值还会同时牵动准确率和耗时。RT-DETR 的作者在 T4 GPU 上测过 YOLOv8,IoU 阈值固定为 0.7,置信度阈值从 0.001 调到 0.05,AP 从 52.9 掉到 51.2,NMS(TensorRT 的 EfficientNMS)本身的耗时则从 2.36 ms 降到 1.06 ms。RT-DETR Table 1 NMS 也是一段需要另外部署的后处理,模型导出到不同的推理平台时,得各自处理。
右半张表固定 IoU 阈值,只改置信度阈值,可以直接看准确率与 NMS 时间如何一起变化。
DETR 让每个物体只对应一个预测
DETR 准备了固定数量的预测槽位(query),标准模型是 100 个。每个槽位输出一个类别和一个框,类别里多了一个「没有物体」。
训练时,DETR 不让好几个槽位同时认领同一个物体。它把预测和标注做一对一(one-to-one)匹配,在所有匹配方式里挑总成本最低的那一种;成本同时看类别分数对不对、框差多远。这个最优匹配用匈牙利算法求得。DETR §3.1
我们用三个槽位、两个物体走一遍。表里是每个槽位配给每个物体的成本,越小越好:
| 槽位 | 狗 | 猫 |
|---|---|---|
| 1(框在狗身上) | 0.2 | 1.5 |
| 2(也框在狗身上) | 0.3 | 1.4 |
| 3(框在猫身上) | 1.6 | 0.4 |
总成本最低的配法,是槽位 1 配狗、槽位 3 配猫,总成本 0.6;槽位 2 没配到,训练目标是「没有物体」。
槽位 2 的框其实不差,只比槽位 1 多一点成本。可是狗已经有人负责了,它拿到的训练目标是「没有物体」。一直这样训练下去,同一个物体上的第二个框会被压下去,推理时也就用不着 NMS。
DETR 的作者还在每一层 decoder 的输出后面接上 NMS 做了检查。第一层加 NMS 有帮助,因为单独一层的预测容易重复;到了后面几层,槽位之间的自注意力已经学会互相避让,NMS 反而会删掉正确的框,让 AP 小幅下降。DETR §4.2、Figure 4
同色实线与虚线,分别是直接输出和加入 NMS 的结果。
只是要和 Faster R-CNN 打到同样的 42.0 AP,DETR 得训练 500 个 epoch;据 Deformable DETR 作者的整理,那是约 2,000 个 GPU 小时,Faster R-CNN 只要 380。Deformable DETR Table 1 小目标也比较吃力,AP_S 是 20.5,Faster R-CNN 是 26.6。DETR Table 1
三百个预测,只有不到三十个在学框
DETR 为什么学得这么慢,后来的论文给出了不同的诊断。Deformable DETR 认为问题在注意力,初始化时注意力平均分散在整张特征图上,要很久才学会聚焦。Deformable DETR §1 DN-DETR 认为问题在匹配不稳定,同一张图、同一个槽位,这一轮匹配到狗,下一轮可能匹配到猫。DN-DETR §1 第三种说法是正样本太少。本文顺着它往下走,因为它和 NMS 直接相关。
H-DETR 的作者指出,Deformable DETR 每张图有 300 个槽位,COCO 将近 99% 的照片标注框少于 30 个,所以每张图只有不到 30 个槽位能匹配到物体,学到框该画在哪里;其余 270 多个槽位,只拿到「没有物体」的分类训练。H-DETR §1
DEIM 的作者把正样本数直接画出来比较。一对一匹配下,每张图的正样本数集中在 10 个以内;改用 YOLO 那种一对多分配,有些照片一张就超过 80 个正样本,极端情况下多了约 10 倍。DEIM §3.2、Figure 3
一对一的推理很干净,每个物体一个框,可是训练时监督太稀疏;一对多的监督很密,推理时却一定要靠 NMS 收拾。接下来六年,两条路线都在想办法两头兼顾。
DETR 这边,训练时把一对多补回来
2022 年的 H-DETR,在原有的 300 个一对一槽位之外,训练时再加一组 1,500 个槽位,把每个标注物体复制 6 份,让这一组用一对多的方式匹配;两组之间用掩码隔开,互不干扰。推理时,只保留原来那 300 个一对一的槽位。H-DETR §3.2
先看最左侧的 Hybrid-Branch:蓝色分支用于训练和推理,绿色分支只用于训练。
H-DETR 的 Table 13 把几种接法放在一起比较。这是 COCO 上分别训练 12、24、36 个 epoch 的 AP,FPS 在 V100 上测量:
| 训练方式 | 推理时用的输出 | 是否接 NMS | AP(12/24/36 ep) | FPS |
|---|---|---|---|---|
| 只用一对多 | 一对多 | 接 | 49.4/50.2/48.8 | 5.3 |
| 混合训练 | 一对多那一组 | 不接 | 13.5/13.1/12.9 | 6.5 |
| 混合训练 | 一对多那一组 | 接 | 48.6/49.8/49.9 | 5.4 |
| 混合训练 | 一对一那一组 | 不接 | 48.7/49.9/50.0 | 6.7 |
第二行是一对多输出不接 NMS 的样子,AP 只剩 13 左右,重复框把成绩整个拖垮。同一个模型,接上 NMS 就回到 49 上下;而一对一那一组什么都不接,成绩差不多,速度最快。只用一对多训练、再接 NMS,在 12 个 epoch 时还高一点,到 36 个 epoch 就被反超了。
其他几条路,做法不同,形态却一样:
- 加练习题。DN-DETR 把加了噪声的标注框当作额外的槽位输入 decoder,让模型还原成原来的框;这份练习在推理时整个拿掉。DN-DETR §4.3 2022 年的 DINO 又加上负样本等几项改进,ResNet-50 的 5-scale 模型 12 个 epoch 就做到 49.4 AP;换上 SwinL 骨干网络、先在 Objects365 上预训练之后,它也成了第一个登上 COCO 排行榜第一名的端到端 Transformer 检测器。DINO 摘要、§1
- 多开几组槽位。Group DETR 训练时同时运行好几组共享权重的槽位,各自做一对一匹配,推理时只保留一组。LW-DETR 用了 13 组,后来的 RF-DETR 也沿用了这个做法。LW-DETR §3.3
- 一张图里放更多物体。2024 年底的 DEIM 不改匹配方式,改数据。它用 Mosaic 把四张照片缩小拼成一张,或用 Mixup 把两张叠成一张,平均每张训练图的物体从约 10 个变成约 25 个,一对一匹配的正样本也跟着变多。这种增强只开到训练进行到一半左右,RT-DETRv2 用 36 个 epoch 做到 53.6 AP,原本要 72 个 epoch 才有 53.4。DEIM §3.2、Table 6、Table 12
这些额外的监督,全部只活在训练阶段。推理时,DETR 还是每个物体一个框,不接 NMS。
RT-DETR 连 NMS 一起计时
训练变快之后,DETR 剩下的问题是推理太慢。2023 年 4 月,百度的 RT-DETR 直接把结论写在标题上,叫《DETRs Beat YOLOs on Real-time Object Detection》。它后来发表在 CVPR 2024。
这篇论文先检查了 YOLO 的速度是怎么测的。作者指出,YOLO 系列报告速度时,通常只算模型本身,不含 NMS 的时间。RT-DETR §3.1 他们于是建立了一套端到端的测法,把 TensorRT 的 NMS 插件接在 YOLO 后面,用验证时的阈值一起计时。在 T4 GPU、TensorRT FP16 下,RT-DETR-R50 做到 53.1 AP、108 FPS;同样的测法下,YOLOv8-L 是 52.9 AP、71 FPS。RT-DETR Table 2
RT-DETR 也没有逃出上一节的规律,它的 decoder 训练时同样带着 200 个去噪槽位。RT-DETR 附录 Table A
YOLO 那边,多接一个一对一的头
一年后,YOLO 这边换了一个方向。2024 年 5 月,清华大学的 YOLOv10 保留原来一对多的输出头,再多接一个一对一的头。训练时两个头一起学;推理时把一对多的头丢掉,只用一对一的头输出,不需要 NMS。YOLOv10 §3.1
左图展示共用骨干和两个输出头,右图比较两个头选到相同候选的频率。
两个头要都学得起来,挑正样本的标准得一致。YOLOv10 让两个头用同一套打分方式选正样本,一对多的头取前几名,一对一的头只取第一名,这样一对多头眼中最好的那个框,也是一对一头的正样本。
它的消融实验把三种做法放在一起比较(以 YOLOv8-S 为基础,延迟含 NMS,T4、TensorRT FP16):
| 训练时的头 | AP | 延迟 |
|---|---|---|
| 只有一对多(推理接 NMS) | 44.9 | 7.07 ms |
| 只有一对一 | 43.4 | 2.44 ms |
| 两个一起训练,推理用一对一 | 44.3 | 2.44 ms |
只训练一对一的头,延迟很漂亮,AP 掉了 1.5。多接一个一对多的头陪练,就补回了大半。会不会只是多算了几轮?作者也想到了,让只有一对一头的 YOLOv10-M 多训练到 550 个 epoch,花的时间和原来差不多,AP 仍然是 48.9 对 51.1。YOLOv10 Table 15 多练几轮补不回来,得靠一对多的监督。
差距也没有完全消失。作者自己写明,小模型上一对一的头还是不如一对多加 NMS,YOLOv10-N 差 1.0 AP,YOLOv10-S 差 0.5;到 YOLOv10-X 才看不出差距。YOLOv10 §4.3、附录 A.9
YOLO26 沿着这条路继续往下走。它在 2025 年 9 月 25 日的 YOLO Vision 2025 上预告,2026 年 1 月 14 日正式发布,论文则在 6 月上传。作者认为 YOLOv10 让两个头从头到尾分到一样的权重,推理时唯一用到的一对一头反而练得不够。YOLO26 改成渐进式的权重,一对多和一对一的损失从 0.8 比 0.2 开始,随着训练线性移到 0.1 比 0.9。YOLO26 论文 §3.3.2、§4.1
连权重的起点都试过了。一开始就把一对一头的权重设成 0,最后成绩和固定各占一半差不多;表现最好的是默认的安排,从 0.8 比 0.2 起步,再慢慢把重心移到一对一头。YOLO26 论文 Table 5 DEIM 也在训练到一半时关掉多出来的正样本,两边都是先密后疏。
测速度的时候,NMS 算不算?
拿掉 NMS 最直接的好处是快,但「快多少」很难测得一致。同一个 YOLOv8-N,在 YOLOv10 的测法下总延迟是 6.16 ms,其中模型本身只占 1.77 ms,剩下的大多是 NMS;YOLOv10 用的是验证时的阈值,置信度阈值低,留下的候选框多。YOLOv10 Table 1 到了 RF-DETR 的测法,置信度阈值调到 0.01,同一个模型的总延迟是 2.1 ms。RF-DETR Table 2
Roboflow 在 2025 年 3 月发布 RF-DETR 时,在发布文章里写道,大多数 YOLO 的评测用 NMS 来算准确率,报告速度时却没有把 NMS 算进去。Roboflow,2025-03-20 后来的 RF-DETR 论文又多列了两项,GPU 连续推理时会降频,还有人用 FP16 的模型测延迟、用 FP32 的模型测准确率;作者主张用同一个模型文件同时测两者。RF-DETR §4 RF-DETR 以 DINOv2 为骨干网络,2XL 版本在 T4 上 17.2 ms、60.1 AP,作者说这是第一个在 COCO 上超过 60 AP 的实时检测器。论文后来发表在 ICLR 2026。
读这些比较时,也要记得各家的立场。Roboflow 和 Ultralytics 是直接的竞争对手。YOLO26 论文在 Hacker News 上讨论时,一位自称 Roboflow 联合创始人的用户就质疑,论文在主图上宣称准确率与延迟的权衡最好,比较对象却没有新的 DETR。Hacker News,2026-06-23 主图 Figure 1 比的是 YOLO 各代、PP-YOLOE+、DAMO-YOLO 和 RTMDet;DETR 系列只放在附录的 Table S8,里面也没有 RF-DETR。反过来看,Roboflow 在 2026 年 1 月比较 RF-DETR 和 YOLO26 的文章,引用的 YOLO26 数字是官方表格上的 53.1 AP、4.7 ms;根据 Ultralytics 文档的脚注,这组准确率来自一对多加 NMS,延迟却是用不接 NMS 的一对一头测的。YOLO26 文档、Roboflow,2026-01-15
Ultralytics 自己的端到端指南也建议,比较准确率和延迟时,要用同一个输出头、同样的图像尺寸、精度和硬件。Ultralytics 端到端检测指南
NMS 为什么又回来了
回到开头那次默认值的改动。YOLO26 的一对一头,在五种模型尺寸上都比一对多加 NMS 少 0.6 到 0.8 AP。YOLO26 论文 §4.4 论文当时就写了,如果目标平台跑得动 NMS、又最在意准确率,仍然可以优先考虑一对多的头。到了 8.4.142,Ultralytics 干脆把它设成默认。
部署也是原因之一。根据 Ultralytics 的指南,NCNN、RKNN、Edge TPU、Qualcomm QNN 等平台,如果算子撑不起端到端的输出,就会退回一对多的头;部分 INT8 的 TensorRT 配置也一样。Ultralytics 端到端检测指南
重复框也没有完全消失。DINO 的作者就承认,靠匹配损失和自注意力压掉重复框,这种能力有限。DINO §3.3 用户报告的问题也一直都有。2024 年 6 月,有人用自己的数据微调 YOLOv10-M,训练了一两千个 epoch 仍有几乎重叠的重复框,最后加回 NMS 才解决。THU-MIG/yolov10 #236 2026 年 7 月,Ultralytics 的协作者在回复 YOLO26 的类似报告时说,YOLO26n 偶尔会输出重复框,需要的话可以接 NMS,「框不多,应该很快」。ultralytics #25304 RF-DETR 的第一作者也给过同样的建议,同时补了一句,数据足够多时模型应该能自己学会。rf-detr #187
拥挤的场景里,一对一的检测器能输出几个框,取决于有几个槽位。在 CrowdHuman 上,只有 100 个槽位的 DETR 是 75.9 AP,比用 NMS 的 FPN 检测器(85.8)低很多;换成 1,000 个槽位的 Deformable DETR,就做到 91.5。Iter-E2EDET Table 2 物体一多,先看槽位够不够。
NMS 还在,只是位置变了。它从推理时一定要做的步骤,变成一个可以开、也可以关的选项。
回到你自己的检测器
最后整理一下这六年:
- 一个物体只配一个预测,训练时很贵。一对一匹配让推理不需要 NMS,代价是正样本太少、收敛太慢。
- 两条路线都在训练时多给正样本。DETR 这边加一对多的分支、去噪的练习或多组槽位;YOLO 这边保留一对多的头陪练,推理改用一对一的头。
- NMS 变成选项。一对一的头省掉后处理;一对多加 NMS 仍然多出零点几 AP,也更容易部署到各种平台。
如果你正在挑检测器,可以先把三件事弄清楚。比较速度时,先确认 NMS 有没有算进去、用的是哪个阈值;照片里的物体很多或很挤时,先看槽位上限,必要时保留 NMS;要部署到手机或边缘设备,先确认那个平台跑不跑得动一对一的输出。
DETR 当年押下的赌注,到现在还在继续。
那,如果是站在一线工程师的角度来看,NMS 能删吗?
反正我们是不敢。