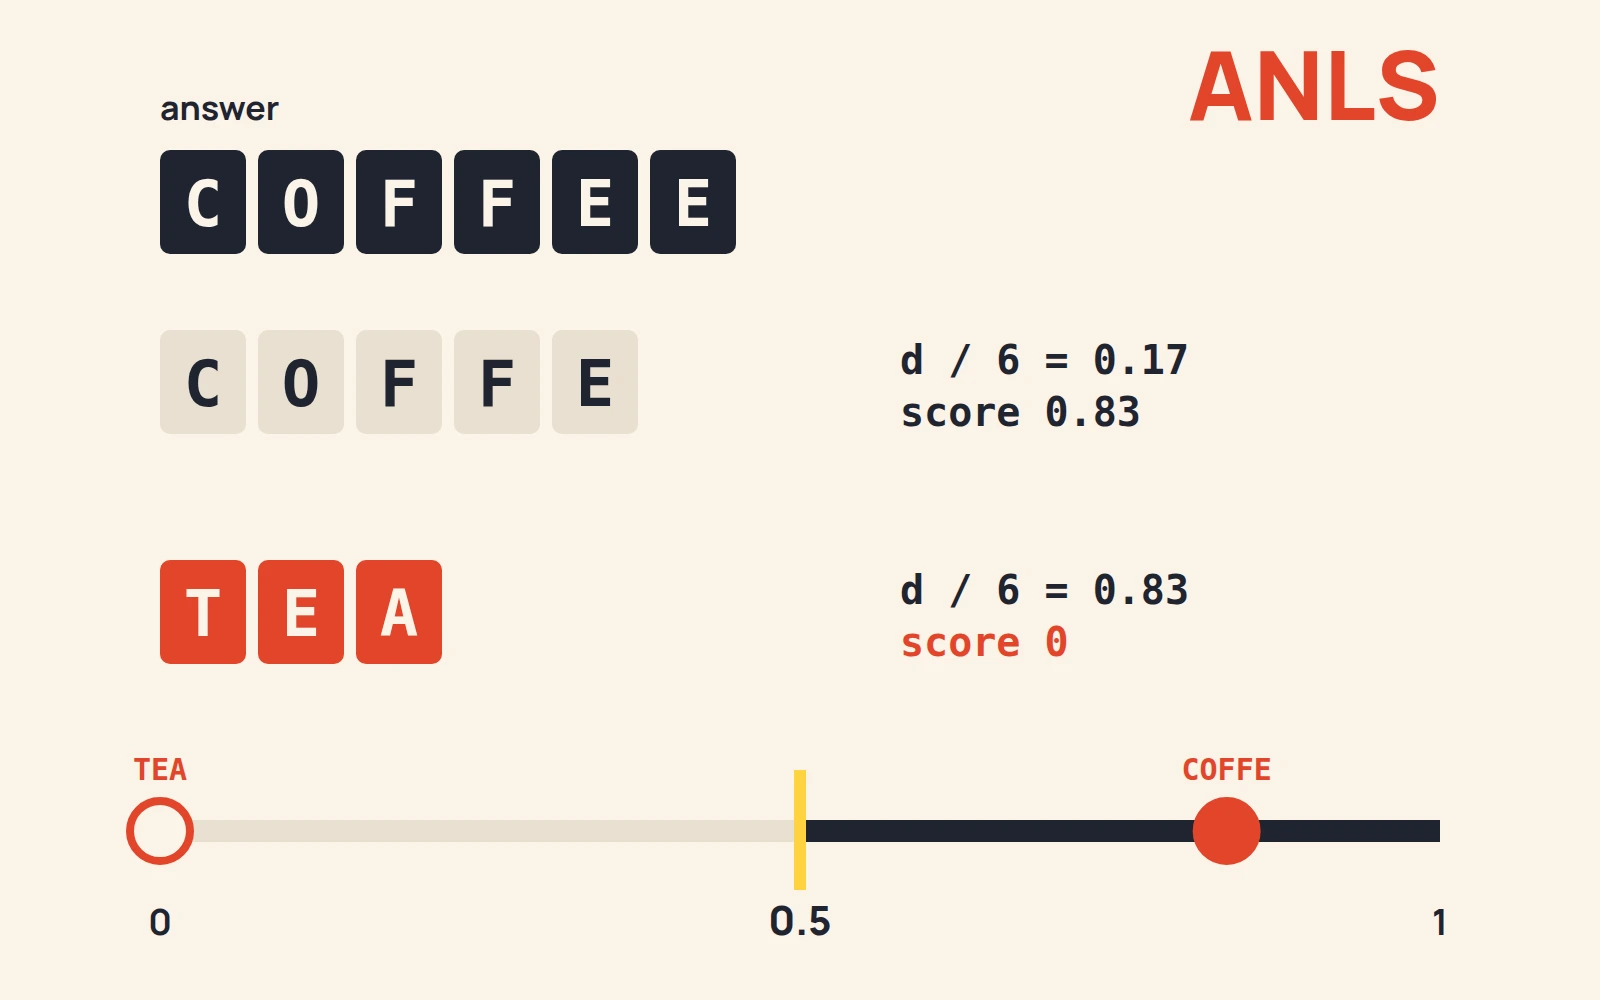
Average Normalized Levenshtein Similarity(ANLS)は、予測文字列と正解の近さを編集距離で測ります。Levenshtein 距離を 2 つの文字列のうち長い方の文字数で割り、正規化した距離を類似度に変換します。
ST-VQA の原論文では 0.5 の閾値を使います。正規化距離が 0.5 を超えると 0 点、それ以外は 1 - 距離 で採点し、複数のサンプルの平均を取ります。閾値を省くと平均 NLS になり、ANLS と異なる値になり得ます。以下のコードは一対の文字列を採点します。1 問に複数の許容解答があるデータセットでは、解答の選択規則も適用する必要があります。
参考資料
必要なライブラリの導入
まず、必要なライブラリをインポートします。特に、torchmetrics の EditDistance を使用します:
from typing import Any, Literal, Optional, Sequence, Union

import torch
from torch import Tensor
from torchmetrics.metric import Metric
from torchmetrics.text import EditDistance
from torchmetrics.utilities.data import dim_zero_cat
EditDistance は文字列ペアごとの編集距離を返します。長い方の文字数で正規化してから、ANLS の閾値を適用します。
標準化機能の実装
ここでは、torchmetrics.metric.Metric のインターフェースを継承します。そのため、update メソッドと compute メソッドを実装する必要があります:
class NormalizedLevenshteinSimilarity(Metric):

    def __init__(
        self,
        substitution_cost: int = 1,
        reduction: Optional[Literal["mean", "sum", "none"]] = "mean",
        **kwargs: Any
    ) -> None:
        super().__init__(**kwargs)
        self.edit_distance = EditDistance(
            substitution_cost=substitution_cost,
            reduction=None  # すべての文字列ペアに対する距離を取得する設定
        )

        # ...
いくつかのポイントがあります:
- 入力された
predsとtargetが文字列のリストであることを確認します。そうしないと、関数が「文字」単位で計算を行う可能性があります。 - 各文字列の最大長を計算して、標準化に使用します。
def update(self, preds: Union[str, Sequence[str]], target: Union[str, Sequence[str]]) -> None:
    """予測値とターゲットで状態を更新します。"""

    if isinstance(preds, str):
        preds = [preds]
    if isinstance(target, str):
        target = [target]
    if len(preds) != len(target):
        raise ValueError("preds and target must have the same length")

    distances = self.edit_distance(preds, target)
    max_lengths = torch.tensor([
        max(len(p), len(t))
        for p, t in zip(preds, target)
    ], dtype=torch.float, device=distances.device)

    ratio = torch.where(
        max_lengths == 0,
        torch.zeros_like(distances).float(),
        distances.float() / max_lengths
    )

    nls_values = torch.where(
        ratio <= 0.5,
        1 - ratio,
        torch.zeros_like(ratio),
    )

    # ...
reduction パラメータの実装
reduction パラメータを柔軟に活用できるようにする必要があります。例えば、mean を指定した場合、それは一般的な ANLS スコアを意味します。
また、通常の mean 以外にも、sum や none を使用して、異なるニーズを満たすことができます。
def _compute(
    self,
    nls_score: Tensor,
    num_elements: Union[Tensor, int],
) -> Tensor:
    """状態に基づいて ANLS を計算します。"""
    if nls_score.numel() == 0 or num_elements == 0:
        return torch.tensor(0, dtype=torch.int32)
    if self.reduction == "mean":
        return nls_score.sum() / num_elements
    if self.reduction == "sum":
        return nls_score.sum()
    if self.reduction is None or self.reduction == "none":
        return nls_score

def compute(self) -> torch.Tensor:
    """状態に基づいて NLS を計算します。"""
    if self.reduction == "none" or self.reduction is None:
        return self._compute(dim_zero_cat(self.nls_values_list), 1)
    return self._compute(self.nls_score, self.num_elements)
reduction="none" では、平均ではなく各ペアの閾値適用後のスコアを返します。dim_zero_cat は保存された値をテンソルにまとめます。
完全な実装
以下は完全な実装コードです:
from typing import Any, Literal, Optional, Sequence, Union

import torch
from torch import Tensor
from torchmetrics.metric import Metric
from torchmetrics.text import EditDistance
from torchmetrics.utilities.data import dim_zero_cat

class NormalizedLevenshteinSimilarity(Metric):
    """
    Normalized Levenshtein Similarity (NLS) は、2つのシーケンス間の正規化された
    Levenshtein 類似度を計算する指標です。
    この指標は次のように計算されます:
        1 - (levenshtein_distance / max_length)
    ここで、`levenshtein_distance` は2つのシーケンス間の Levenshtein 距離を表し、
    `max_length` は2つのシーケンスのうちの最大長です。

    NLS は文字列の類似性を測定するために設計されており、特にテキスト類似性分析、
    光学式文字認識(OCR)、自然言語処理(NLP)などの分野で有用です。

    ``update`` および ``compute`` メソッドの入力形式は以下の通りです:

    - ``preds`` (:class:`~Union[str, Sequence[str]]`):
        予測されたテキストシーケンスまたはそのコレクション。
    - ``target`` (:class:`~Union[str, Sequence[str]]`):
        ターゲットとなるテキストシーケンスまたはそのコレクション。

    ``compute`` メソッドの出力形式:

    - ``nls`` (:class:`~torch.Tensor`): NLS 値を含むテンソル。
        サンプルがない場合は 0.0 を返し、サンプルがある場合は NLS を返します。

    Args:
        substitution_cost:
            1文字の置換にかかるコスト。デフォルトは1です。
        reduction:
            メトリックスコアを集約する方法。
            デフォルトは 'mean' で、選択肢は 'sum' または None。

            - ``'mean'``: サンプル全体の平均(ANLS)を取る。
            - ``'sum'``: サンプル全体の合計を取る。
            - ``None`` または ``'none'``: サンプルごとのスコアを返す。

        kwargs: その他のキーワード引数。

    Example::
        複数の文字列を扱う例:

        >>> metric = NormalizedLevenshteinSimilarity(reduction=None)
        >>> preds = ["rain", "lnaguaeg"]
        >>> target = ["shine", "language"]
        >>> metric(preds, target)
        tensor([0.0000, 0.5000])
        >>> metric = NormalizedLevenshteinSimilarity(reduction="mean")
        >>> metric(preds, target)
        tensor(0.2500)
    """

    def __init__(
        self,
        substitution_cost: int = 1,
        reduction: Optional[Literal["mean", "sum", "none"]] = "mean",
        **kwargs: Any
    ) -> None:
        super().__init__(**kwargs)
        self.edit_distance = EditDistance(
            substitution_cost=substitution_cost,
            reduction=None  # 全ての文字列ペアの距離を取得する設定
        )

        allowed_reduction = (None, "mean", "sum", "none")
        if reduction not in allowed_reduction:
            raise ValueError(
                f"Expected argument `reduction` to be one of {allowed_reduction}, but got {reduction}")
        self.reduction = reduction

        if self.reduction == "none" or self.reduction is None:
            self.add_state(
                "nls_values_list",
                default=[],
                dist_reduce_fx="cat"
            )
        else:
            self.add_state(
                "nls_score",
                default=torch.tensor(0.0),
                dist_reduce_fx="sum"
            )
            self.add_state(
                "num_elements",
                default=torch.tensor(0),
                dist_reduce_fx="sum"
            )

    def update(self, preds: Union[str, Sequence[str]], target: Union[str, Sequence[str]]) -> None:
        """予測値とターゲットで状態を更新します。"""
        if isinstance(preds, str):
            preds = [preds]
        if isinstance(target, str):
            target = [target]
        if len(preds) != len(target):
            raise ValueError("preds and target must have the same length")

        distances = self.edit_distance(preds, target)
        max_lengths = torch.tensor([
            max(len(p), len(t))
            for p, t in zip(preds, target)
        ], dtype=torch.float, device=distances.device)

        ratio = torch.where(
            max_lengths == 0,
            torch.zeros_like(distances).float(),
            distances.float() / max_lengths
        )

        nls_values = torch.where(
        ratio <= 0.5,
        1 - ratio,
        torch.zeros_like(ratio),
    )

        if self.reduction == "none" or self.reduction is None:
            self.nls_values_list.append(nls_values)
        else:
            self.nls_score += nls_values.sum()
            self.num_elements += nls_values.shape[0]

    def _compute(
        self,
        nls_score: Tensor,
        num_elements: Union[Tensor, int],
    ) -> Tensor:
        """状態に基づいて ANLS を計算します。"""
        if nls_score.numel() == 0 or num_elements == 0:
            return torch.tensor(0, dtype=torch.int32)
        if self.reduction == "mean":
            return nls_score.sum() / num_elements
        if self.reduction == "sum":
            return nls_score.sum()
        if self.reduction is None or self.reduction == "none":
            return nls_score

    def compute(self) -> torch.Tensor:
        """状態に基づいて NLS を計算します。"""
        if self.reduction == "none" or self.reduction is None:
            return self._compute(dim_zero_cat(self.nls_values_list), 1)
        return self._compute(self.nls_score, self.num_elements)

if __name__ == "__main__":
    anls = NormalizedLevenshteinSimilarity(reduction='mean')
    preds = ["rain", "lnaguaeg"]
    target = ["shine", "language"]
    print(anls(preds, target))
補足
この例は各予測に正解を一つ対応させます。特定のデータセットの公式スコアに合わせるには、大文字小文字と空白の正規化、複数解答の選択、空文字列の扱いも確認してください。