SNS が知り合いかもしれない人を薦めたり、通販サイトが気に入りそうな商品を薦めたりするとき、その背後にはよく同じ直感があります。類は友を呼ぶ。友達の好きなものは、自分も好きなことが多い。
グラフ畳み込みネットワーク(Graph Convolutional Network、GCN)は、この直感を数学にしたものです。
この記事はゼロから始めます。グラフ理論の知識は要りません。四則演算ができれば十分で、行列の掛け算は使うときに説明します。読み終える頃には GCN の一層を自分の手で計算し、たった二つの既知の答えから小さなモデルがほかの人の答えを予測する様子も見られます。触って試せる図を三つ用意しました。クリックしたりスライダーを動かしたりすると、数式を読むだけよりずっと早くつかめます。
まずは一つの問題から
六人がいます。Alice、Bob、Carol は互いに友達で、Dave、Eve、Frank も同じです。Carol と Dave も知り合いで、二つの集団をつなぐ唯一の関係です。
分かっていることは二つだけ。Alice は球技が好きで、Frank は好きではありません。
ほかの四人はどうでしょう?
こんなふうに推測できそうです。Bob の友達は Alice と Carol。Alice は球技が好きなので、Bob も好きかもしれません。Eve の友達は Dave と Frank。Frank は好きではないので、Eve もあまり好きではなさそうです。
「友達を見て予測する」が、グラフ畳み込みの出発点です。この予測の仕方を、少しずつコンピューターで計算できる形にしていきましょう。
グラフ:点と線
まず言葉を一つ整理します。ここで扱うグラフは、英語の graph、つまり点と線で表した関係です。構成要素は二つだけです。
- ノード(node):記述したい対象。ここでは六人の人です。
- エッジ(edge):対象の間の関係。ここでは友人関係です。
各ノードには、自分を説明する数値も持たせられます。これを特徴量(feature)と呼びます。ここでは一人につき一つ、「球技が好きな度合い」だけです。Alice は 1、Frank は 0。ほかの四人は分からないので、ひとまず半々の 0.5 を入れます。
コンピューターには線が見えないので、友人関係を表にします。これが隣接行列(adjacency matrix)です。
六人なら 6×6 の表になり、 と書きます。第 行、第 列の は、 番目の人と 番目の人が友達だということ。友達でなければ 0 を入れます。
Carol の行を見ると、Alice、Bob、Dave の三つのマスが 1 です。友達が三人いるわけです。一つの行にある 1 の数がその人の友達の数で、次数(degree)と呼びます。
友人関係は双方向なので となり、表全体は対角線を軸に対称になります。
いちばん素直な方法:友達に聞く
いちばん簡単なのは、各人の数値を友達の平均に置き換える方法です。
Bob の友達は Alice(1)と Carol(0.5)なので、平均は 0.75。球技が好きそうです。Eve の友達は Dave(0.5)と Frank(0)で、平均は 0.25。あまり好きではなさそうです。
行列を使えば全員分を一度に計算できます。まず隣接行列の各行をその人の友達の数で割ると、友達一人ひとりの取り分が決まります。それに各人が球技を好きな度合い(Alice は 1、Frank は 0、わからない人はひとまず 0.5)を掛けます。結果の 番目の数値は、第 行の各取り分に対応する数値を掛けて足し合わせたもの、つまり 番目の人の友達全員の平均です。六人の値は順に 0.5、0.75、0.67、0.33、0.25、0.5 です。
Bob は 0.75、Eve は 0.25 で、直感どおりです。では Alice と Frank はどうでしょう。
この二人だけは答えが分かっていたのに、計算するとどちらも 0.5 になってしまいました。友達にだけ聞くと、自分が知っていたことを捨ててしまうのです。
二つの修正
自分にも一票
直し方は単純です。平均を取るとき、自分も加えます。隣接行列の対角線に 1 を足すと、全員に「自分」という友達が一人増えます。これを自己ループ(self-loop)と呼び、 と書きます。 は対角成分が 1、ほかが 0 の単位行列です。
これで Alice の新しい数値は となり、自分の答えをかなり残せます。
友達が多い人の一票は少し軽く
単純な平均では、友達全員の取り分が同じです。GCN はもう一歩進めて、二人それぞれの友達の数で取り分を調整します。 番目の人が 番目の人から受け取る取り分は、次のとおりです。
は自己ループを加えたあとの次数、つまり友達の数に 1 を足したものです。
Bob を見てみましょう。Bob の は 3 です。Alice()からは 、Carol()からは を受け取ります。Carol は知り合いが多く、その声を多くの人に分けるので、Bob に届く分は少し軽くなります。
この取り分も対称です。Bob が Carol から受け取る量と、Carol が Bob から受け取る量は同じです。行列で書くと、GCN 論文の になります。左右でそれぞれ次数の平方根で割っています。自己ループを加えると、六人の次数は順に 3、3、4、4、3、3 で、 で計算し直した新しい数値は 0.64、0.64、0.68、0.39、0.31、0.31 です。
左側の三人は全員 0.5 を超え、右側の三人は全員 0.5 未満。Alice も引き続き球技が好きな側です。取り分の合計は必ずしもぴったり 1 にはならず、Carol の行は 1.08 ですが、近い値です。
なぜ単純な平均ではいけないのでしょう? どちらの方法も使われています。GCN がこの対称な形を選んだ理由の一つは、スペクトル領域の導出を簡略化してたどり着いた形だからです。もう一つは、多くの層を重ねても値が安定し、掛けるたびに大きくなっていかないことです。
下の図では、好きな人をクリックして、誰からどれだけ受け取るかを見られます。三つの計算方法を切り替え、特に「友人だけ」のときの Alice に注目してください。
Bob の新しい数字GCN の重み
- Alice1.00 × 0.330.33
- 自分0.50 × 0.330.17
- Carol0.50 × 0.290.14
合計0.64
これが GCN の一層
ここまでの処理を一行にすると、GCN 論文の式になります。
三つの部分が、それぞれ一つの仕事をしています。
- :各人が友達と自分について、先ほどの取り分で加重平均を取ります。 は全員の特徴量で、一人が一行です。最初の層の は元の特徴量で、 と書きます。
- を掛ける:一人の特徴量は、一つとは限りません。 はこれらを組み合わせ直し、新しい表現に変えます。新しい特徴量はそれぞれ、元の特徴量の加重和です。 はモデルが学習するパラメーターで、全員が同じ を使います。
- :非線形関数です。GCN は ReLU を使い、負の値を 0 にして、正の値はそのまま残します。
全員にもう一つ、「読書が好きな度合い」という特徴量を持たせましょう。Alice は 0、Frank は 1、ほかの人は引き続き 0.5 です。まずは をこちらで指定し、新しい特徴量の一つ目を「球技から読書を引いたもの」、二つ目を「読書から球技を引いたもの」にします。GCN を一層通すと、Alice、Bob、Carol の新しい特徴量は [0.33, 0]、[0.33, 0]、[0.29, 0]、Dave、Eve、Frank は [0, 0.29]、[0, 0.33]、[0, 0.33] になります。
左側の三人は一つ目の新しい特徴量が正、右側の三人は二つ目が正です。GCN 一層で、二つの集団はすでに異なる特徴量で分かれました。
実際の訓練では、 はデータから学びます。この点は、あとで見てみましょう。
なぜ「畳み込み」と呼ぶのか
画像を扱う畳み込みニューラルネットワーク(CNN)を学んだことがあれば、今の処理に見覚えがあるかもしれません。
画像の畳み込みでは、各画素の新しい値を、自分と周囲 8 画素の加重和にし、同じ重みを画像全体に滑らせます。グラフ畳み込みも、各ノードの新しい値を自分と隣接ノードの加重和にし、全ノードで同じ を共有します。同じ種類の処理なので、グラフの「畳み込み」と呼びます。
違うのは隣接関係です。画素の隣は必ず 8 個で、左上、真上、右上には決まった位置があり、位置ごとに重みがあります。グラフでは隣接ノードの数が一定せず、上下左右もないので、GCN の取り分は次数だけで決まります。この違いから、のちの多くの研究が生まれました。〈グラフ畳み込み大観園〉の最初の立ち寄り先も、ここから始まります。
二層重ねて、もっと遠くへ
GCN 一層では、各人に友達の声だけが届きます。一層目の結果を二層目に入れれば、友達の友達の声も届きます。
Alice の情報は一層で Bob と Carol に伝わり、二層で橋を越えて Dave に、三層目でようやく Eve と Frank に届きます。 層重ねると、 ステップ以内の人が見えるのです。
下のスライダーを動かしてみてください。
最初は Alice と Frank だけが答えを持っています。
Alice の情報が届いた人数0 / 5
点線の輪で囲まれた人に情報が届いています。
最初の最大値と最小値の差は 1.00。一層重ねると二つの集団が分かれ、差は 0.37 になります。8 層まで重ねると 0.18 しか残りません。層を重ねるほど全員の値が近づき、やがて集団を区別できなくなります。これが over-smoothing です。GCN 論文の主な実験は二層だけを使い、付録でさらに深いモデルを試していますが、最良の結果はどれも二〜三層でした。
モデル自身に学ばせる
ここまでは、数値も もこちらで与えていました。本当の GCN は自分で学びます。
問題をもう少し純粋にしましょう。モデルには誰が球技を好きか、一切教えません。各人の特徴量は「自分が誰か」だけ。手がかりは友人関係と、Alice は球技が好き、Frank は好きではないという二つの答えだけです。
モデルはまず でグラフ上を二回平滑化し、そのあとに線形分類器をつなぎます。softmax で二つのクラスのスコアを合計 1 の確率に変え、各人が球技を好きな確率を出します。訓練の誤差は Alice と Frank の答えだけで計算し、勾配降下で分類器の重みを少しずつ調整します。グラフを使うと、Bob、Carol は球技が好き(0.98、0.92)、Dave、Eve は好きではない(0.08、0.02)と予測され、四人とも正解です。グラフを使わないと、この四人についてモデルが知っていることは何もなく、0.5 のままです。
答えは二つだけで、残りはすべて友人関係から推測しました。これが GCN のもっとも一般的な使い方、半教師ありノード分類です。GCN 論文も、Cora の論文引用ネットワークで同じことをしています。2,708 篇のうち 140 篇だけにクラスを与え、二層の GCN がほかの論文のクラスを当てた精度は 81.5% でした。
下では訓練の過程を一歩ずつ見たり、「グラフなし」に切り替えて比べたりできます。
答えを与えていない 4 人のうち、0 人が正しい側にいます。
Transformer との違い
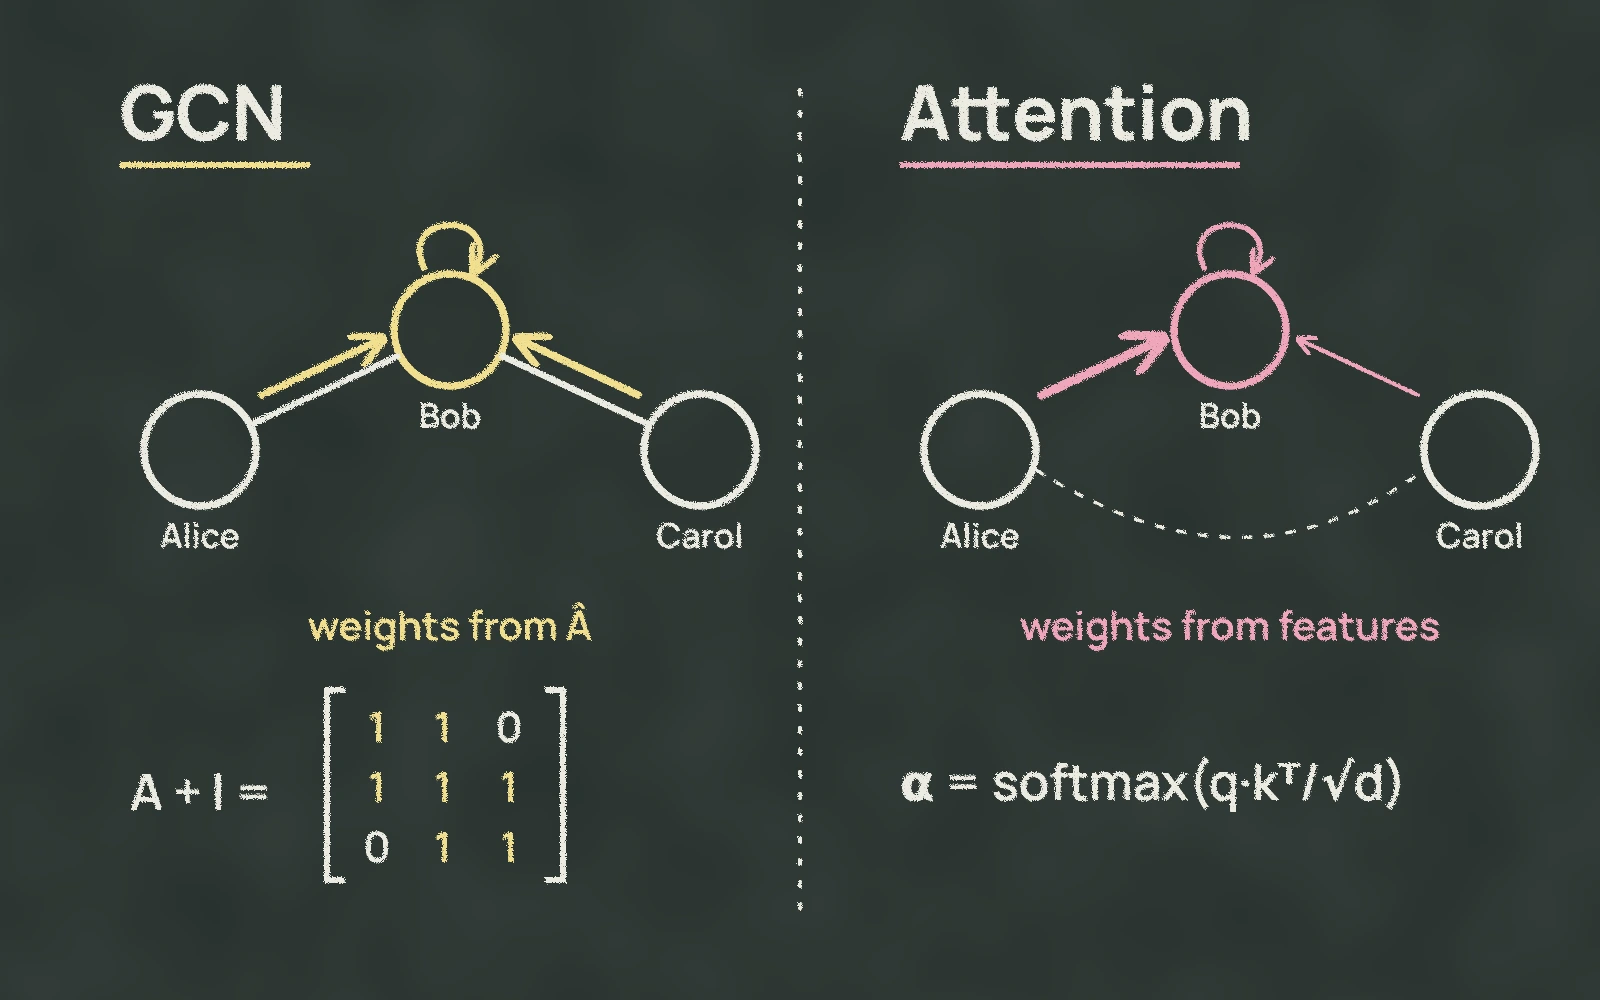
Transformer を知っていれば、「各人がほかの人の加重平均を取る」という処理は、注意機構に似ていると感じるでしょう。確かに似ています。違いは二つです。
一つ目は、誰に取り分があるか。GCN は友達の間だけで配り、グラフでつながっていない二人の取り分は 0 です。Transformer の注意では、全員が全員を見ます。
二つ目は、取り分の決め方。GCN は次数だけで決まり、先に計算できます。注意は二人の特徴量がどれほど近いかを見て、入力のたびに計算し直します。
この二つの道は、のちに少しずつ合流していきます。GCN も特徴量で取り分を決めるようにしたり、Transformer にもグラフの構造を見せたりする研究が生まれました。
最後に整理
- グラフはノードとエッジからなり、隣接行列に誰と誰がつながっているかを記録します。
- GCN の一層は、両側の次数で決まる取り分で友達と自分の加重平均を取り、 を掛けて ReLU を通します。
- 層重ねると ステップ以内の人が見えます。重ねすぎると、全員が似てきます。
- 少数の答えだけでも、友人関係を使って GCN はほかの人を予測できます。
この一行の式が、そのあとどう改良されたかを知りたければ、〈グラフ畳み込み大観園〉を読んでみてください。あちらも最初から最後まで同じ六人の友人関係を使い、名前だけ A から F に縮めています。
これから論文で を見かけたら、Bob が Carol から 0.29 を受け取ったあの式だと思い出してください。