Toutes les notes
344 notesIllustration de l’articleArticle originalarXiv 2026Évaluation des modèles
Sûr à 90 %, vraiment ?
Note publiée le
Illustration de l’articleArticle originalarXiv 2026Génération augmentée par recherche
Le jeu du téléphone
Note publiée le
Illustration de l’articleArticle originalarXiv 2026Génération augmentée par recherche
Rendons sa grandeur à BM25
Note publiée le
Illustration de l’articleArticle originalBonnes lettres, mauvaise personne
Note publiée le
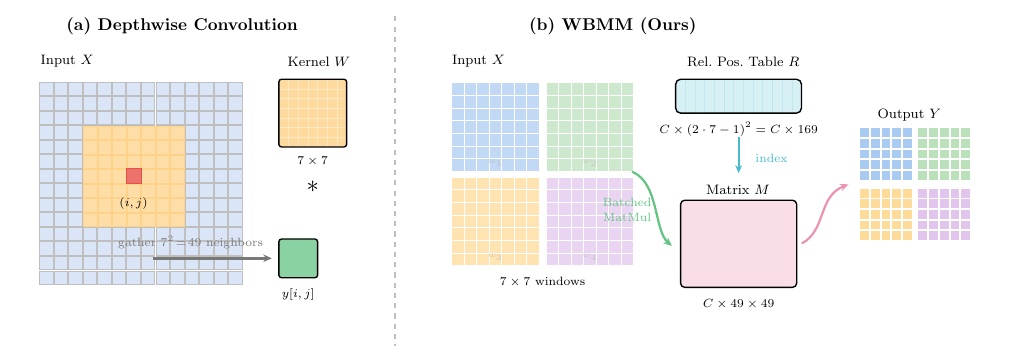
Illustration de l’articleArticle originalarXiv 2026ICML 2026CNN classiques
Plus la fenêtre grandit, plus ça accélère
Note publiée le
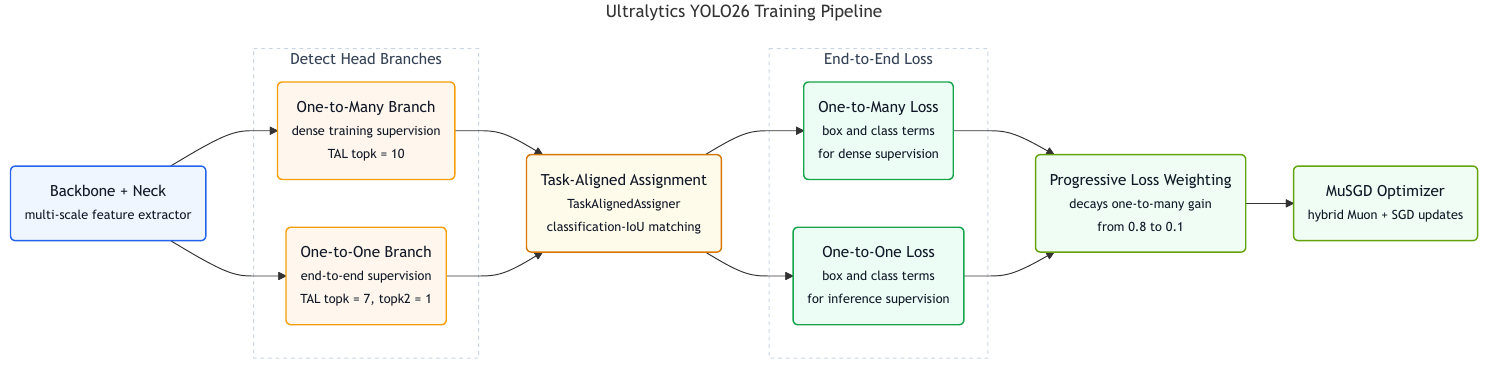
Illustration de l’articleArticle originalarXiv 2026Détection d’objets
On garde les deux têtes
Note publiée le
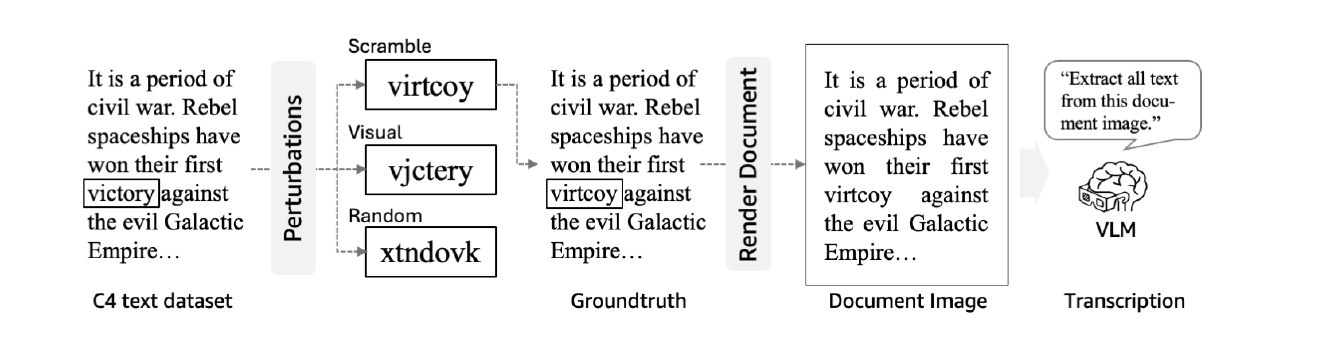
Illustration de l’articleArticle originalarXiv 2026Findings of EMNLP 2026Évaluation des modèles
Un correcteur trop zélé
Note publiée le
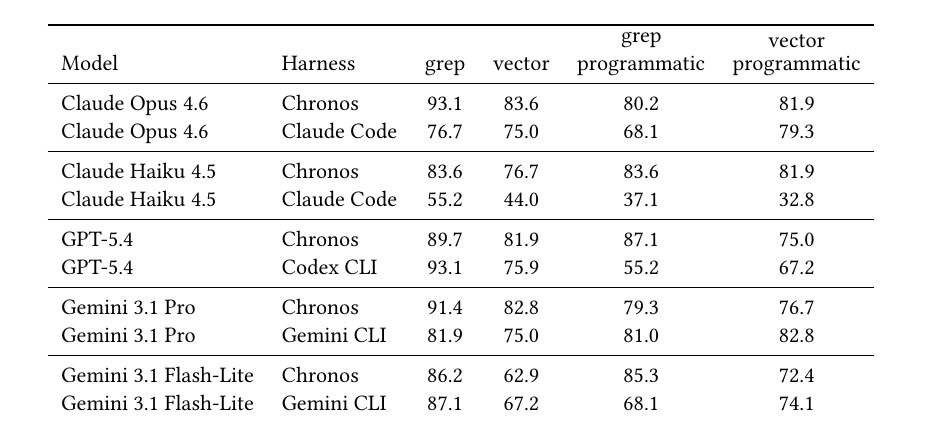
Illustration de l’articleArticle originalarXiv 2026Génération augmentée par recherche
Grep suffit-il ?
Note publiée le
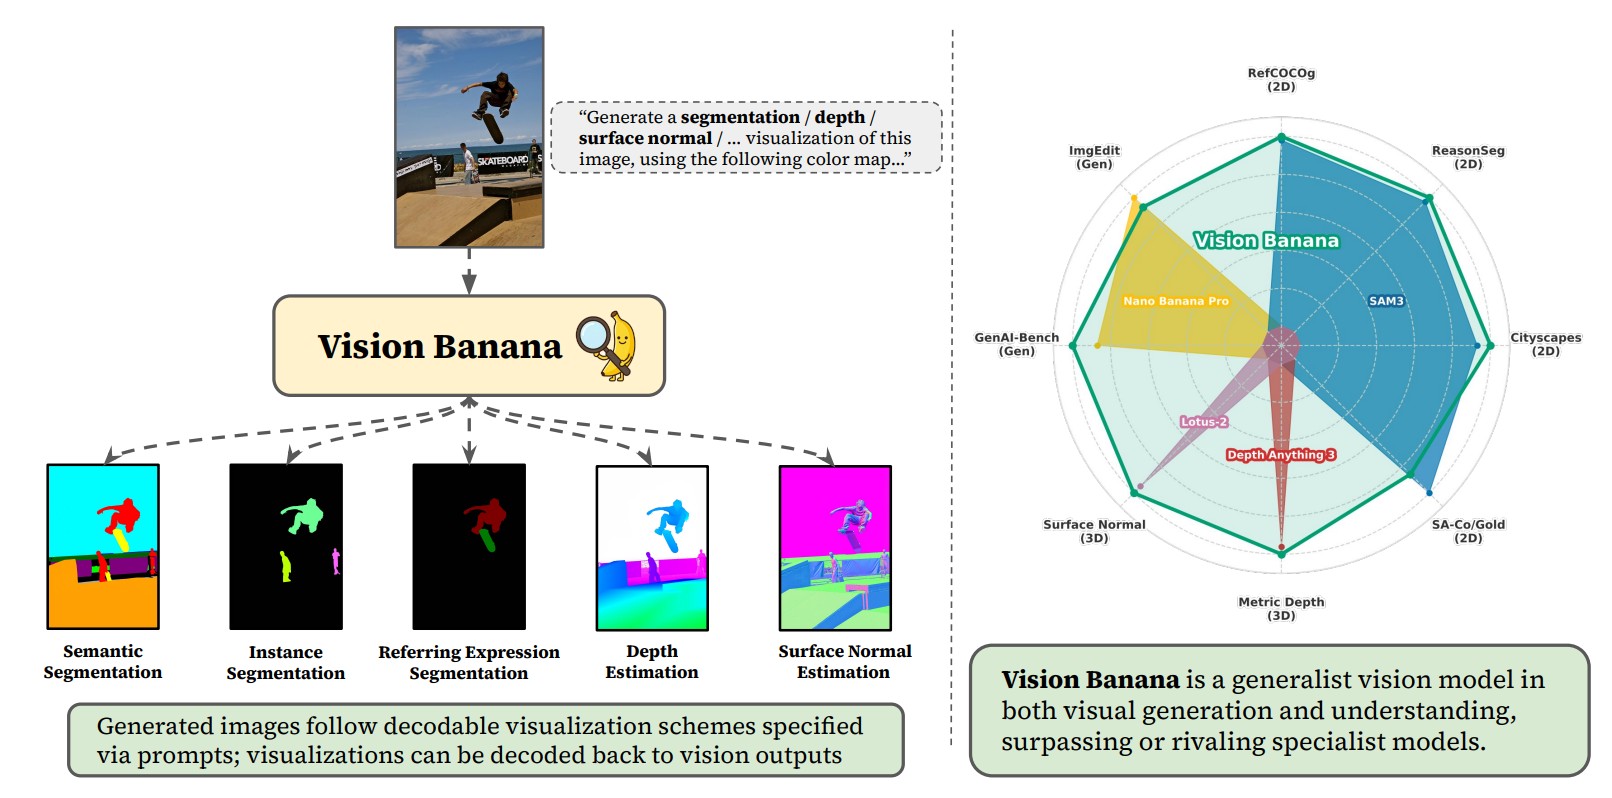
Illustration de l’articleArticle originalarXiv 2026Génération d’images
S'il sait générer des images, il sait sûrement les regarder
Note publiée le
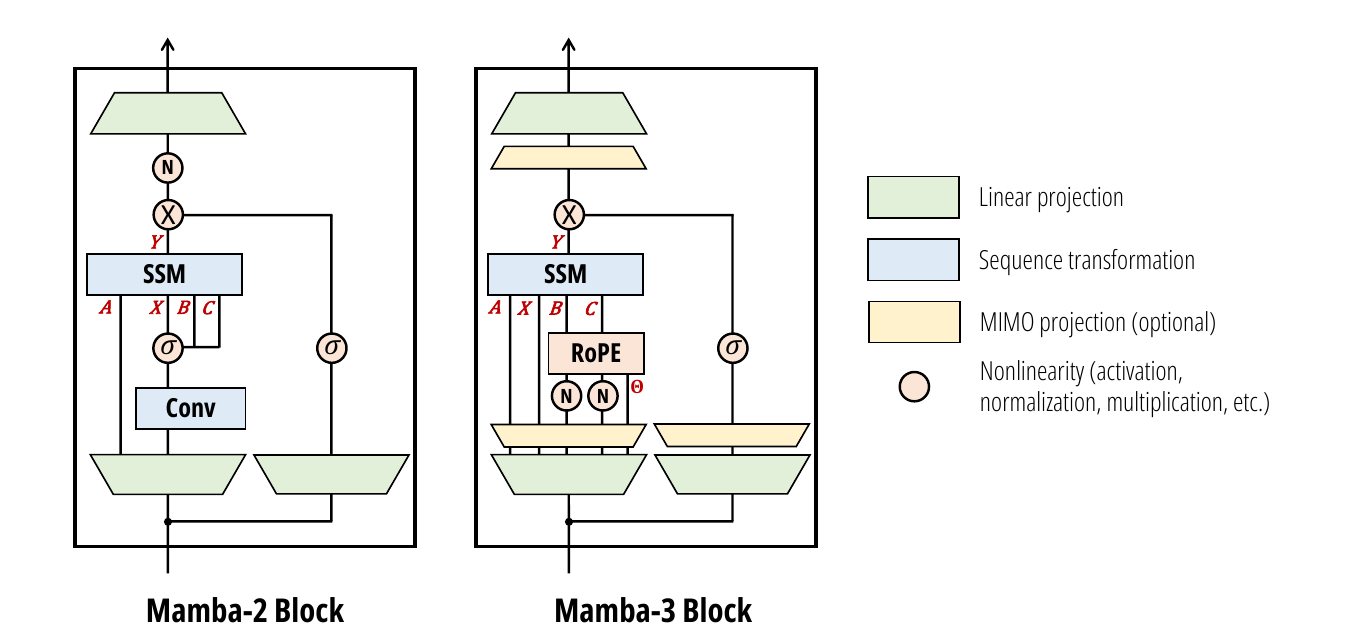
Illustration de l’articleArticle originalarXiv 2026ICLR 2026Modèles d’espace d’état
L'inférence d'abord
Note publiée le
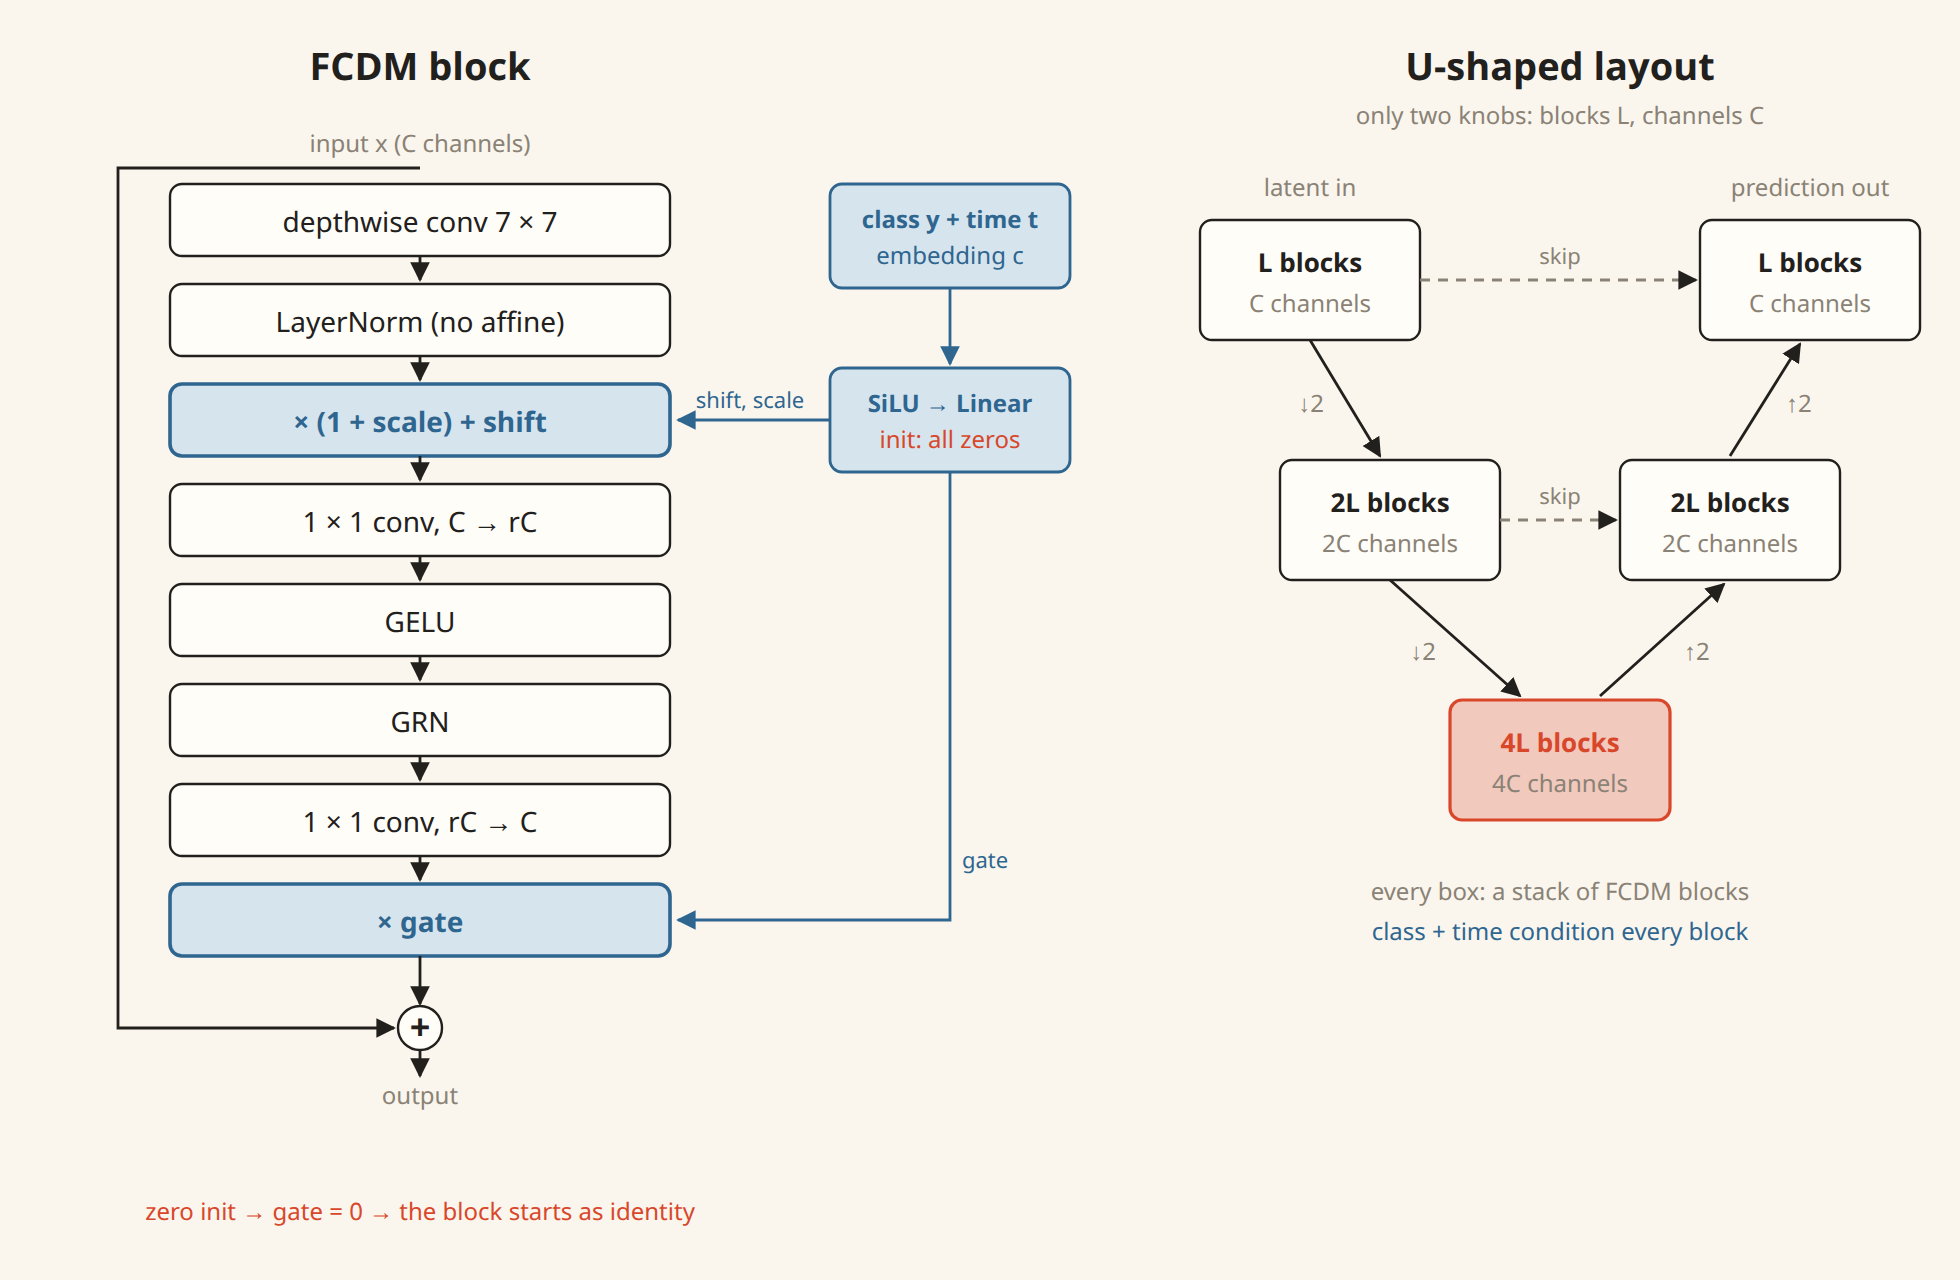
Illustration de l’articleArticle originalarXiv 2026CVPR 2026CNN classiques
Faut-il forcément un Transformer ?
Note publiée le
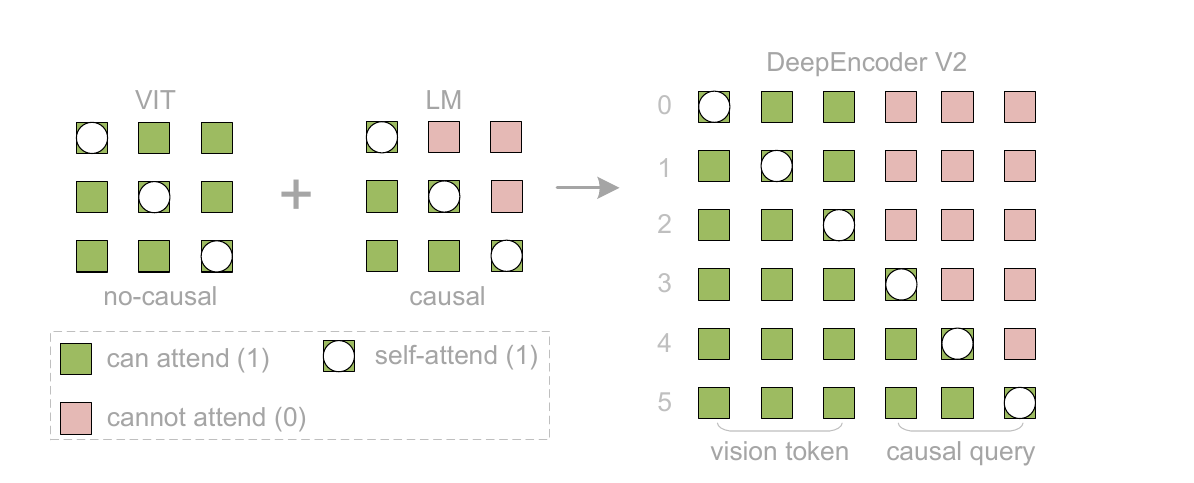
Illustration de l’articleArticle originalarXiv 2026DeepSeek
L'ordre du regard
Note publiée le
12 sur 344 affichés