Un réseau social devine qui vous connaissez peut-être ; une boutique en ligne, ce qui pourrait vous plaire. Derrière ces recommandations se cache souvent la même intuition : qui se ressemble s'assemble, et vous aimez probablement ce qu'aiment vos amis.
Le réseau de convolution sur graphes, Graph Convolutional Network ou GCN, met cette intuition en équations.
Nous partons de zéro : aucune théorie des graphes requise, les quatre opérations suffisent, et la multiplication matricielle sera expliquée au moment voulu. Vous calculerez une couche entière de GCN, puis verrez un petit modèle deviner les réponses inconnues à partir de deux réponses seulement. Trois schémas interactifs permettent de cliquer et de déplacer des curseurs : cela va bien plus vite que les formules seules.
Un premier problème
Six personnes : Alice, Bob et Carol sont amis entre eux, tout comme Dave, Eve et Frank. Carol et Dave se connaissent aussi : ils sont le seul lien entre les deux groupes.
Nous ne savons que deux choses : Alice aime les sports de balle, Frank ne les aime pas.
Et les quatre autres ?
Votre intuition : Bob connaît Alice et Carol ; Alice aime jouer au ballon, donc Bob l'aime peut-être aussi. Eve connaît Dave et Frank ; Frank n'aime pas cela, donc Eve probablement pas non plus.
« Deviner d'après les amis », voilà le point de départ de la convolution sur graphes. Transformons progressivement cette intuition en calcul.
Le graphe : des points et des traits
Précisons un mot : un graphe est une structure mathématique, composée de deux éléments :
- Nœuds (nodes) : les objets décrits, ici les six personnes.
- Arêtes (edges) : les relations entre eux, ici leurs amitiés.
Chaque nœud peut porter des nombres qui le décrivent, ses caractéristiques (features). Ici, chacun n'en a qu'une : son goût pour les sports de balle. Alice vaut 1, Frank 0 ; faute de réponse, les quatre autres sont initialisés à 0.5, à mi-chemin.
L'ordinateur ne voit pas les traits : on écrit les amitiés dans une table, la matrice d'adjacence.
Pour six personnes, la table fait 6×6. À la ligne , colonne , si les personnes et sont amies, 0 sinon.
Sur la ligne de Carol, Alice, Bob et Dave valent 1 : elle a trois amis. Le nombre de 1 dans une ligne est le nombre d'amis, appelé degré.
L'amitié est réciproque : , et la table est symétrique de part et d'autre de sa diagonale.
L'intuition la plus directe : demander aux amis
Le plus simple est de remplacer le nombre de chaque personne par la moyenne de ses amis.
Bob connaît Alice (1) et Carol (0.5) : moyenne 0.75, il aime probablement jouer au ballon. Eve connaît Dave (0.5) et Frank (0) : moyenne 0.25, elle n'aime probablement pas cela.
Une matrice calcule tout le monde en une fois. Divisons chaque ligne d'adjacence par son nombre d'amis, pour donner une part à chacun, puis multiplions par le goût de chacun pour le ballon (1 pour Alice, 0 pour Frank, 0.5 pour ceux qu'on ne connaît pas). Le résultat multiplie chaque part de la ligne par la valeur correspondante, puis les additionne : c'est la moyenne des amis de la personne . Pour les six personnes, on obtient 0.5, 0.75, 0.67, 0.33, 0.25 et 0.5.
Bob vaut 0.75, Eve 0.25, conformément à l'intuition. Mais regardez Alice et Frank.
Les deux seules personnes dont nous connaissions la réponse valent maintenant 0.5. Ne demander qu'aux amis fait perdre ce qu'on savait soi-même.
Deux corrections
Compter aussi sa propre voix
La correction est directe : inclure soi-même dans la moyenne. Ajouter des 1 sur la diagonale revient à donner à chacun un ami supplémentaire, lui-même. C'est une boucle propre (self-loop), , où est l'identité, à 1 sur la diagonale et 0 ailleurs.
Alice vaut alors et garde une bonne part de sa réponse.
Plus d'amis, une voix un peu plus légère
Dans une moyenne simple, chaque ami pèse autant. GCN ajuste aussi la part selon le nombre d'amis des deux personnes. La part reçue par depuis est :
est le degré après boucle propre, le nombre d'amis plus 1.
Pour Bob, . Il reçoit d'Alice () , et de Carol () . Carol connaît plus de monde : sa voix se répartit davantage et arrive un peu plus légère chez Bob.
La part est symétrique : Bob reçoit autant de Carol qu'elle reçoit de lui. En matrice, c'est de l'article GCN : division par la racine du degré de chaque côté. Avec les boucles, les six degrés valent 3, 3, 4, 4, 3 et 3 ; en recalculant avec , les nouvelles valeurs sont 0.64, 0.64, 0.68, 0.39, 0.31 et 0.31.
Les trois personnes de gauche dépassent 0.5, les trois de droite restent en dessous. Alice tend toujours à aimer jouer au ballon. Les parts ne somment pas forcément exactement à 1 : la ligne de Carol vaut 1.08, mais en reste proche.
Pourquoi ne pas simplement moyenner ? Les deux variantes existent. GCN choisit la version symétrique en partie pour sa dérivation spectrale, en partie pour sa stabilité quand les couches s'empilent, sans amplification croissante.
Dans le schéma interactif suivant, cliquez sur une personne pour voir de qui elle reçoit quoi. Comparez les trois règles et observez surtout Alice avec « Amis seulement ».
Nouvelle valeur de BobPoids du GCN
- Alice1.00 × 0.330.33
- Soi-même0.50 × 0.330.17
- Carol0.50 × 0.290.14
Somme0.64
Voilà une couche de GCN
Écrire ces opérations en une ligne donne la formule de l'article GCN :
Trois parties, trois rôles :
- : chacun calcule la moyenne pondérée de ses amis et de lui-même avec les parts précédentes. rassemble les caractéristiques, une personne par ligne ; à la première couche, ce sont les caractéristiques initiales .
- Multiplier par : chaque personne a souvent plusieurs caractéristiques. les recombine ; chaque nouvelle caractéristique est une somme pondérée des anciennes. Ces paramètres sont appris et partagés par tous.
- : une fonction non linéaire, ReLU dans GCN, qui ramène les valeurs négatives à 0 et garde les positives.
Ajoutons le « goût pour la lecture » : 0 pour Alice, 1 pour Frank, 0.5 pour les autres. Fixons nous-mêmes : la première nouvelle caractéristique sera « ballon moins lecture », la seconde « lecture moins ballon ». Après une couche GCN, Alice, Bob et Carol obtiennent [0.33, 0], [0.33, 0] et [0.29, 0], tandis que Dave, Eve et Frank obtiennent [0, 0.29], [0, 0.33] et [0, 0.33].
Les trois personnes de gauche ont la première caractéristique positive, les trois de droite la seconde. Une couche GCN les a déjà séparées par leurs caractéristiques.
En entraînement réel, s'apprend dans les données. Nous y revenons bientôt.
Pourquoi « convolution » ?
Si vous connaissez les réseaux convolutionnels d'images, les CNN, cela doit vous rappeler quelque chose.
Une convolution d'image remplace chaque pixel par une somme pondérée de lui-même et des 8 voisins, avec le même jeu de poids partout. La convolution sur graphe remplace aussi chaque nœud par une somme pondérée de lui-même et de ses voisins, avec un partagé. Ce sont des opérations de même famille, d'où le nom de « convolution » sur graphe.
La différence est le voisinage : 8 voisins fixes sur une grille, chacun à une position propre et avec ses poids ; un nombre variable de voisins, sans haut ni bas, sur un graphe. GCN fait donc dépendre les parts des seuls degrés. Beaucoup de recherches suivront de cette différence : c'est le premier arrêt du « Jardin du Grand Spectacle des convolutions sur graphes ».
Deux couches pour voir plus loin
Une couche fait entendre les amis. En passant sa sortie à une deuxième, on entend aussi les amis des amis.
L'information d'Alice atteint Bob et Carol en une couche, Dave au-delà du pont en deux, puis Eve et Frank en trois. Avec couches, on voit à sauts au plus.
Essayez le curseur ci-dessous.
Au départ, seuls Alice et Frank ont une réponse.
Personnes atteintes par l’information de Alice0 / 5
Les anneaux en pointillés marquent les personnes atteintes.
Au départ, maximum et minimum diffèrent de 1.00. Une couche sépare les deux groupes avec un écart de 0.37 ; à 8 couches, il ne reste que 0.18. Les valeurs se rapprochent jusqu'à effacer les groupes : c'est l'over-smoothing, le surlissage. Les principales expériences GCN utilisent deux couches ; les variantes plus profondes de l'annexe culminent à deux ou trois.
Laisser le modèle apprendre
Jusqu'ici, nous avons fourni les nombres et . Un vrai GCN doit apprendre.
Simplifions encore le problème : le modèle ignore entièrement qui aime jouer au ballon. La seule caractéristique est « qui je suis ». Ses indices sont les amitiés et deux réponses : Alice aime, Frank n'aime pas.
Le modèle lisse deux fois par , puis un classifieur linéaire, avec un softmax qui convertit les deux scores de classe en probabilités de somme 1, produit la probabilité que chaque personne aime le ballon. Seules les réponses d'Alice et Frank servent à calculer l'erreur d'entraînement, et la descente de gradient ajuste pas à pas les poids du classifieur. Avec le graphe, Bob et Carol sont prédits amateurs de ballon (0.98 et 0.92), Dave et Eve non (0.08 et 0.02) : les quatre réponses sont justes. Sans le graphe, le modèle ne sait rien d'eux et reste à 0.5.
Deux réponses connues seulement, toutes les autres déduites des amitiés : c'est l'usage classique de GCN, la classification semi-supervisée de nœuds. Sur le réseau de citations Cora, l'article donne seulement 140 étiquettes pour 2,708 articles ; deux couches GCN atteignent 81.5% d'exactitude sur les autres.
Vous pouvez suivre l'entraînement pas à pas ci-dessous, puis comparer avec « Sans le graphe ».
Sur les 4 personnes sans réponse, 0 sont du bon côté.
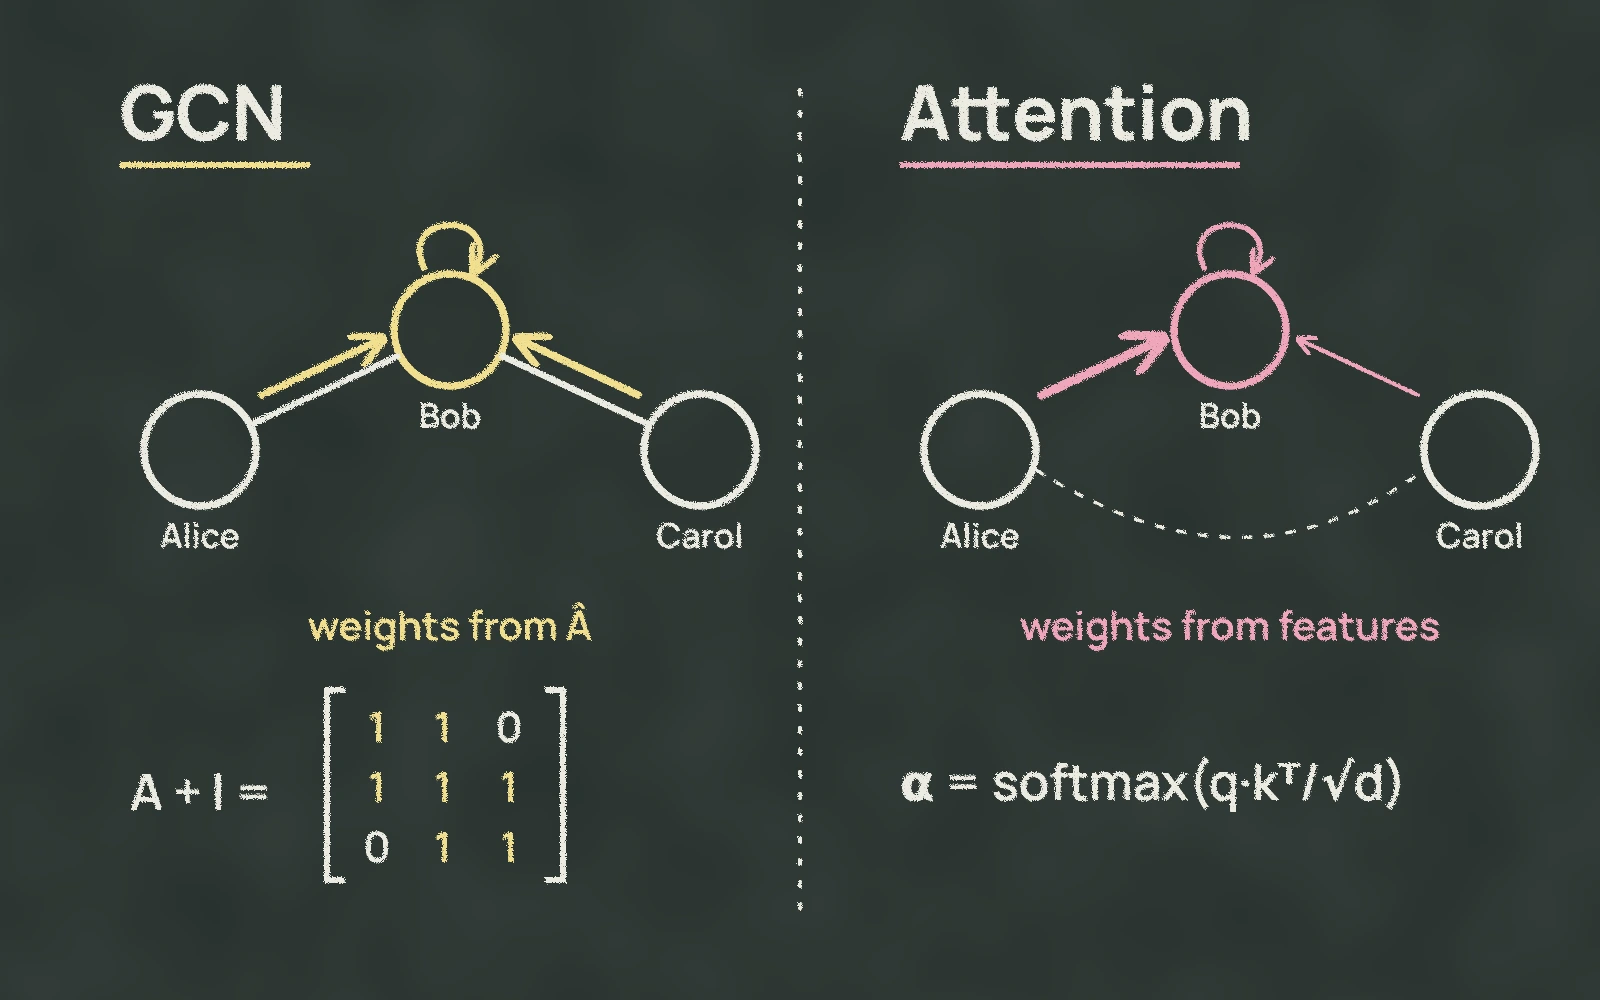
La différence avec le Transformer
Si vous connaissez le Transformer, « chacun moyenne les autres avec des poids » rappelle l'attention. Deux points les séparent.
D'abord, qui peut recevoir du poids : GCN le distribue aux amis seulement ; sans arête, la part est nulle. L'attention du Transformer laisse chacun regarder tout le monde.
Ensuite, d'où viennent les poids : les degrés fixent ceux de GCN à l'avance ; l'attention compare les caractéristiques des deux personnes et recalcule à chaque entrée.
Les voies se rejoindront progressivement : certains rendront les poids de GCN dépendants des caractéristiques, d'autres donneront la structure du graphe au Transformer.
Ce qu'il faut retenir
- Un graphe contient nœuds et arêtes ; l'adjacence note qui est relié à qui.
- Une couche GCN moyenne soi-même et ses amis avec des poids déterminés par leurs degrés, puis multiplie par et applique ReLU.
- couches voient jusqu’à sauts ; trop de couches rendent tout le monde semblable.
- Quelques réponses et les amitiés suffisent à GCN pour prédire les autres.
Pour découvrir les améliorations de cette ligne de formule, poursuivez avec le « Jardin du Grand Spectacle des convolutions sur graphes ». Il utilise ces six mêmes personnes de bout en bout, simplement renommées A à F.
La prochaine fois qu'un article écrit , rappelez-vous : c'est la formule par laquelle Bob reçoit 0.29 de Carol.