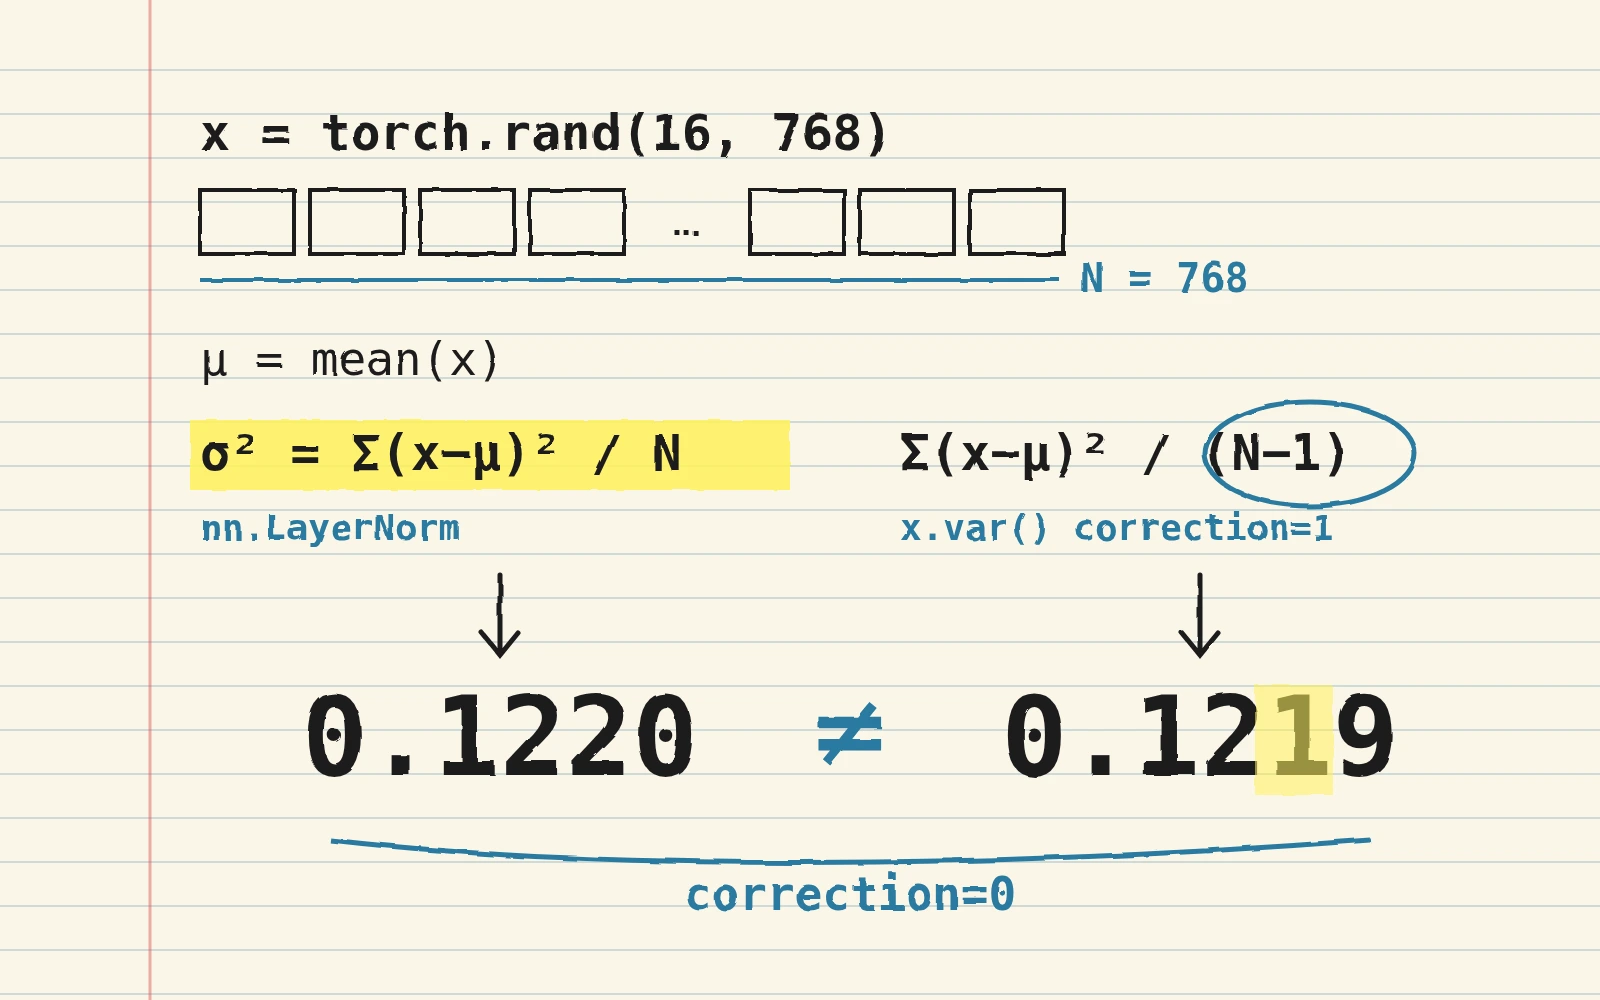
Un calcul manuel de LayerNorm peut donner un résultat proche de celui de PyTorch, sans lui correspondre exactement. Ce court exemple montre d'où vient l'écart : le calcul de la variance.
La formule de LayerNorm est :
Ici, désigne la moyenne de et sa variance. Commençons sans ni :
import torch

x = torch.rand(16, 768)
mu = x.mean(dim=-1, keepdim=True)
var = x.var(dim=-1, keepdim=True)
eps = 1e-5
y = (x - mu) / (var + eps).sqrt()
On obtient par exemple :
# tensor([[ 0.1219, -0.0222, -1.4742,  ...,  0.1738, -0.6124, -0.3001],
#         [-1.6009, -1.5814,  1.5357,  ...,  0.1917,  1.3787, -0.2772],
#         [ 0.3738,  1.0520,  0.4403,  ...,  1.1353, -0.7488, -0.9137],
#         ...,
#         [ 0.8823, -1.5427,  0.4725,  ..., -1.2544, -1.5354, -0.4305],
#         [ 1.4548,  0.3059, -0.6732,  ..., -0.7109,  0.4908, -1.2447],
#         [-0.4067,  0.5974, -0.9113,  ..., -0.2511, -0.2279, -0.9675]])
Comparons ce résultat à celui de torch.nn.LayerNorm :
layer_norm = torch.nn.LayerNorm(768, elementwise_affine=False, bias=False)

y_ln = layer_norm(x)
On obtient :
# tensor([[ 0.1220, -0.0222, -1.4752,  ...,  0.1739, -0.6128, -0.3003],
#         [-1.6020, -1.5824,  1.5367,  ...,  0.1918,  1.3796, -0.2774],
#         [ 0.3741,  1.0527,  0.4406,  ...,  1.1360, -0.7493, -0.9143],
#         ...,
#         [ 0.8829, -1.5437,  0.4728,  ..., -1.2552, -1.5364, -0.4308],
#         [ 1.4557,  0.3061, -0.6736,  ..., -0.7113,  0.4911, -1.2455],
#         [-0.4069,  0.5978, -0.9119,  ..., -0.2513, -0.2281, -0.9681]])
Les valeurs sont proches, mais elles diffèrent légèrement. Pourquoi ?
Le réglage de la variance
Par défaut, torch.var utilise correction=1 : le calcul applique la correction de Bessel.
La variance est alors divisée par N-1, tandis que torch.nn.LayerNorm utilise N.
Il suffit de définir correction=0 dans l'appel à torch.var :
var = x.var(dim=-1, correction=0, keepdim=True)
La comparaison donne alors :
# tensor([[ 0.1220, -0.0222, -1.4752,  ...,  0.1739, -0.6128, -0.3003],
#         [-1.6020, -1.5824,  1.5367,  ...,  0.1918,  1.3796, -0.2774],
#         [ 0.3741,  1.0527,  0.4406,  ...,  1.1360, -0.7493, -0.9143],
#         ...,
#         [ 0.8829, -1.5437,  0.4728,  ..., -1.2552, -1.5364, -0.4308],
#         [ 1.4557,  0.3061, -0.6736,  ..., -0.7113,  0.4911, -1.2455],
#         [-0.4069,  0.5978, -0.9119,  ..., -0.2513, -0.2281, -0.9681]])
Les valeurs correspondent maintenant à la sortie de LayerNorm.
Pourquoi LayerNorm utilise-t-il correction=0?
LayerNorm calcule la moyenne et la variance des caractéristiques d'une entrée, puis normalise cette même entrée. Il ne cherche pas à estimer la variance d'une population distincte à partir d'un échantillon : la formule divise donc par . La valeur par défaut de torch.var répond à un autre usage statistique.
Avec 768 caractéristiques, l'écart est faible mais visible quand on compare les éléments. Il augmente lorsque le nombre de caractéristiques diminue.
En pratique
Si votre calcul manuel diffère de torch.nn.LayerNorm, vérifiez d'abord le dénominateur de la variance. Dans cet exemple, torch.var(..., correction=0) donne le même réglage.