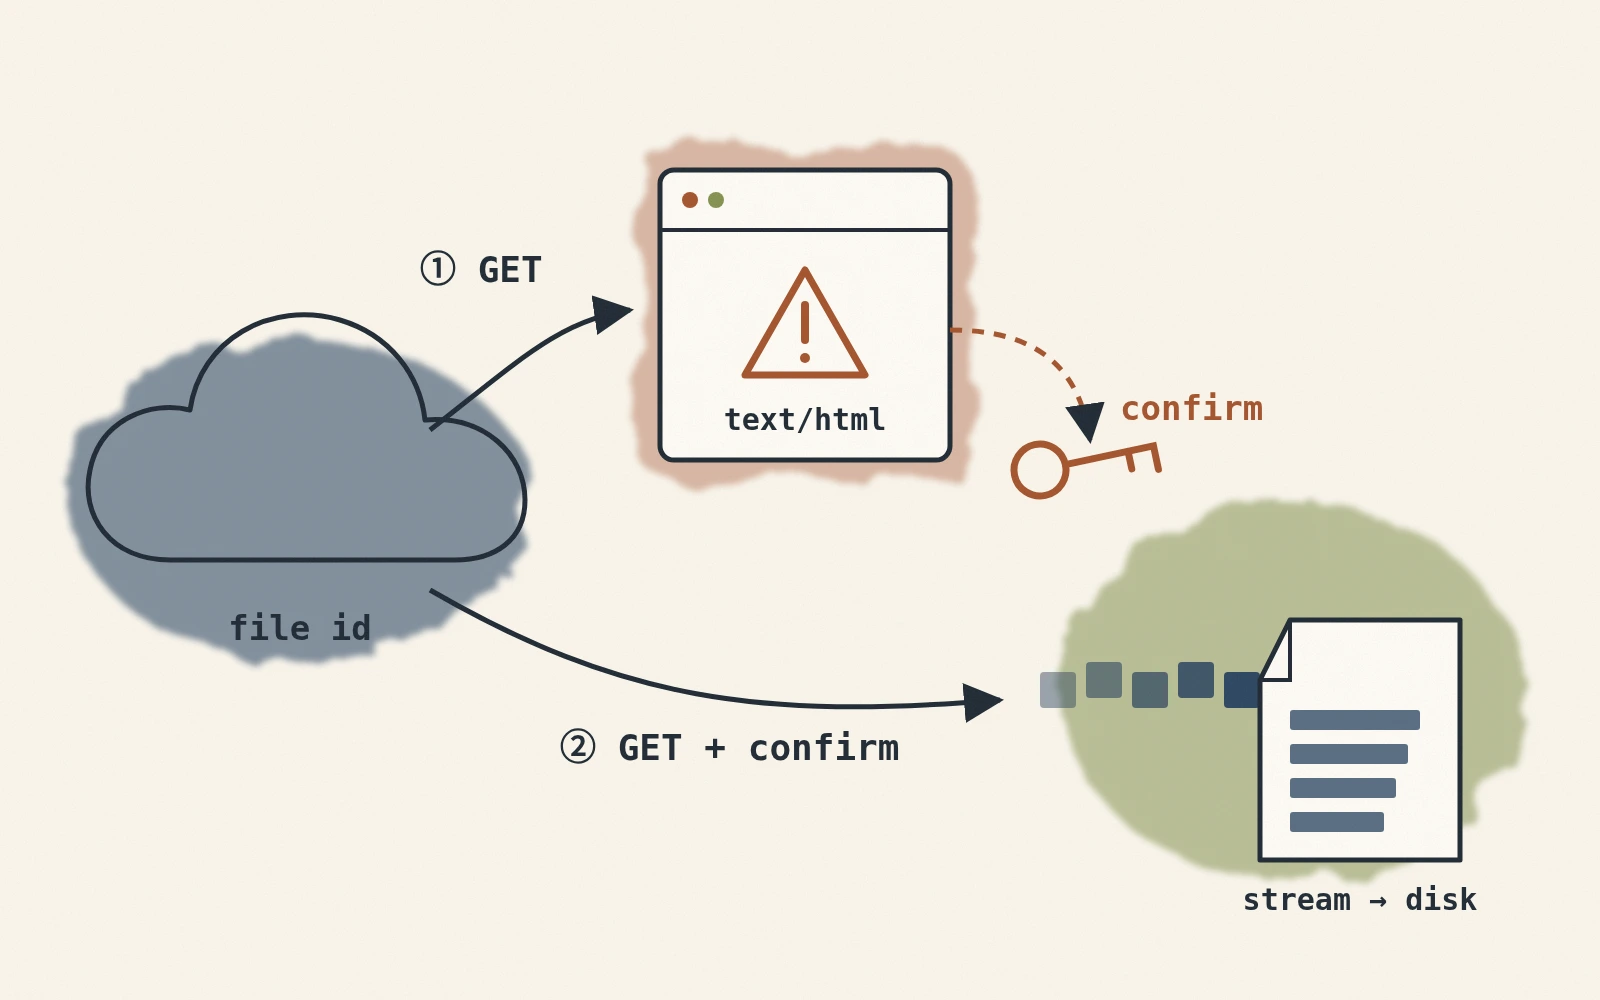
Un téléchargement Python d'un fichier Google Drive partagé publiquement peut parfois enregistrer une page de confirmation de balayage de virus en HTML. Cet article explique le flux de deux demandes utilisé sur le site original et comment vérifier que la réponse finale est un fichier.
Pourquoi n'obtenons-nous que du HTML?
Une demande à l'URL de téléchargement Web peut renvoyer le fichier directement, ou il peut retourner une page de confirmation en premier. Le déclencheur et le format de la page sont contrôlés par Google; un seuil de taille de fichier fixe n'est pas fiable.
Un navigateur peut suivre le bouton de confirmation. Un script doit gérer cette réponse et vérifier l'état HTTP final et télécharger l'en-tête avant d'écrire le fichier cible.
Solution : Demande en deux étapes
Le téléchargement comporte quatre étapes:
- Première demande: Envoyer une demande GET à
https://docs.google.com/uc?export=downloadavec l'identifiant du fichier. - Vérifier la réponse: A
Content-Dispositionsinon, vérifiez si la réponse est une page de confirmation; ne l'enregistrez pas en tant que fichier cible. - Extrait le jeton de confirmation:
- Des cookies: Google peut placer un
download_warning_xxxxxclé dans les cookies, qui contient le jeton. Par exemple:token = session.cookies.get('download_warning_xxxxx') - À partir de HTML: Parfois, Google peut ne pas placer le jeton dans les cookies, mais dans le formulaire HTML. Par exemple:
BeautifulSoup lit les champs cachés, notamment
<form id="download-form" action="https://drive.usercontent.google.com/download" method="get" > <input type="hidden" name="confirm" value="t" /> ... </form>confirmetuuid.
- Des cookies: Google peut placer un
- Envoyer la demande de confirmation: Passez le jeton ou les champs de formulaire, puis vérifiez l'état HTTP et téléchargez à nouveau l'en-tête. Ce workflow HTML s'applique aux fichiers accessibles au public et peut changer.](https://developers.google.com/workspace/drive/api/guides/manage-downloads) avec autorisation.
Mise en œuvre du code
Tout d'abord, installez les paquets nécessaires:
pip install requests tqdm beautifulsoup4
Ensuite, utilisez la fonction Python suivante, fournissant l'ID du fichier, le nom que vous voulez enregistrer le fichier comme, et le répertoire cible pour déterminer automatiquement si une deuxième requête est nécessaire et télécharger le fichier avec succès:
import os
import re
from urllib.parse import urljoin, urlparse
import requests
from tqdm import tqdm
from bs4 import BeautifulSoup

def download_from_google(file_id: str, file_name: str, target: str = "."):
    """
    Downloads a file from Google Drive, handling potential confirmation tokens for large files.

    Args:
        file_id (str):
            The ID of the file to download from Google Drive.
        file_name (str):
            The name to save the downloaded file as.
        target (str, optional):
            The directory to save the file in. Defaults to the current directory (".").

    Raises:
        Exception: If the download fails or the file cannot be created.

    Notes:
        This function handles both small and large files. For large files, it automatically processes
        Google's confirmation token to bypass warnings about virus scans or file size limits.

    Example:
        Download a file to the current directory:
            download_from_google(
                file_id="xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx",
                file_name="example_file.txt"
            )

        Download a file to a specific directory:
            download_from_google(
                file_id="xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx",
                file_name="example_file.txt",
                target="./downloads"
            )
    """
    # First try: docs.google.com/uc?export=download&id=FileID
    base_url = "https://docs.google.com/uc"
    session = requests.Session()
    params = {
        "export": "download",
        "id": file_id
    }
    response = session.get(base_url, params=params, stream=True, timeout=(10, 60))

    # If Content-Disposition is present, the file is directly available
    if "content-disposition" not in response.headers:
        # Try to get the token from cookies
        token = None
        for k, v in response.cookies.items():
            if k.startswith("download_warning"):
                token = v
                break

        # If no token in cookies, extract it from the HTML
        if not token:
            soup = BeautifulSoup(response.text, "html.parser")
            # Common case: HTML contains a form with id="download-form"
            download_form = soup.find("form", {"id": "download-form"})
            if download_form and download_form.get("action"):
                # Extract action URL, which might be drive.usercontent.google.com/download
                download_url = urljoin(response.url, download_form["action"])
                if urlparse(download_url).hostname not in {
                    "docs.google.com", "drive.google.com", "drive.usercontent.google.com"
                }:
                    raise RuntimeError("Unexpected Google Drive download host")
                # Collect all hidden inputs
                hidden_inputs = download_form.find_all("input", {"type": "hidden"})
                form_params = {}
                for inp in hidden_inputs:
                    if inp.get("name") and inp.get("value") is not None:
                        form_params[inp["name"]] = inp["value"]

                # Re-send the GET request with these parameters
                response = session.get(download_url, params=form_params, stream=True, timeout=(10, 60))
            else:
                # Otherwise, search for confirm=xxx in HTML
                match = re.search(r'confirm=([0-9A-Za-z-_]+)', response.text)
                if match:
                    token = match.group(1)
                    # Include the confirm token in the request
                    params["confirm"] = token
                    response = session.get(base_url, params=params, stream=True, timeout=(10, 60))
                else:
                    raise Exception("Unable to find the download link or confirmation token in the response. Download failed.")

        else:
            # Use the token obtained from cookies and resend the request
            params["confirm"] = token
            response = session.get(base_url, params=params, stream=True, timeout=(10, 60))

    # Ensure the download directory exists
    response.raise_for_status()
    if "content-disposition" not in response.headers:
        raise RuntimeError("Google Drive did not return a downloadable file")
    if not file_name or file_name in {".", ".."} or os.path.basename(file_name) != file_name:
        raise ValueError("file_name must be a filename, not a path")

    os.makedirs(target, exist_ok=True)
    file_path = os.path.join(target, file_name)

    # Start downloading the file in chunks, with a progress bar
    try:
        total_size = int(response.headers.get('content-length', 0))
        with open(file_path, "wb") as f, tqdm(
            desc=file_name,
            total=total_size,
            unit="B",
            unit_scale=True,
            unit_divisor=1024,
        ) as bar:
            for chunk in response.iter_content(chunk_size=32768):
                if chunk:
                    f.write(chunk)
                    bar.update(len(chunk))

        print(f"File successfully downloaded to: {file_path}")

    except Exception as e:
        raise Exception(f"File download failed: {e}")
Comment utiliser
Supposons que vous ayez un ID de fichier : YOUR_FILE_ID, vous voulez le télécharger comme big_model.onnx et de le stocker dans le ./models répertoire, appelez-le comme ceci:
download_from_google(
    file_id="YOUR_FILE_ID",
    file_name="big_model.onnx",
    target="./models"
)
Une fois terminé, vous trouverez le téléchargé avec succès big_model.onnx dans le ./models dossier, et vous verrez l'avancement du téléchargement dans le terminal.
Outil en ligne de commande
La même fonction peut être appelée à partir d'un wrapper en ligne de commande :
from download_from_google import download_from_google
import argparse

def main():
    parser = argparse.ArgumentParser(description="Download files from Google Drive.")
    parser.add_argument("--file-id", required=True, help="Google Drive file ID.")
    parser.add_argument("--file-name", required=True, help="Output file name.")
    parser.add_argument("--target", default=".", help="Output directory. Defaults to current folder.")
    args = parser.parse_args()

    download_from_google(file_id=args.file_id, file_name=args.file_name, target=args.target)

if __name__ == "__main__":
    main()
Enregistrer le code ci-dessus comme download_from_google_cli.py, puis lancez-le à partir de la ligne de commande:
python download_from_google_cli.py \
 --file-id YOUR_FILE_ID \
 --file-name big_model.onnx \
 --target ./models
Le script doit échouer si la réponse finale est toujours une page HTML ou d'erreur. Le site original a testé des fichiers publics de 70 Mo et 900 Mo; ces observations ne garantissent pas le même comportement pour d'autres permissions, types de fichiers ou versions de pages ultérieures.