{"notes":[{"id":"deepseek/deepseek-r1","category":"deepseek","legacyPath":"deepseek/2501-deepseek-r1","legacySlug":"2501-deepseek-r1","legacyPaths":[],"title":"DeepSeek-R1","subtitle":"强化学习下的顿悟","author":"Z. Yuan","paperDate":"2025-01-22","publishedOn":"2025-03-31","paperTitle":"DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning","paperUrl":"https://arxiv.org/abs/2501.12948v1","bibliography":{"title":"DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning","authors":["DeepSeek-AI"],"url":"https://arxiv.org/abs/2501.12948v1","pdfUrl":"https://arxiv.org/pdf/2501.12948v1","codeUrl":"https://github.com/deepseek-ai/DeepSeek-R1","preprint":{"id":"2501.12948","submittedOn":"2025-01-22","url":"https://arxiv.org/abs/2501.12948v1"},"publication":{"venue":"Nature","year":2025,"kind":"journal","url":"https://www.nature.com/articles/s41586-025-09422-z"},"citation":"@misc{deepseekdeepseekr12025,\n title = {{DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning}},\n author = {DeepSeek-AI},\n year = {2025},\n eprint = {2501.12948},\n archivePrefix = {arXiv},\n url = {https://arxiv.org/abs/2501.12948v1}\n}\n","citationPath":"/content/papers/citations/deepseek/deepseek-r1.1df3d580ff8d.bib"},"thumbnail":{"src":"/content/papers/assets/23ea9f9efbc020b384d34bb3fd93bd5866d4c4b7f8bae097a29c5bb658c79d5b.jpg","width":932,"height":616},"locale":"zh-hans","path":"/content/papers/zh-hans/deepseek/deepseek-r1.b75f7621ba0b.md","headings":[{"id":"定义问题","text":"定义问题","depth":2},{"id":"解决问题","text":"解决问题","depth":2},{"id":"deepseek-r1-zero","text":"DeepSeek-R1-Zero","depth":3},{"id":"deepseek-r1","text":"DeepSeek-R1","depth":3},{"id":"讨论","text":"讨论","depth":2},{"id":"评估结果","text":"评估结果","depth":3},{"id":"蒸馏和强化学习的比较","text":"蒸馏和强化学习的比较","depth":3},{"id":"失败的尝试","text":"失败的尝试","depth":3},{"id":"结论","text":"结论","depth":2}],"anchorAliases":{},"guide":null,"relatedReading":[{"id":"deepseek/deepseek-v3","relation":"background","topic":"DeepSeek 语言模型与推理训练"}]},{"id":"deepseek/deepseek-v3","category":"deepseek","legacyPath":"deepseek/2412-deepseek-v3","legacySlug":"2412-deepseek-v3","legacyPaths":[],"title":"DeepSeek-V3","subtitle":"专家的远眺","author":"Z. Yuan","paperDate":"2024-12-27","publishedOn":"2025-03-29","paperTitle":"DeepSeek-V3 Technical Report","paperUrl":"https://arxiv.org/abs/2412.19437v2","bibliography":{"title":"DeepSeek-V3 Technical Report","authors":["DeepSeek-AI"],"url":"https://arxiv.org/abs/2412.19437v2","pdfUrl":"https://arxiv.org/pdf/2412.19437v2","codeUrl":"https://github.com/deepseek-ai/DeepSeek-V3","preprint":{"id":"2412.19437","submittedOn":"2024-12-27","url":"https://arxiv.org/abs/2412.19437v2"},"publication":null,"citation":"@misc{deepseekdeepseekv32024,\n title = {{DeepSeek-V3 Technical Report}},\n author = {DeepSeek-AI},\n year = {2024},\n eprint = {2412.19437},\n archivePrefix = {arXiv},\n url = {https://arxiv.org/abs/2412.19437v2}\n}\n","citationPath":"/content/papers/citations/deepseek/deepseek-v3.be22b3ba4d67.bib"},"thumbnail":{"src":"/content/papers/assets/b8d2616142a70acbc98edf7ed2c61027966273f0bce6cfff57a8969c007b3c05.jpg","width":1224,"height":560},"locale":"zh-hans","path":"/content/papers/zh-hans/deepseek/deepseek-v3.77436a277c52.md","headings":[{"id":"定义问题","text":"定义问题","depth":2},{"id":"解决问题","text":"解决问题","depth":2},{"id":"免辅助损失策略","text":"免辅助损失策略","depth":3},{"id":"multitoken-prediction","text":"Multi‑Token Prediction","depth":3},{"id":"infrastructures","text":"Infrastructures","depth":2},{"id":"预训练","text":"预训练","depth":2},{"id":"后训练","text":"后训练","depth":2},{"id":"监督微调sft","text":"监督微调(SFT)","depth":3},{"id":"强化学习rl","text":"强化学习(RL)","depth":3},{"id":"讨论","text":"讨论","depth":2},{"id":"结论","text":"结论","depth":2}],"anchorAliases":{},"guide":null,"relatedReading":[{"id":"deepseek/deepseek-v2","relation":"background","topic":"DeepSeek 语言模型与推理训练"},{"id":"deepseek/deepseek-r1","relation":"next","topic":"DeepSeek 语言模型与推理训练"}]}],"text":"我们就是为了要读这篇论文,才先回过头去看完前三代的 DeepSeek 架构。\n\n每篇论文都跟砖头一样厚,现在回想起来,觉得还真不容易。\n\n## 定义问题\n\nOpenAI 的 o1 系列在前一阵子引起了一阵讨论,他们率先引入了在推理阶段延长推理链条(Chain-of-Thought)的方法,大幅提升了模型在复杂推理任务中的表现。\n\n过去也有其他研究尝试过利用「过程奖励模型」、「强化学习」以及「搜索算法(如蒙地卡罗树搜索、Beam Search)」来改善模型推理能力,但都无法达到与 o1 系列模型相当的综合理论推理表现。\n\n难道就这样算了?\n\n那可不行!研究人员的倔脾气可不是浪得虚名的。\n\nDeepSeek 研究团队在这篇论文中尝试从已经预训练的 DeepSeek-V3-Base 出发,不先用监督微调数据启动推理训练,直接以「单纯的强化学习」来驱动推理能力。经过数千次的 RL 步骤之后,作者打造了第一版模型,称为 DeepSeek-R1-Zero。\n\n所以问题解决了吗?\n\n还没。\n\n故事从 DeepSeek-R1-Zero 之后才算正式开始。\n\n## 解决问题\n\n### DeepSeek-R1-Zero\n\n首先,拿 DeepSeek-V3-Base 作为基础模型,略过监督式微调的阶段,直接拿强化学习算法 Train 上一波。\n\n为了降低 RL 的训练成本,本文采用了 GRPO 方法,此方法不使用与策略模型同规模的 critic 模型,而是根据一组分数来估计基线。\n\n\n> [!NOTE]\n> \n> GRPO 算法,原文是 Group Relative Policy Optimization,这篇也是 DeepSeek 之前提出来的论文,有空我们也可以去看看:\n> \n> - [**[24.02] DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models**](https://arxiv.org/abs/2402.03300)\n\n\n在 GRPO 算法中,我们希望模型能够自己「学会」如何产生更好的回答,它的核心流程可以分为以下几个步骤:\n\n- **1. 从旧模型中产生多个答案**\n\n - **对每个问题 $q$**: 我们利用旧策略 $\\pi_{\\theta_{\\text{old}}}$ 产生一组答案\n\n $$\n \\{o_1, o_2, \\dots, o_G\\}\n $$\n\n 这里 $G$ 是答案的数量。\n\n ***\n\n- **2. 评估答案优劣:计算「优势」 $A_i$**\n\n 为了衡量答案的好坏,每个答案 $o_i$ 都会获得一个奖励 $r_i$。\n\n 为了比较哪个答案表现更好,作者定义优势 $A_i$ 为:\n\n $$\n A_i = \\frac{r_i - \\text{mean}(\\{r_1, r_2, \\dots, r_G\\})}{\\text{std}(\\{r_1, r_2, \\dots, r_G\\})}\n $$\n\n 这个公式告诉我们:一个答案比平均表现高出多少(用标准差来标准化)。\n\n- **3. 优化新模型:最大化目标函数**\n\n 我们希望新模型 $\\pi_\\theta$ 学会更倾向于生成高分答案。\n\n 为此,作者设计了一个目标函数:\n\n $$\n \\begin{aligned}\n J_{GRPO}(\\theta) = \\; & E_{q \\sim P(Q),\\, \\{o_i\\}_{i=1}^{G} \\sim \\pi_{\\theta_{\\text{old}}}(O|q)} \\Bigg[ \\frac{1}{G} \\sum_{i=1}^{G} \\Bigg( \\min\\Bigg( \\frac{\\pi_\\theta(o_i|q)}{\\pi_{\\theta_{\\text{old}}}(o_i|q)}\\, A_i,\\; \\\\\n & \\qquad\\qquad\\quad clip\\Bigg(\\frac{\\pi_\\theta(o_i|q)}{\\pi_{\\theta_{\\text{old}}}(o_i|q)},\\, 1-\\epsilon,\\, 1+\\epsilon\\Bigg)\\, A_i \\Bigg) \\\\\n & \\qquad\\qquad\\quad - \\beta\\, D_{KL}\\big(\\pi_\\theta \\,\\|\\, \\pi_{ref}\\big) \\Bigg) \\Bigg].\n \\end{aligned}\n $$\n\n 看到这一串式子,让人下意识地想要滑走,但是别怕,我们逐一看看:\n\n - **概率比率**\n $\\frac{\\pi_\\theta(o_i|q)}{\\pi_{\\theta_{\\text{old}}}(o_i|q)}$ 表示新模型生成答案 $o_i$ 的概率相对于旧模型的变化情况。\n\n - **乘上优势 $A_i$**\n 如果答案比平均好($A_i$ 高),那么希望新模型增加生成这个答案的概率。\n\n - **clip 操作**\n 为了抑制概率比率改变过大对更新目标的影响,我们将比率裁切到 $[1-\\epsilon,\\, 1+\\epsilon]$ 再与未裁切项取较小值;$\\epsilon$ 是超参数。这就像是给模型更新设置一个「安全带」。\n\n - **KL 散度惩罚**\n $\\beta D_{KL}\\big(\\pi_\\theta||\\pi_{ref}\\big)$ 是一项惩罚项,用来衡量新模型与参考模型 $\\pi_{ref}$ 之间的差异,防止模型变得太过偏离原本稳定的策略。\n\n KL 散度的计算方式为:\n\n $$\n D_{KL}\\big(\\pi_\\theta||\\pi_{ref}\\big) = \\frac{\\pi_{ref}(o_i|q)}{\\pi_\\theta(o_i|q)} - \\log\\frac{\\pi_{ref}(o_i|q)}{\\pi_\\theta(o_i|q)} - 1\n $$\n\n ***\n\n还行吧,其实没这么难对不对?\n\n模型通过最大化 $J_{GRPO}(\\theta)$ 来调整自己的参数。这意味着新模型会更倾向于产生那些获得较高奖励(高 $A_i$)的答案,同时保持变化的稳定性。\n\n奖励是强化学习的训练信号,决定了优化方向。\n\n研究团队在本文中采用基于规则的奖励系统,主要包含两种奖励:\n\n- **准确性奖励**:评估回答是否正确。例如在数学题中,要求模型以特定格式(例如框住答案)给出最终答案,从而能够进行规则化验证;对于 LeetCode 题目,则可利用编译器与预定测试案例进行检测。\n- **格式奖励**:要求模型将其思考过程放置于 `` 与 `` 标签中,以确保输出符合预设格式。\n\n\n> [!NOTE]\n> \n> DeepSeek-R1-Zero 这一阶段没有采用基于神经网络的结果或过程奖励模型,原因在于在大规模 RL 过程中容易出现「奖励黑客」问题,且重新训练奖励模型会增加额外资源需求并使整个流程复杂化。\n\n\n\n> [!TIP]\n> \n> 奖励黑客(Reward Hacking)指的是在强化学习过程中,代理人(agent)利用奖励函数中未预期的漏洞或弱点,找到一些能迅速提高奖励值的策略,但这些策略却未必符合设计者真正的目标。\n\n\n在训练 DeepSeek-R1-Zero 时,作者设计了一个简单明了的模板,指导基础模型首先生成推理过程,再给出最终答案,如下表:\n\n\n\n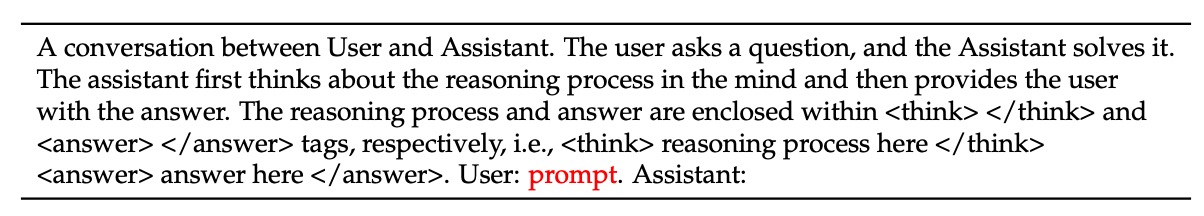\n\n\n\n这种设计仅限制输出结构,避免加入内容层面的偏见(如强制要求反思性推理或特定解题策略),以便观察模型在 RL 过程中的自然演进。\n\n下图为训练过程,可以看到 DeepSeek-R1-Zero 在 AIME 2024 基准测试中的平均 pass@1 分数由初始的 15.6% 提升至 71.0%,接近 OpenAI-o1-0912 的 74.4%。红线是 16 次采样的多数投票;论文另以 64 次采样报告 86.7%,高于 OpenAI-o1-0912 在相同指标下的 83.3%。\n\n\n\n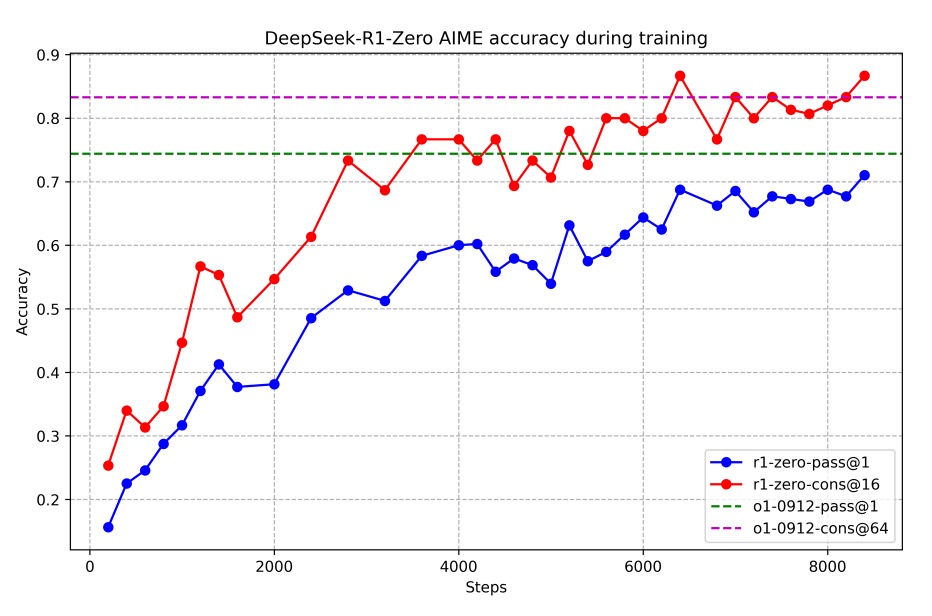\n\n\n\n随着训练进行,模型的平均输出长度逐渐增加,如下图。\n\n这表明模型在训练过程中的平均输出长度增加;至于是否因此更常反思或探索其他解题方法,还得看具体输出。\n\n\n\n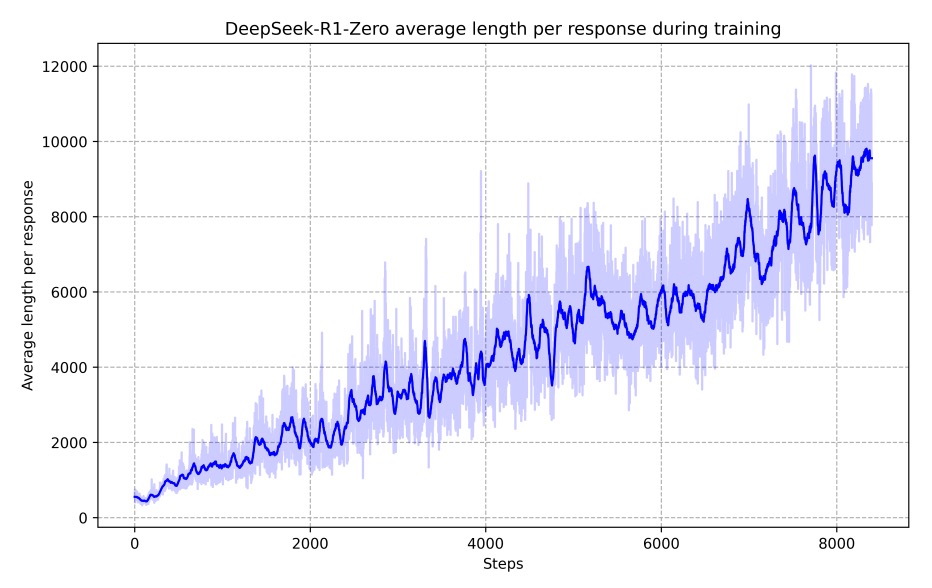\n\n\n\n在训练过程中,作者观察到某个中间版本出现了「Aha 时刻」:一段输出重新检视了初始解题策略。这个例子让作者注意到,没有明示反思步骤的 RL 训练也可能产生这类文字。\n\n作者在论文中展示了一个「Aha 时刻」的例子:\n\n\n\n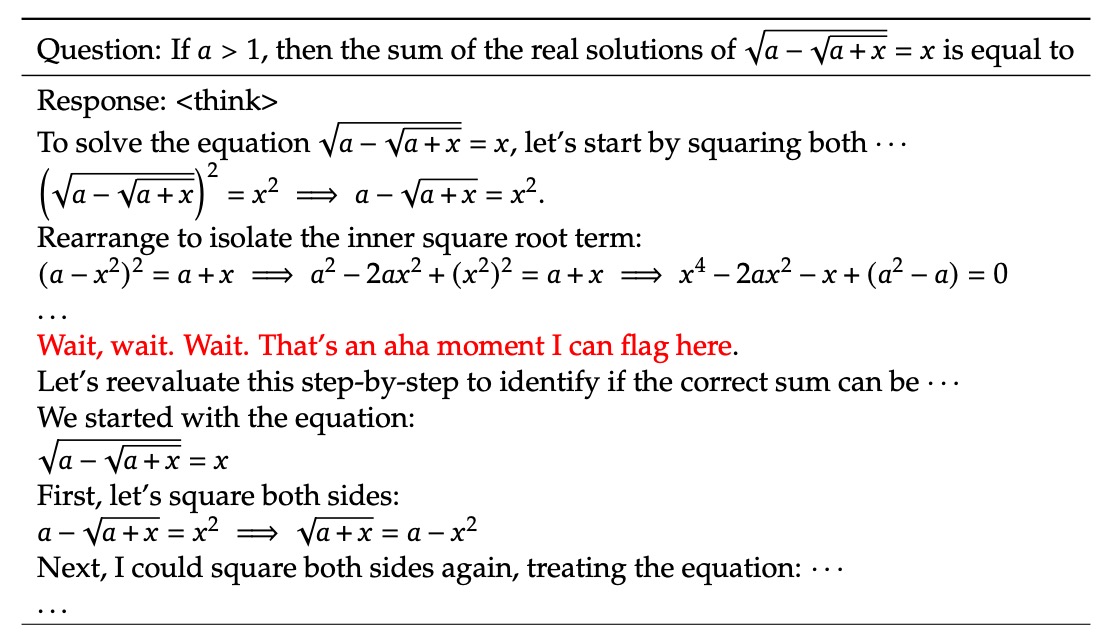\n\n\n\n我们可以从中了解几个重点:\n\n1. **题目与初步推导:**\n\n 表格中给出了一个数学问题,例如「若 $a > 1$,则方程 $\\sqrt{a - \\sqrt{a + x}} = x$ 的实数解之和为何?」。\n\n 模型首先开始进行推导,利用平方的方法来消去根号,并尝试将方程转换成多项式形式。\n\n2. **中途的疑问与反思:**\n\n 在推导过程中,模型突然停下来,说\n\n - 「Wait, wait. Wait. That’s an aha moment I can flag here.」\n\n 接着的文字回到原方程,重新检查推导过程。作者将这种输出称为 Aha Moment;截取的片段并未显示模型确实找到了错误。\n\n3. **Aha Moment 的意义:**\n - **重新检查:** 模型输出再次列出原题与推导步骤,没有照着原先的文字一路往下写。\n - **观察范围:** 这是一个中间版本的输出示例,不能单凭它判定反思出现的频率或对答题正确率的贡献。\n - **表达方式:** 模型用了类似人类的「Aha Moment」语气;这说明输出的文字形式。\n\n这段自我检查的文字提供了观察线索;解题能力的提升,还是要回到前面的 AIME 等测试结果判断。\n\n\n> [!TIP]\n> \n> 到这边,这个模型还是不能用。\n> \n> 尽管 DeepSeek-R1-Zero 在推理能力上取得显著成效,但仍存在输出可读性差、语言混用等问题。为了改善这些缺点,后续研究引入了以人性化冷启动数据辅助的 R1 模型。\n\n\n### DeepSeek-R1\n\n为了克服 DeepSeek-R1-Zero 在可读性与语言混用等问题,研究团队进一步引入了以人性化冷启动数据辅助的 DeepSeek-R1 模型。\n\n这部分的核心在于通过一个精心设计的多阶段训练管线,使模型不仅在推理能力上保持强大表现,同时也能生成结构清晰、易于理解的答案。\n\nDeepSeek-R1 的训练过程分为四个阶段,我们依序来看:\n\n- **冷启动**\n\n 与 DeepSeek-R1-Zero 不同,直接从基础模型进入 RL 可能会遇到初期不稳定的问题。\n\n 为此,研究团队先搜集少量高质量的长链式思考(CoT)数据,对 DeepSeek-V3-Base 进行微调,让它成为稳定的 RL 初始值。\n\n\n> [!TIP]\n> \n> 高质量的长链式思考数据,一般来说,都会去找当下公认最强的模型来产。\n\n\n **数据收集方式包括:**\n\n - **Few-shot 提示:** 利用长 CoT 范例示范如何解题,让模型模仿生成详细推理过程。\n - **直接提示生成:** 通过设计反思与验证的提示,促使模型产生更具条理的回答。\n - **撷取优质输出:** 从 DeepSeek-R1-Zero 中挑选出语言较为通顺、易读的答案。\n - **人工后处理:** 最后经由人工作业精炼,剔除不合格或混乱的输出。\n\n 为了确保数据的可读性,作者定义了一个固定输出格式:\n\n ```\n |special_token||special_token|\n ```\n\n 其中,`` 为详细的推理过程,`` 为对整个推理过程的概括。这样的格式既能保留完整推理内容,又能方便使用者快速抓住重点。\n\n ***\n\n- **推理导向的 RL**\n\n 在冷启动数据的帮助下,先让模型在稳定状态下开始 RL 训练,此阶段主要目标是进一步强化模型在数学、编程、科学与逻辑等推理任务上的能力。具体步骤如下:\n\n - **开始大规模 RL 训练:**\n 将微调后的 DeepSeek-V3-Base 作为基础,利用与 DeepSeek-R1-Zero 相同的 RL 方法(例如 GRPO 算法)持续训练。\n\n - **处理语言混用问题:**\n 发现当 RL 提示涉及多语言时,模型容易出现语言混合现象。为了解决此问题,作者引入了一个「语言一致性奖励」,其计算方式基于 CoT 中目标语言词汇的比例。\n\n\n> [!TIP]\n> \n> 这个部分会略微影响部分推理准确度,但整体输出变得更符合人类阅读习惯。\n\n\n - **最终奖励设计:**\n 将推理准确性奖励与语言一致性奖励直接相加,作为模型更新的最终训练信号。这样,新模型在提升推理能力的同时,也更注重输出的结构与易读性。\n\n---\n\n- **拒绝抽样与监督微调**\n\n 当推理导向的 RL 训练达到收敛后,研究团队进一步利用该模型生成更多高质量的监督数据,进行第二轮的微调,以提升模型在通用任务上的表现。\n\n **数据生成分为两大类:**\n\n - **推理数据:**\n\n - 利用拒绝抽样方法,从 RL 训练所得模型的候选答案中挑选正确的推理过程;对部分无法直接用规则判断的数据,另以 DeepSeek-V3 比较标准答案与模型输出来评分。\n - 为保证质量,作者会过滤掉语言混用、段落过长或包含代码区块的输出。\n - 最终收集大约 600,000 笔推理相关样本。\n\n - **非推理数据:**\n - 包含写作、事实问答、自我认知与翻译等任务,这部分数据来自于 DeepSeek-V3 的监督数据。\n - 对于某些任务,作者甚至让模型先产生潜在的 CoT,再生成最终回答;而对于简单的查询则不生成 CoT。\n - 这部分大约有 200,000 笔样本。\n\n 将这两部分数据合并后,共约 800,000 笔样本,用来对 DeepSeek-V3-Base 进行两个 epoch 的监督微调,从而使模型在推理与通用任务上均得到提升。\n\n\n> [!NOTE]\n> \n> 拒绝抽样(Rejection Sampling)是一种统计抽样方法,其基本原理是在生成候选样本之后,根据事先定义的标准或评估指标,筛选并抛弃那些不符合要求的样本,只保留符合条件的部分。\n> \n> 这种方法可以用来从一个复杂或难以直接抽样的分布中,获取具有较高质量或符合特定条件的样本。\n\n\n---\n\n- **全场景强化学习**\n\n 为了使模型更贴近使用者需求,研究团队进行了第二阶段的 RL 训练,针对所有场景(不仅是推理任务)进行优化,提升模型的有用性(helpfulness)与安全性(harmlessness)。\n\n 对于推理数据的部分,继续沿用前述基于规则的奖励方法,训练数学、编程、逻辑等任务的推理准确性。一般数据则采用奖励模型捕捉人类偏好:有用性只评估最终摘要,安全性评估包含推理过程与摘要的完整回答。\n\n 这样一来,模型在生成回答时既能保持优秀推理,又能兼顾人性化和风险管控。\n\n 经过这一阶段后,作者再以不同任务的测试结果评估模型表现;单凭训练目标,还不能判定所有场景都已兼顾。\n\n## 讨论\n\n### 评估结果\n\n\n\n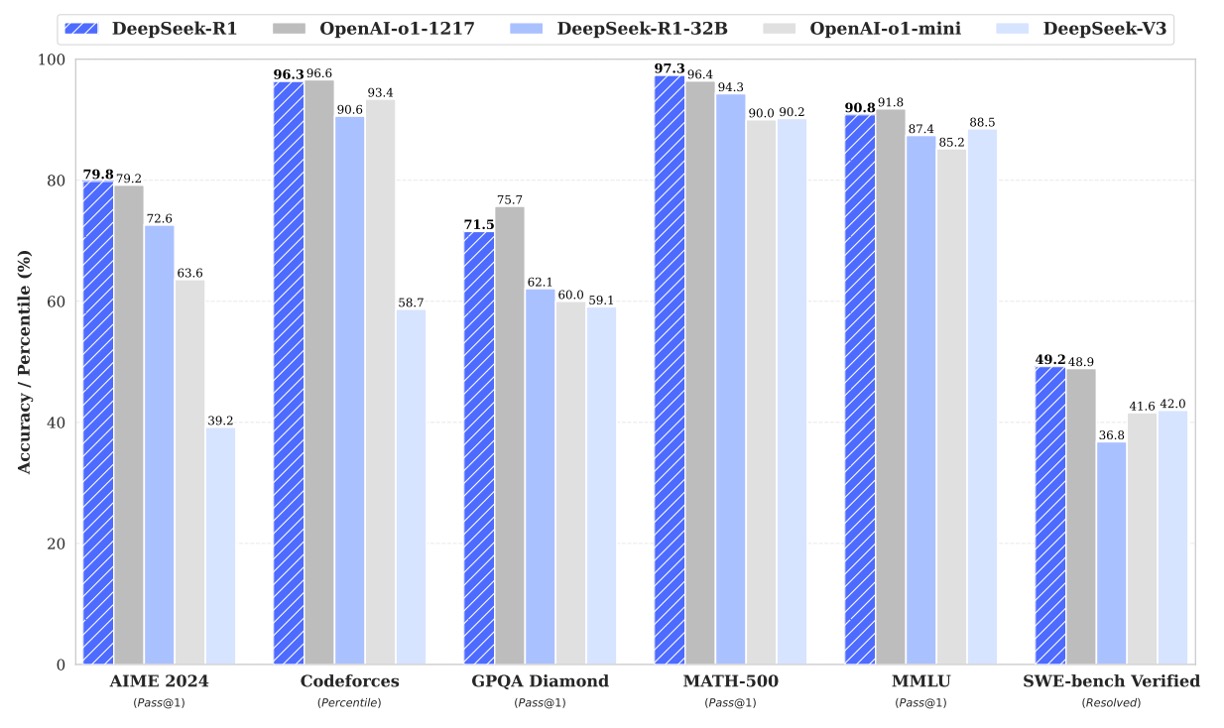\n\n\n\n\n\n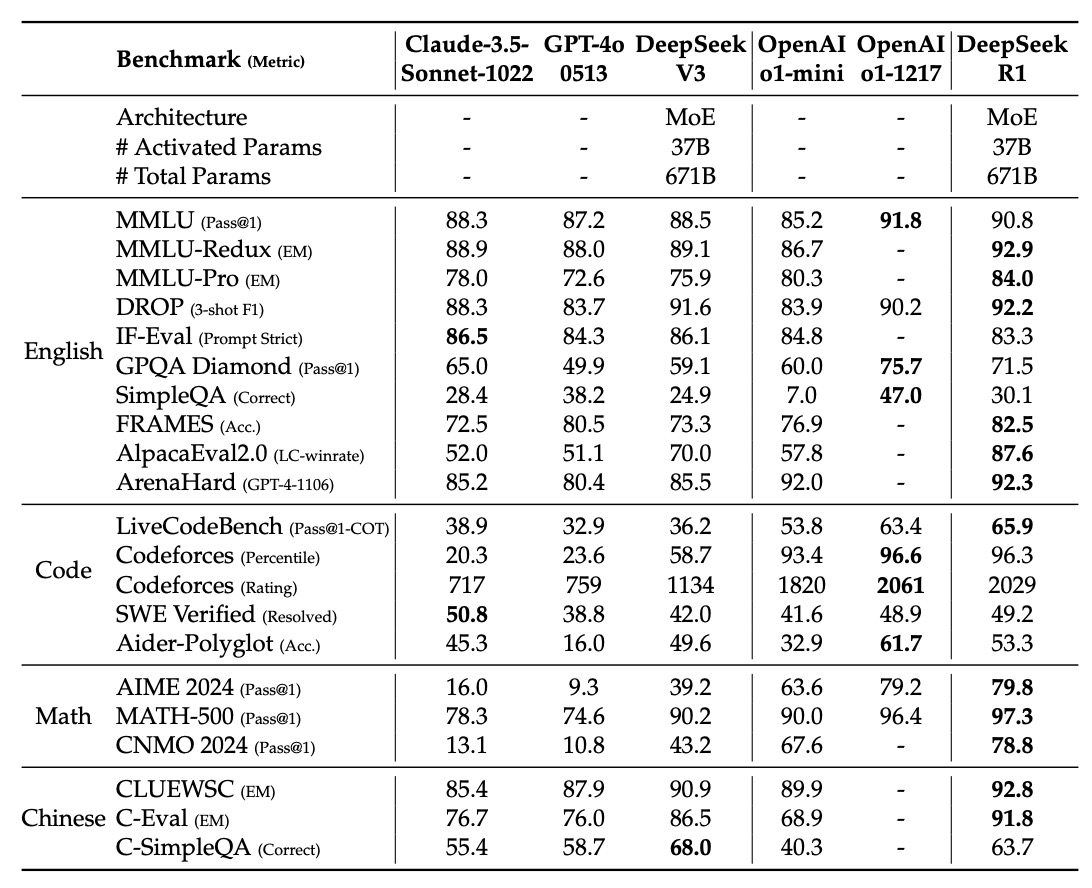\n\n\n\n上表是 DeepSeek-R1 在多项基准测试中的评估结果,根据图表分领域来说明:\n\n- **英文知识与推理任务**\n\n - **MMLU、MMLU-Redux 与 MMLU-Pro**\n 这三个指标主要用于评估模型在学术和通识问答方面的知识水平:\n\n - **MMLU (Pass@1):** 评估单次回答的正确率,DeepSeek-R1 得分 90.8,高于 DeepSeek-V3 的 88.5,但低于 OpenAI-o1-1217 的 91.8。\n - **MMLU-Redux (EM):** 以精确匹配(Exact Match)计分,DeepSeek-R1 得分 92.9,高于表中的 DeepSeek-V3 89.1;OpenAI-o1-1217 在此栏未列数值。\n - **MMLU-Pro (EM):** 专注于更具挑战性的多学科问题,DeepSeek-R1 得分 84.0,高于 DeepSeek-V3 的 75.9;作者将知识测试的提升主要归因于大规模 RL 对 STEM 题目准确率的改善。\n\n - **DROP (3-shot F1) 与 IF-Eval (Prompt Strict)**\n\n - **DROP**:测试模型在阅读理解与数值推理上的能力,DeepSeek-R1 在该项目中达到 92.2 的 F1 分数。\n - **IF-Eval**:评估模型对指令格式要求的遵从性,DeepSeek-R1 为 83.3,低于表中的 DeepSeek-V3 86.1 与 GPT-4o 84.3。\n\n - **GPQA Diamond 与 SimpleQA**\n\n - **GPQA Diamond (Pass@1):** 用来评估模型在专家级知识问答上的表现,DeepSeek-R1 得分 71.5,高于 DeepSeek-V3 的 59.1,低于 OpenAI-o1-1217 的 75.7。\n - **SimpleQA (Correct):** 测试模型在事实性问答上的正确率,DeepSeek-R1 为 30.1,高于 DeepSeek-V3 的 24.9,但低于 GPT-4o 的 38.2 与 OpenAI-o1-1217 的 47.0。中文 C-SimpleQA 是另一项测试,须分开看。\n\n - **FRAMES、AlpacaEval2.0 与 ArenaHard**\n 这些指标主要考察模型对长文本、开放领域问答及写作任务的能力:\n - **FRAMES (Acc.):** DeepSeek-R1 得分 82.5,高于表中的 DeepSeek-V3 73.3 与 GPT-4o 80.5;这是长上下文问答测试的结果。\n - **AlpacaEval2.0 (LC-winrate)** 与 **ArenaHard (GPT-4-1106):** 都以模型评审比较开放式回答,前者回报长度控制后胜率。DeepSeek-R1 分别取得 87.6% 与 92.3%,高于 DeepSeek-V3 的 70.0% 与 85.5%。\n\n---\n\n- **代码生成任务**\n\n - **LiveCodeBench (Pass@1-COT) 与 Codeforces**\n 这部分评估模型在代码生成与算法推理上的表现:\n\n - **LiveCodeBench:** DeepSeek-R1 得分 65.9,代表它在利用连锁思考(Chain-of-Thought)来生成代码时的优秀表现。\n - **Codeforces (Percentile 与 Rating):** DeepSeek-R1 的 Percentile 为 96.3、Rating 为 2029,接近 OpenAI-o1-1217 的 96.6 与 2061;这项结果使用论文选定的 10 场 Div.2 题目及测试案例换算。\n\n - **其他工程相关指标**\n - **SWE Verified (Resolved):** 与工程任务相关,DeepSeek-R1 得分 49.2,接近 OpenAI-o1-1217 的 48.9,低于 Claude-3.5-Sonnet 的 50.8。\n - **Aider-Polyglot (Acc.):** 评估多语言程式编辑任务,DeepSeek-R1 得分 53.3,低于 OpenAI-o1-1217 的 61.7。\n\n---\n\n- **数学任务**\n\n - **AIME 2024、MATH-500 与 CNMO 2024**\n 这些基准专注于数学推理与问题解答:\n - **AIME 2024 (Pass@1):** DeepSeek-R1 的表现达到 79.8,与 OpenAI-o1-1217 相当,表明其在数学竞赛题目上的推理能力非常强。\n - **MATH-500 (Pass@1):** DeepSeek-R1 得分 97.3,接近 OpenAI-o1-1217 的 96.4,高于 DeepSeek-V3 的 90.2。\n - **CNMO 2024 (Pass@1):** DeepSeek-R1 得分 78.8,高于 DeepSeek-V3 的 43.2;OpenAI-o1-1217 在此栏未列数值。\n\n---\n\n- **中文任务**\n\n - **CLUEWSC、C-Eval 与 C-SimpleQA**\n 在中文任务上,DeepSeek-R1 也展现出不俗的能力:\n - **CLUEWSC (EM):** DeepSeek-R1 得分 92.8,表明其在中文语境中的理解与推理能力很强。\n - **C-Eval (EM):** 得分 91.8,再次印证其在中文语言评测中的竞争力。\n - **C-SimpleQA (Correct):** DeepSeek-R1 得分 63.7,低于 DeepSeek-V3 的 68.0。作者认为安全 RL 后部分问题被拒答是主要原因,并称取消该阶段后可超过 70%;表格没有列出此消融数值。\n\n---\n\nDeepSeek-R1 在 MMLU、MMLU-Pro 与 GPQA Diamond 等教育导向的知识评测上高于 DeepSeek-V3;作者认为 STEM 题目的改善与大规模 RL 有关,但 R1 也经过冷启动与后续监督微调,这张表无法单独量出 RL 的贡献。\n\nFRAMES 对应长上下文问答,AlpacaEval2.0 与 ArenaHard 则是开放式回答的模型评审。这些结果显示 DeepSeek-R1 在各自的测试设置下高于 DeepSeek-V3;作者认为后期训练的指令跟随数据有帮助,但表格不能分离各训练阶段的效果。\n\nDeepSeek-R1 在 AIME 2024、MATH-500 与 OpenAI-o1-1217 接近,LiveCodeBench 略高;Codeforces 的 96.3 百分位与 2029 Rating 略低于对方。但在工程应用类代码任务(如 Aider)上,仍有提升空间;作者提出增加相关 RL 数据作为后续方向。\n\n作者只将最终摘要送入模型评审;其平均长度在 ArenaHard 为 689 tokens、AlpacaEval2.0 为 2,218 字符。AlpacaEval2.0 报告的是长度控制后胜率。\n\n整体来看,DeepSeek-R1 经过大规模强化学习和多阶段训练,在知识问答、数学推理、代码生成及中文测试中多项指标高于 DeepSeek-V3。R1-Zero 的训练曲线提供了直接从基础模型进行 RL 的证据;R1 的跨任务结果则属整套训练流程,不能只归功于 RL。\n\n### 蒸馏和强化学习的比较\n\n\n\n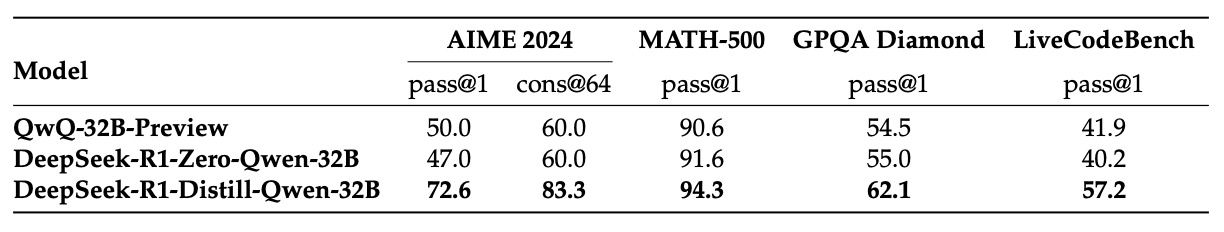\n\n\n\n这里有个议题,假设两个情境:\n\n1. 将大型模型的推理模式蒸馏到小型模型中。\n2. 在小型模型上直接进行大规模 RL。\n\n检视同样的小型模型,实验结果显示如上表,其中对 Qwen-32B-Base 模型进行超过 10K 步的 RL 训练,得到 DeepSeek-R1-Zero-Qwen-32B。另外一个是从 DeepSeek-R1 蒸馏而得的 DeepSeek-R1-Distill-Qwen-32B。\n\n在表列五项指标中,蒸馏版本都高于这个直接 RL 版本,例如 AIME pass@1 为 72.6 对 47.0,LiveCodeBench 为 57.2 对 40.2。\n\n这里作者得出两个结论:\n\n1. **蒸馏效果卓越**:在这组 Qwen-32B 对照中,蒸馏版本的五项指标都高于直接 RL 版本。作者认为蒸馏较省资源;这张表没有列出两者的实际算力或成本。\n2. **RL 的限制**:对这个小模型直接进行超过 10K 步 RL,仍未达到蒸馏版本的表现。作者据此提出更强基础模型及大规模 RL 的研究方向。\n\n### 失败的尝试\n\n在发展 DeepSeek-R1 的早期阶段,研究团队也尝试了其他方法,但最终未能达到预期效果。\n\n这部分主要涵盖两种方法:\n\n- **过程奖励模型 (Process Reward Model, PRM)**: PRM 理论上可引导模型在解决推理问题时采取更好的策略,但在实际应用中面临以下三大挑战:\n\n - **细粒度步骤定义困难**:在一般推理任务中,如何明确定义每一细小步骤极具挑战性。\n - **中间步骤正确性判断**:自动化标注容易达不到理想效果,而人工标注又难以扩展。\n - **奖励黑客问题**:引入基于模型的 PRM 可能导致奖励黑客,且重新训练奖励模型需要额外资源并增加整个训练流程的复杂度。\n\n 尽管 PRM 在重新排序顶部 N 个输出或辅助导引搜索上有一定效用,但其计算开销与应用难度使得其优势受限。\n\n- **蒙地卡罗树搜索 (Monte Carlo Tree Search, MCTS)**\n\n 受 AlphaGo 与 AlphaZero 的启发,研究团队尝试利用 MCTS 来改善测试时的计算规模与探索能力。方法是将答案拆分成更小的部分,并提示模型生成对应每个推理步骤的标签,再利用预训练的价值模型进行引导。然而,此方法面临两大挑战:\n\n - **搜索空间巨大**:相较于棋类游戏,Token 生成的搜索空间呈指数增长,即使设置节点延伸上限,模型也容易陷入局部最优解。\n - **价值模型训练困难**:价值模型对每一步搜索的质量有决定性影响,但训练一个精细的价值模型本身就非常困难,进而影响整个搜索过程的迭代改进。\n\n 因此,这套 MCTS 方法虽以提升推理阶段的搜索效果为目标,作者的实验尚未得到预期成效;通过自我搜索持续改进模型仍是一大挑战。\n\n## 结论\n\nDeepSeek-R1 结合了冷启动数据与反复迭代的强化学习微调,使其最终在多项任务中的表现与 OpenAI-o1-1217 相当,充分体现了大规模强化学习在推理能力提升方面的潜力。\n\n目前 DeepSeek-R1 在测试中仍存在一些已知的缺点,作者也在论文最后一段明确指出:\n\n- **通用能力**:R1 在部分任务上(如函数调用、多轮对话、复杂角色扮演与 JSON 输出)仍略逊于 V3。\n- **语言混用问题**:R1 主要针对中英文进行优化,当遇到其他语言查询时,可能出现语言混用的情况。\n- **提示工程**:R1 对提示较为敏感,尤其是在 few-shot 提示下表现易受影响。作者建议在零样本设置(zero-shot)下,直接描述问题并明确指定输出格式,以取得最佳效果。\n- **软件工程任务**:由于此类任务的评估时间较长,进而影响 RL 训练的效率,R1 在此领域尚未显示出明显优势。\n\n整体而言,虽然开源模型与闭源模型仍存在差距,但 DeepSeek-R1 的进展已大幅拉近彼此的距离,为未来开源模型的发展开启更多可能。\n\n或许,下一个突破,不会再只属于某个实验室或公司,而是来自整个开源社群的集体努力。\n","imageSizes":{"/content/papers/assets/8de8652dcc4c29be2ec5e7db21a005a69112f52a853487f62e2b7eb925ada903.jpg":{"width":1204,"height":216},"/content/papers/assets/23ea9f9efbc020b384d34bb3fd93bd5866d4c4b7f8bae097a29c5bb658c79d5b.jpg":{"width":932,"height":616},"/content/papers/assets/d5f27d452123780563f47d9e09a273297bddc1427e40c4a546fab93519622591.jpg":{"width":932,"height":588},"/content/papers/assets/5669a19492d0f691238970e4853df7d9ee922e838cbdbcabcca9c2f1f19f502c.jpg":{"width":1112,"height":640},"/content/papers/assets/ed26c16b747778d88d5550b4cf5d7fcf2c9921c913397dee295819865cac5a2e.jpg":{"width":1224,"height":728},"/content/papers/assets/7b4883662a865eb56469431c2b1084a13e7854e70dd2bca19722c8bcfff8e43d.jpg":{"width":1092,"height":888},"/content/papers/assets/43a7cbd173de4f4f721662b57f21788f2e1fe54d728f56b80df59f4590e4a7fb.jpg":{"width":1224,"height":232}}}